Pydantic AI по частям: типизированный цикл агента, восемь видов повторов и capabilities в V2
Архитектурный разбор Pydantic AI 2.66: типизированный Agent, зависимости и RunContext, инструменты и тулсеты, типизированный ответ, граф прогона и его лимиты, восемь слоёв повторов, которые перемножаются, подтверждения и движки долговечного исполнения, capabilities и Harness, уровни мультиагентности, оценки, переход с V1 на V2 и подключение GigaChat и YandexGPT.
Pydantic AI — типизированный цикл агента для Python. Вы объявляете, что агенту нужно и что он обязан вернуть, а библиотека заставляет ваш код, проверку типов и модель работать с этими типами. В нашем рейтинге десяти агентных фреймворков по реальным внедрениям он на пятом месте: в опросе Stack Overflow 2026 им за последний год пользовались 8,9% пользователей агентных фреймворков (390 из 4400). Один обычный вызов может превратиться в 18 запросов по сети, а на Temporal у худшего случая нет потолка: этому разбор уделяет больше всего места. Ниже библиотека разобрана по частям, от класса Agent до слоёв повторов, а в конце — когда её брать. Всё сверено с документацией в репозитории pydantic/pydantic-ai и пакетом pydantic-ai 2.66.0 от 4 ноября 2026 года.
Коротко
- Агент — это
Agent[Deps, Output]: контейнер для строки модели, инструкций, инструментов, типа зависимостей и типа ответа. Прогон либо возвращает этот тип, либо завершается ошибкой. - Ваши сервисы (пулы БД, HTTP-клиенты, ключи) идут рядом с промптом через
RunContextи в сам промпт не попадают. Сигнатура и docstring инструмента становятся его схемой, аргументы проверяются до запуска вашего кода. - Внутри прогон — маленький граф: промпт, запрос к модели, вызовы инструментов, конец. По умолчанию прогон делает до 50 запросов к модели, потом выбрасывает исключение.
- Слово «повтор» в Pydantic AI означает восемь разных вещей на восьми слоях без общего бюджета. В примере из документации один логический вызов становится 18 запросами.
- V2 (июнь 2026) сделала capabilities базовым строительным блоком. Память, субагенты, ограничители и целый агент для кода лежат в отдельном пакете Harness, где больше 80 capabilities.
- Готовых провайдеров для GigaChat и YandexGPT нет: их подключают через OpenAI-совместимые API или пакет ai-forever. Телеметрия — обычный OpenTelemetry, Logfire не обязателен.
01 · Что такое Pydantic AI и откуда он взялся
Проект описывает себя так: «the Python AI SDK: a typed, extensible agent loop with every model a string swap away, and another one to fall back to when a provider fails». Его делает команда Pydantic, поэтому типы здесь — контракт, по которому работает код.
Главное обещание умещается в одно предложение README: сигнатура и docstring инструмента становятся его схемой, «arguments are validated before your code runs, and the run is guaranteed to return a Sentiment [тип ответа в примере из README], so your IDE, type checker, and the LLM all agree on the returned type».
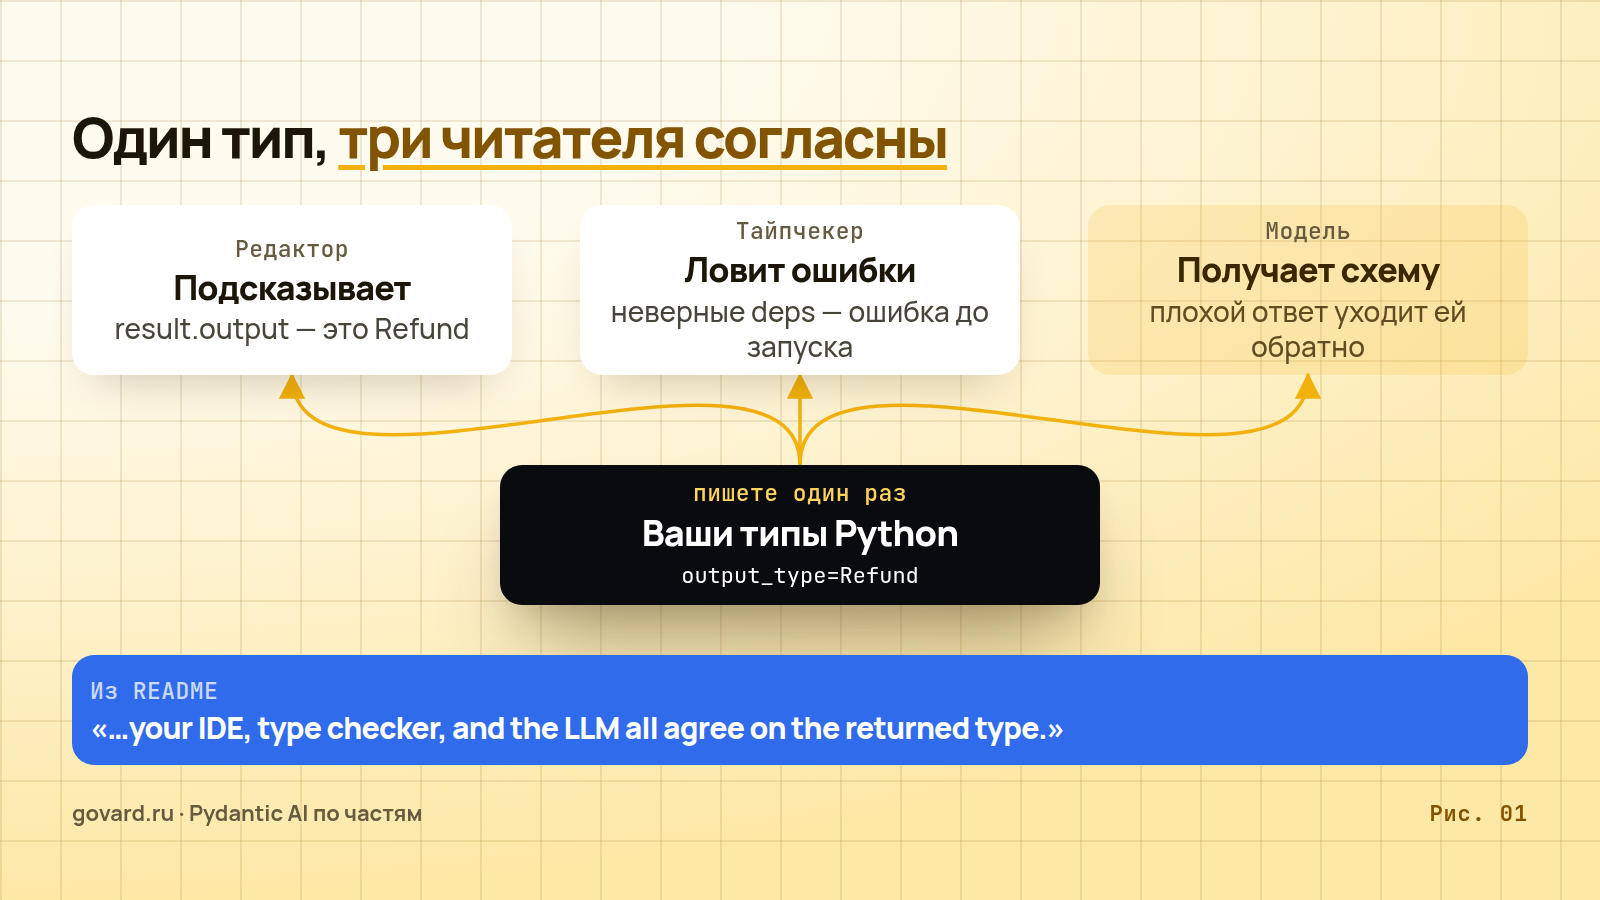
Источник: README Pydantic AI, ноябрь 2026.
От истории версий зависит, насколько можно доверять API, на котором вы пишете сегодня.
| Дата | Релиз | Что это значило |
|---|---|---|
| сентябрь 2025 | V1.0 | «no changes that break your code until V2» |
| 20 мая 2026 | бета V2 | ответвлена от v1.100.0 |
| 23 июня 2026 | V2.0 | «a harness-first design with capabilities as a core primitive» |
| 4 ноября 2026 | 2.66.0 | релизы раз в один–три дня; V1 по-прежнему получает исправления 1.107.x |
V2 вышла через девять с половиной месяцев после обещания V1. Слово проект сдержал: несовместимые изменения пришли с мажорной версией. Политика версий фиксирует три обязательства. В минорных релизах намеренно ничего не ломают. V3 выйдет не раньше чем через три месяца после V2.0. V1 получает исправления безопасности не меньше шести месяцев после стабильной V2. V3 может выйти в любой момент: политика исключала такой выпуск только до 23 сентября 2026 года. Минорные релизы выходят почти каждый день: 2.62.0 — 27 октября, 2.66.0 — 4 ноября.
pydantic-graph и pydantic-evals идут в ногу и тоже на 2.66.0, pydantic-ai-harness — на 0.66.0. Нужен Python 3.11 или новее.
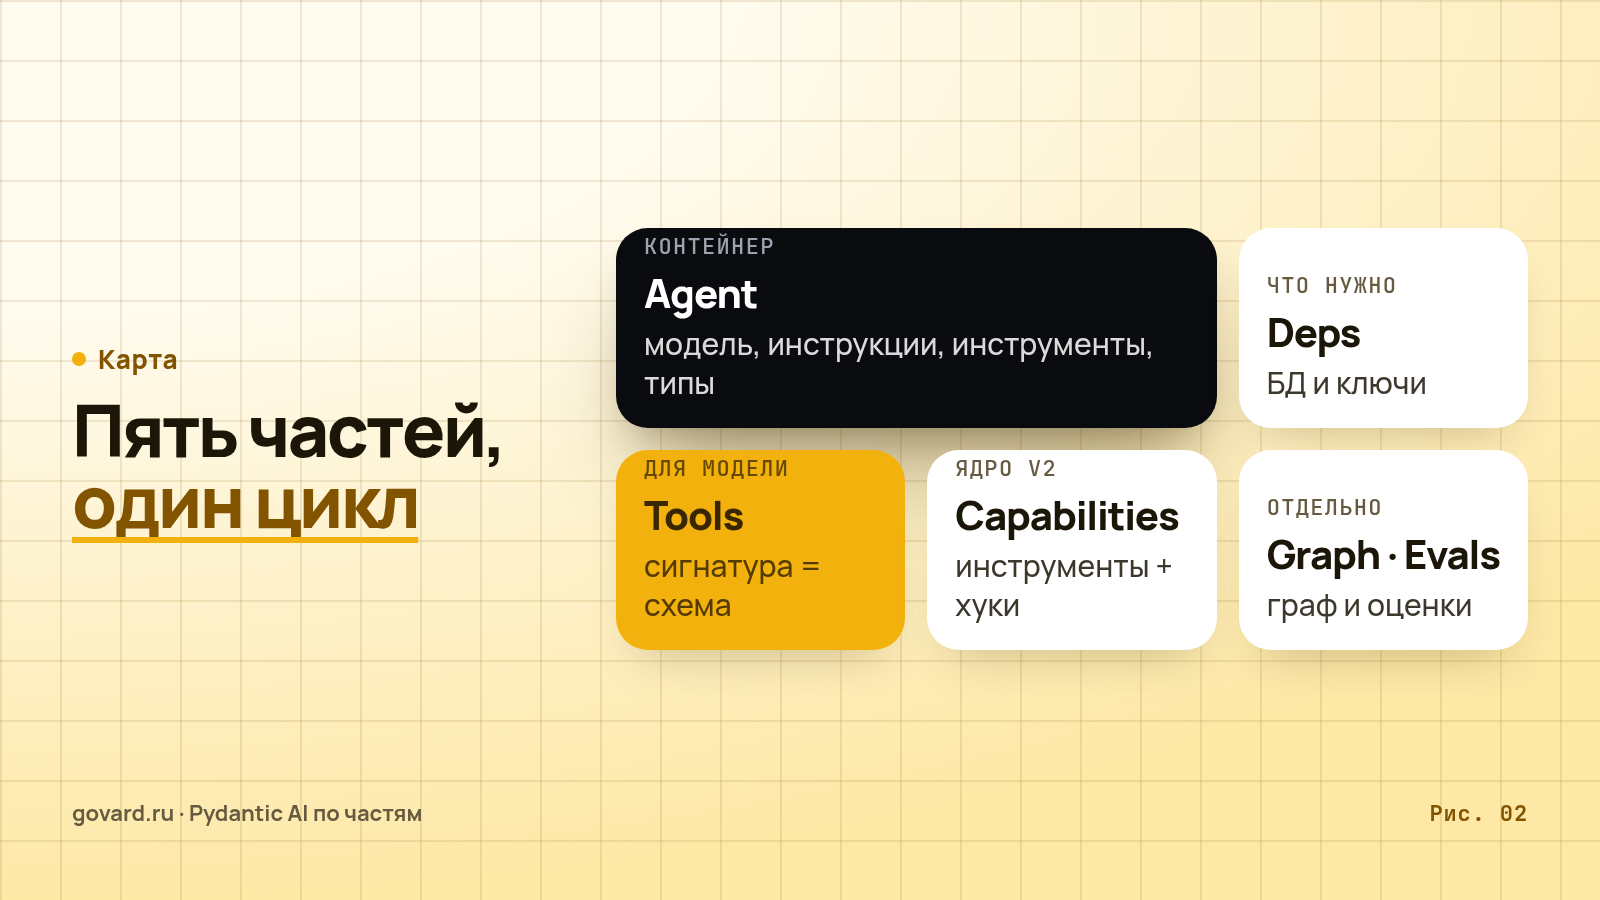
Карта. В любом реальном проекте вы встретите пять частей Pydantic AI:
- Agent. Контейнер. Документация перечисляет, что в нём лежит: инструкции, функции-инструменты и тулсеты, тип структурированного ответа, ограничение на тип зависимостей, модель, настройки модели и capabilities.
- Зависимости. Ваши сервисы, которые передаются на каждый прогон и доступны через
RunContext. - Инструменты. Python-функции, которые может вызвать модель. Их сигнатура и docstring — схема, которую видит модель.
- Capabilities. Строительный блок V2: переиспользуемый модуль поведения агента, который собирает вместе инструменты, хуки, инструкции и настройки модели.
- Граф и оценки. Две отдельные библиотеки.
pydantic-graph— типизированная машина состояний, которая не зависит отpydantic-ai.pydantic-evalsоценивает и ответы агента, и цепочку вызовов инструментов, по которой он к ним пришёл.
Наблюдаемость, адаптеры для интерфейса (AG-UI и протокол потока данных Vercel AI) и движки долговечного исполнения подождут.
Источник: документация Pydantic AI, ноябрь 2026.
02 · Агент: контейнер с двумя параметрами типа
Документация говорит прямо: «agents are generic in their dependency and output types». Агент, которому нужен клиент Shop и который возвращает Refund, — это Agent[Shop, Refund], и проверка типов это знает. Самый маленький полный пример из документации, слегка сокращённый:
roulette_agent = Agent(
    'openai:gpt-5',
    deps_type=int,
    output_type=bool,
    instructions='Use the `roulette_wheel` function to see if the customer has won based on the number they provide.',
)

@roulette_agent.tool
async def roulette_wheel(ctx: RunContext[int], square: int) -> str:
    """check if the square is a winner"""
    return 'winner' if square == ctx.deps else 'loser'
В этих нескольких строках четыре вещи. Модель задана одной строкой. deps_type=int сообщает проверке типов, какие будут зависимости; документация подчёркивает, что передаётся «the type here, NOT an instance» — тип, а само значение приходит с каждым прогоном. output_type=bool значит, что прогон вернёт булево значение или упадёт с ошибкой. @roulette_agent.tool регистрирует функцию, которую может вызвать модель, первым параметром у неё идёт RunContext[int].
Агента создают один раз и используют глобально, «as you would a small FastAPI app». Вместо system_prompt лучше брать instructions: при явной истории сообщений прежние инструкции заново не отправляются, системный промпт же остаётся в истории.
Пять способов запуска.
| Метод | Что вы получаете |
|---|---|
run() | await, результат с полным ответом |
run_sync() | то же самое обычной синхронной функцией, для скриптов |
run_stream() | асинхронный контекстный менеджер, который отдаёт текст или структурированный ответ по мере генерации |
run_stream_events() | асинхронный контекстный менеджер по всем событиям, последним идёт финальный результат |
iter() | асинхронный итератор по узлам графа, на котором работает агент |
Есть ещё run_stream_sync(). run_stream() считает финальным первый ответ, который подходит под тип, а run() и run_stream_events() всегда доводят граф до конца.
Модели задаются строкой. Формат — <provider>:<model>, и агента можно переключить между OpenAI, Anthropic, Gemini, Amazon Bedrock, Google Vertex AI, Azure OpenAI и локальными моделями, поменяв одну строку. В таблице провайдеров в документации на 4 ноября 37 строк (мой подсчёт), от OpenAI и Anthropic до Ollama, vLLM, OpenRouter и Pydantic AI Gateway. V2 сделала префикс обязательным: Agent('gpt-5') теперь выбрасывает UserError, openai: означает более новый Responses API от OpenAI, а openai-chat: — более старый Chat Completions API.
Для устойчивости в V2 есть capability ModelFallback: capabilities=[ModelFallback('anthropic:…')] при определённых ошибках отправляет тот же запрос следующей модели.
03 · Зависимости: ваши сервисы идут рядом с промптом
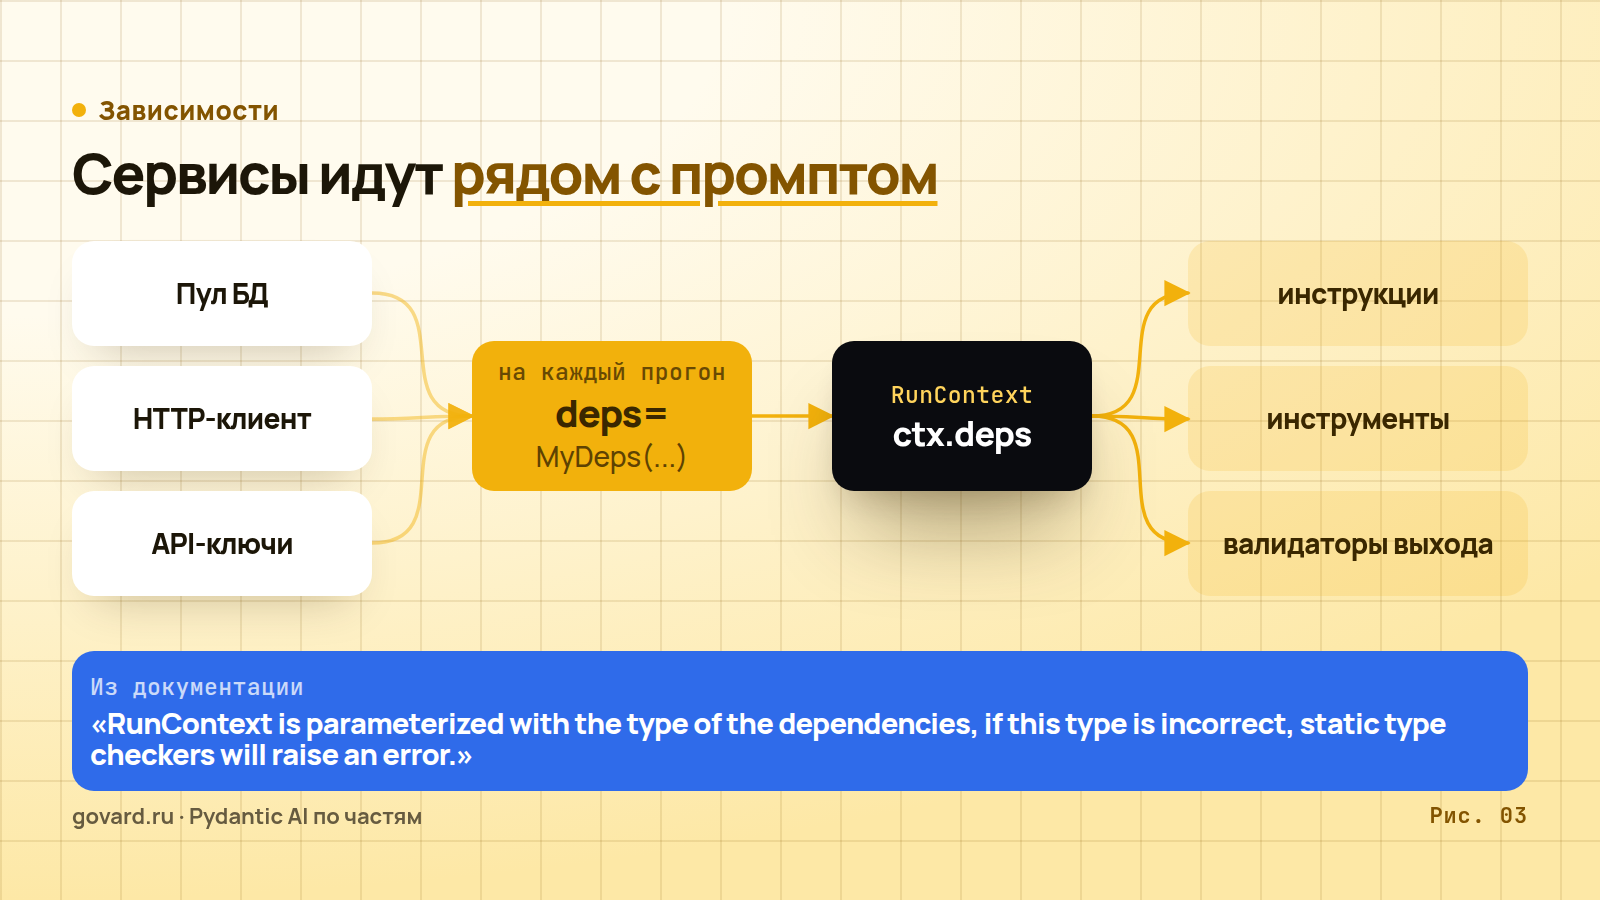
Источник: документация Pydantic AI, раздел dependencies, ноябрь 2026.
Данные и сервисы попадают к инструкциям, инструментам и валидаторам через внедрение зависимостей. Вы описываете dataclass с тем, что нужно агенту, и передаёте экземпляр на каждый прогон:
@dataclass
class MyDeps:
    api_key: str
    http_client: httpx.AsyncClient

agent = Agent('openai:gpt-5', deps_type=MyDeps)
result = await agent.run('Tell me a joke.', deps=MyDeps('foobar', client))
Инструменты, функции инструкций и валидаторы получают его как ctx.deps. Здесь важны два свойства.
Первое — типизация: RunContext параметризован типом зависимостей. Инструмент, который ждёт RunContext[ShopClient], на агенте с другим типом зависимостей будет пойман до запуска.
Второе — секреты и живые соединения не попадают в промпт. Модель видит схемы и результаты инструментов, а пул БД и ключи — только если вы сами впишете их в инструкции. Это прямой ответ на вопрос «как дать агенту доступ к CRM, не вставляя CRM в промпт».
Тестировать так же просто: agent.override(deps=...) подменяет настоящий HTTP-клиент на фальшивый.
04 · Инструменты: сигнатура и есть схема
Большинство случаев закрывают два декоратора. @agent.tool — для инструментов, которым нужен контекст агента, @agent.tool_plain — для тех, кому он не нужен. Игра в кости из документации показывает оба:
@agent.tool_plain
def roll_dice() -> str:
    """Roll a six-sided die and return the result."""
    return str(random.randint(1, 6))

@agent.tool
def get_player_name(ctx: RunContext[str]) -> str:
    return ctx.deps
Docstring здесь работает. Pydantic AI «extracts parameter descriptions from the docstring and adds them to the schema» — берёт описания параметров из docstring в форматах Google, NumPy или Sphinx и кладёт их в схему. С require_parameter_descriptions=True агент сразу падает, если описания нет. По этим описаниям модель решает, когда и как вызывать инструмент.
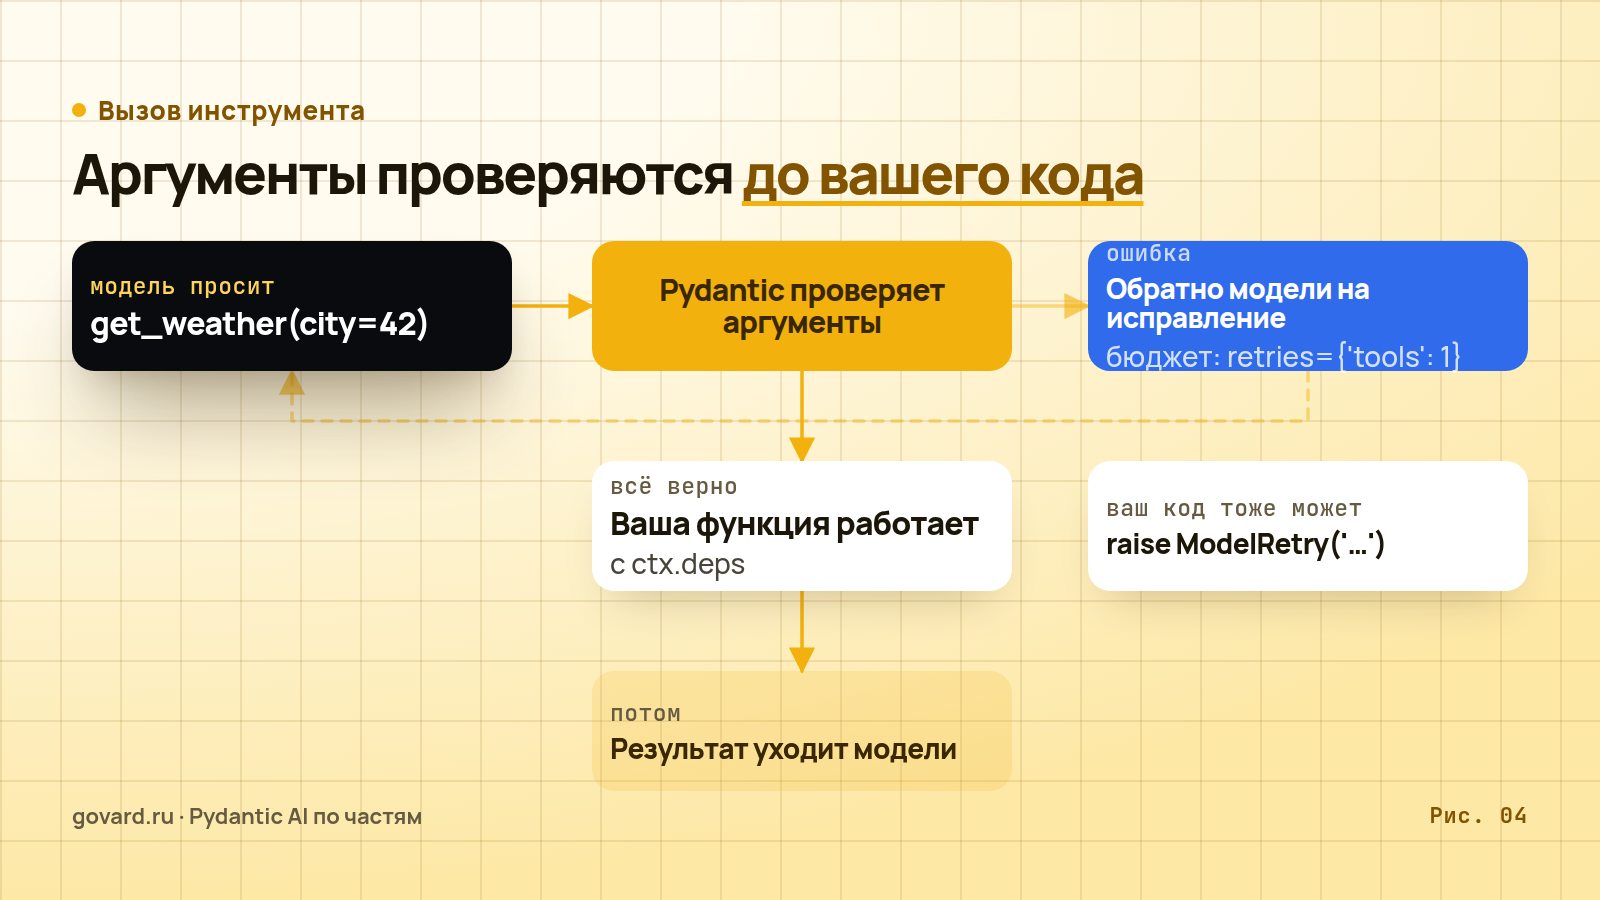
Источник: документация Pydantic AI, разделы tools и retries, ноябрь 2026.
Проверка до выполнения. Если модель просит get_weather(city=42), а в сигнатуре city: str, вызов до вашей функции не доходит. Ошибка проверки возвращается модели на исправление в пределах бюджета повторов инструмента, по умолчанию это один повтор. Ваш код может сделать то же намеренно, выбросив ModelRetry. В V2 такой повтор виден в истории как ToolReturnPart с outcome='retried'.
Динамические инструменты. Функция prepare вызывается на каждом шаге прогона и может скрыть инструмент или изменить его в зависимости от контекста.
Тулсеты. Когда инструментов больше нескольких, их собирают в наборы: FunctionToolset, CombinedToolset и обёртки через .filtered(), .prefixed(), переименование и ApprovalRequiredToolset. Офлайн-лаборатория в моём исследовательском репозитории проверила порядок вложения: prefixed('inner') внутри prefixed('outer') даёт инструменты с именами outer_inner_*.
MCP. V2 свела MCPServerStdio, MCPServerSSE, MCPServerStreamableHTTP и родственные классы в один MCPToolset, транспорт которого определяется по аргументам, и MCPToolset('http://localhost:8000/mcp') в toolsets=[...] — вся настройка. Рекомендуемый путь — capability MCP, которая по умолчанию запускает MCP-сервер локально и с native=True переключается на встроенную поддержку MCP у провайдера. A2A, протокол обмена между агентами, переехал в отдельный пакет fasta2a; Agent.to_a2a() убран.
Native tools. Встроенные инструменты теперь называются native tools: WebSearchTool, CodeExecutionTool, ImageGenerationTool, WebFetchTool, FileSearchTool и другие, в документации их девять. Они выполняются на инфраструктуре провайдера модели. Если провайдер инструмент не поддерживает, Pydantic AI выбросит UserError при запуске агента.
05 · Ответ: типизированный результат или ещё одна попытка
Инструменты — то, что модель может делать по дороге, а тип ответа — то, что она обязана отдать в конце. output_type определяет, что прогон должен вернуть. Подходят скаляры, списки и словари, TypedDict, dataclass и модели Pydantic, объединения типов и функции ответа. Добиться от модели такого ответа можно тремя способами:
- Tool output, по умолчанию. Модель возвращает структурированные данные вызовом специального инструмента ответа; это работает почти со всеми моделями.
- Native output. Модель обязана выдать текст по заданной JSON-схеме, следит за этим провайдер.
- Prompted output. JSON-схема вставляется в инструкции модели. Это вариант для моделей без первых двух.
С объединением вроде output_type=Fruit | Vehicle каждый член регистрируется у модели отдельным инструментом ответа. Если среди типов есть str, ответом считается и обычный текст.
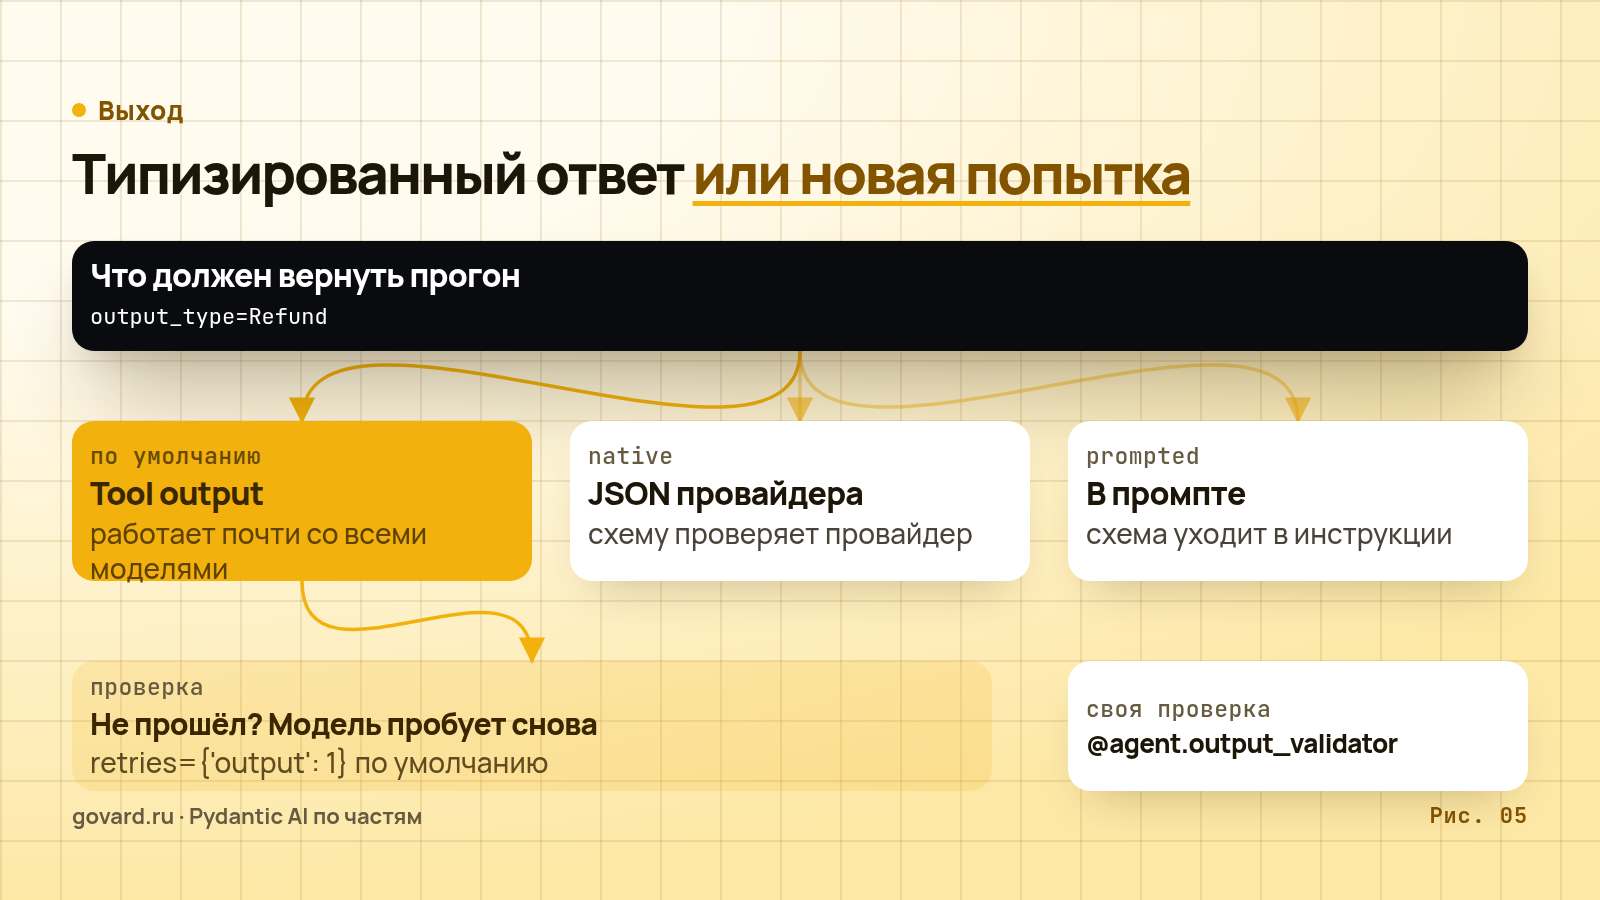
Источник: документация Pydantic AI, раздел output, ноябрь 2026.
Если проверка не прошла, ответ возвращается модели в пределах бюджета повторов ответа (по умолчанию один). Для проверок с вводом-выводом, например есть ли такой заказ в базе, добавьте @agent.output_validator, который может выбросить ModelRetry. Структурированный ответ тоже стримится: result.stream_output() отдаёт частичные объекты по мере того, как модель их пишет. Так показывают профиль, который заполняется поле за полем.
06 · Прогон изнутри
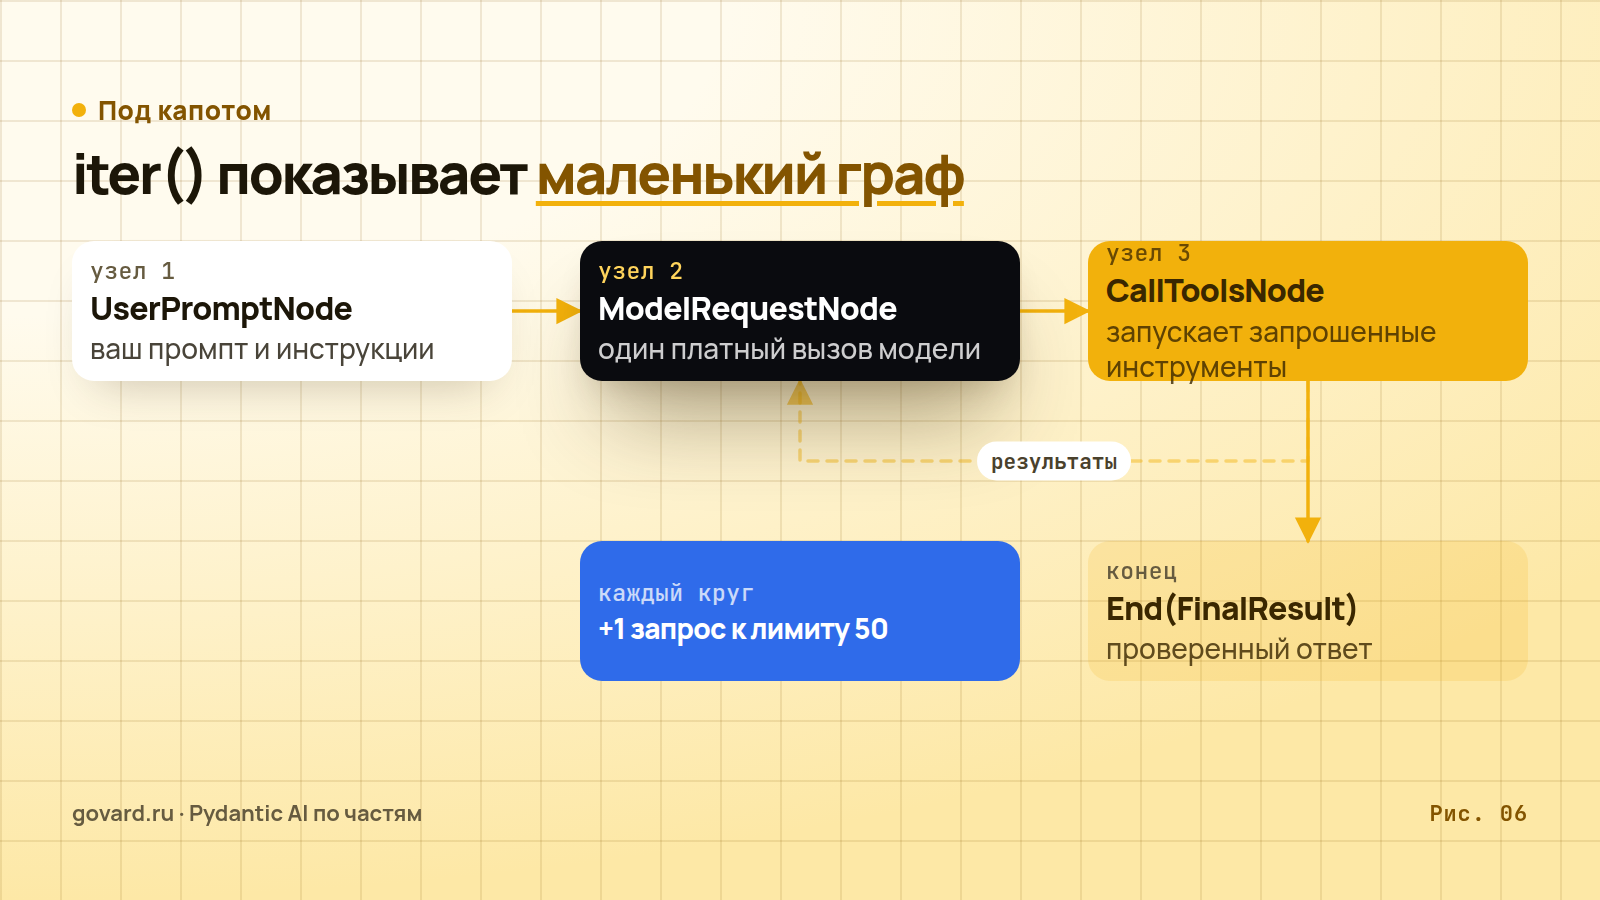
Источник: документация Pydantic AI, раздел agent, пример с iter.
iter() позволяет пройти граф прогона по шагам. Пример из документации печатает узлы: UserPromptNode с вашим промптом и инструкциями, ModelRequestNode — вызов модели, CallToolsNode — выполнение инструментов, которые попросила модель, и в конце End(data=FinalResult(...)). Запрос к модели и вызовы инструментов повторяются по кругу, пока модель не выдаст ответ, прошедший проверку. Через async for node in agent_run каждый шаг можно записать в лог или остановить.
Каждый проход через ModelRequestNode — платный запрос, поэтому лимит по умолчанию важен: без usage_limits действует request_limit = 50. На лимите поведение жёсткое: «A run that reaches its request_limit raises instead of returning output, even when the model has already gathered what it needs». Прогон выбрасывает исключение и не возвращает ответ, даже если модель уже собрала всё нужное.
Поле UsageLimits | По умолчанию |
|---|---|
request_limit | 50 |
tool_calls_limit | выключен; проверяется до запуска инструментов |
input_tokens_limit, output_tokens_limit, total_tokens_limit | выключены |
per_request_input_tokens_limit | выключен; ограничивает вход одного запроса |
cost_limit | выключен; жёсткой гарантией по счёту не служит |
Если параллельные вызовы инструментов превысят tool_calls_limit, не выполнится ни один. Задавайте лимиты под свою нагрузку: 50 ловит только зациклившиеся прогоны.
Для жёсткого лимита в документации есть рецепт: capability сравнивает число сделанных запросов с лимитом, сообщает модели, сколько осталось, и на последнем запросе забирает инструменты, чтобы модели оставалось только выдать ответ. И одна оговорка связывает этот раздел со следующим: request_limit «counts the model responses committed to each run’s history» — считает ответы модели в истории прогона и не видит попыток запасной модели, повторов SDK и транспорта под ними. Лимит 50 означает 50 ответов; запросов по сети может быть больше.
07 · Восемь видов повторов и почему они перемножаются
Страница о повторах открывается предупреждением: «“Retry” means eight different things in an agent run, at eight different layers, and they don’t share budgets». Путаница между ними — обычная причина, по которой прогон повторяет запросы намного чаще или реже, чем ждали.
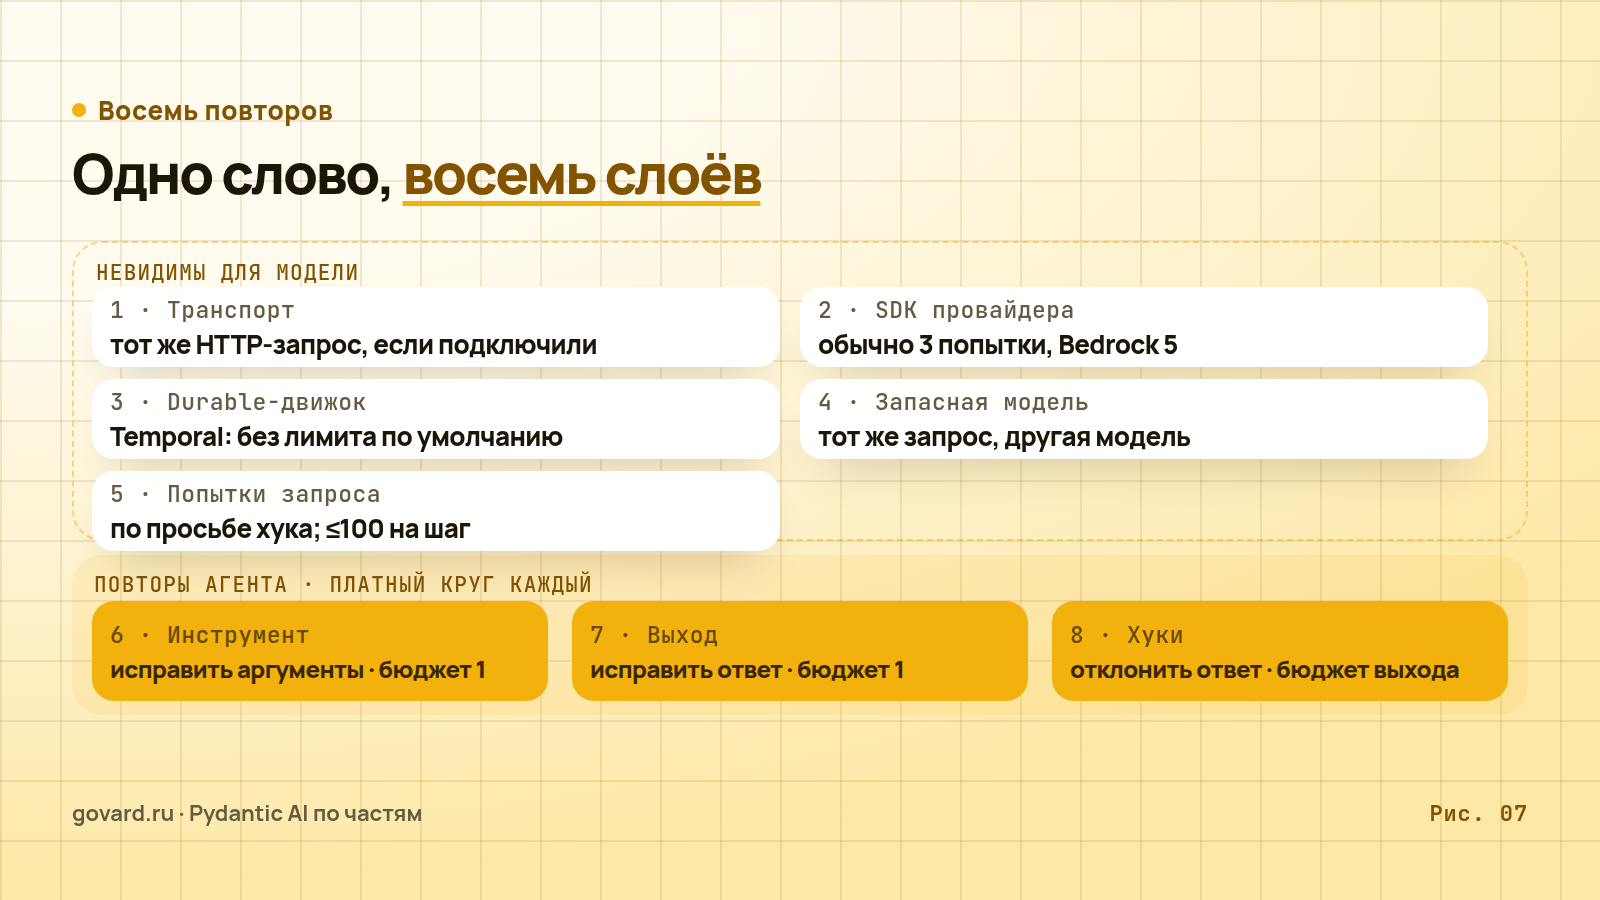
Источник: документация Pydantic AI, раздел retries, ноябрь 2026.
| № | Слой | Что повторяется | По умолчанию |
|---|---|---|---|
| 1 | Транспорт | тот же HTTP-запрос, через транспорт с повторами, который вы добавили | выключен, пока не добавите |
| 2 | SDK провайдера | тот же запрос, силами клиента SDK | у большинства 3 попытки; Google, Mistral, Hugging Face — 1; Bedrock — 5; xAI — до 5 |
| 3 | Движок долговечного исполнения | весь запрос к модели | Temporal: «unbounded by default (maximum_attempts=0)», без ограничения; DBOS и Prefect: без повторов |
| 4 | Запасная модель | тот же запрос другой модели | одна попытка на каждую модель в цепочке |
| 5 | Попытки запроса к модели | шаг, если хук выбросил RetryModelRequest | без бюджета; «at most 100 times» |
| 6 | Инструмент | один вызов инструмента, модель просят исправить | бюджет 1 |
| 7 | Ответ | финальный ответ, модель просят исправить | бюджет 1 |
| 8 | Хуки запроса к модели | запрос, если хук выбросил ModelRetry | делит бюджет с ответом |
Первые пять «invisible to the model»: модель не видит, что попытка сорвалась. Только последние три — повторы агента, и каждый стоит отдельного обращения к модели.
Общего бюджета у слоёв нет, «but they stack» — они складываются друг на друга. Документация разбирает пример с обычными настройками: два повтора ответа, OpenAI SDK со значением по умолчанию max_retries=2, транспорт со stop_after_attempt(2), без запасной модели.
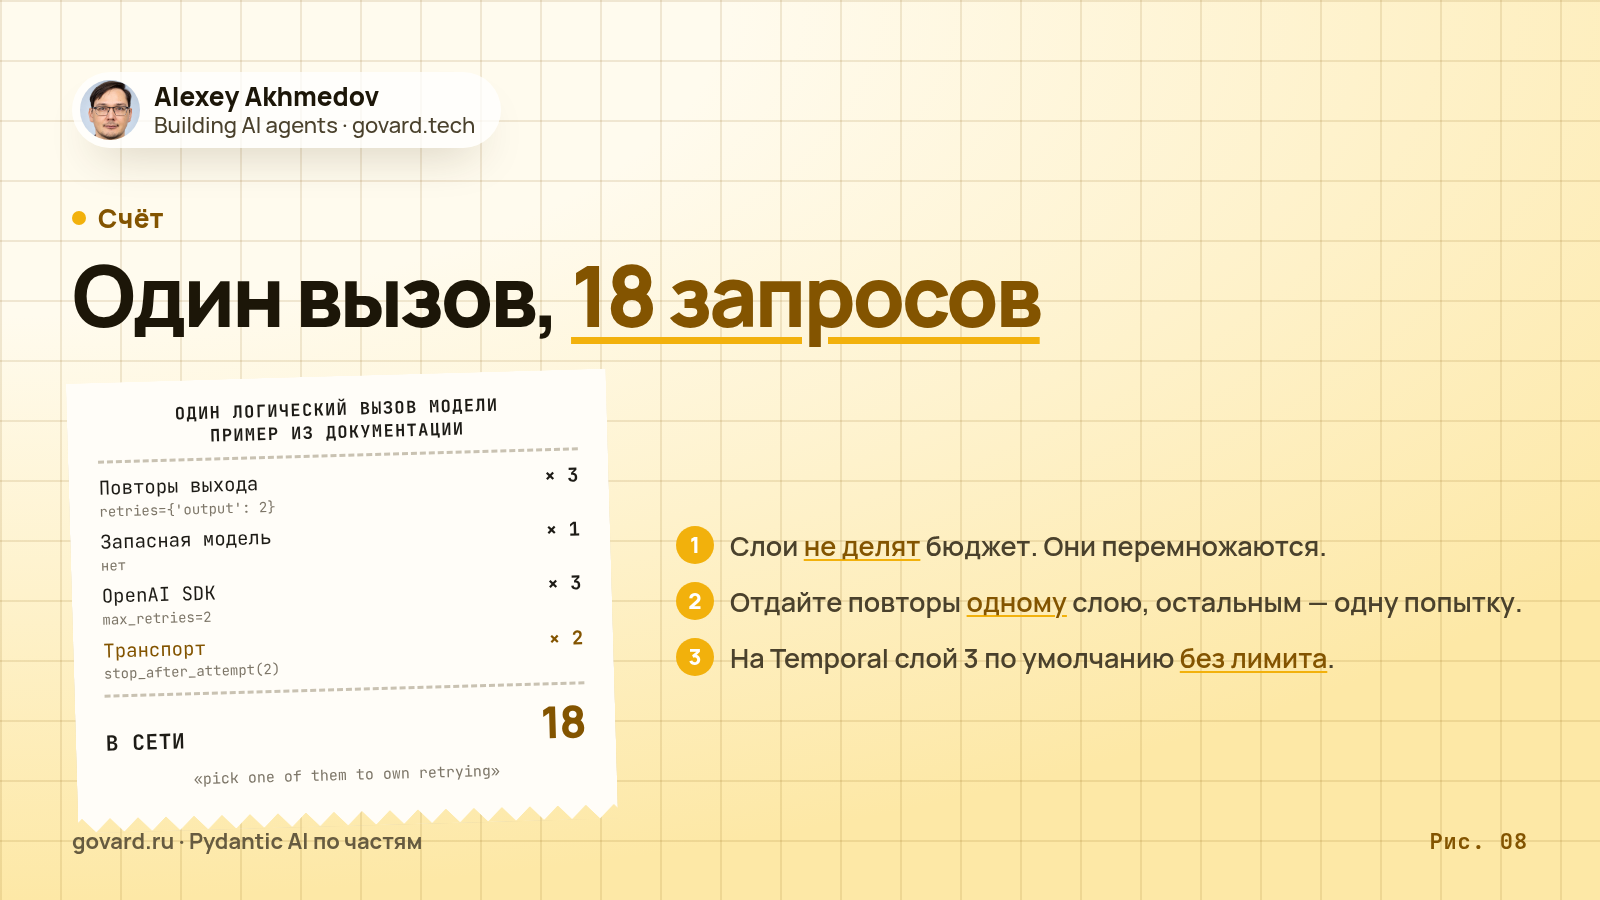
Источник: пример из раздела retries документации Pydantic AI.
3 × 1 × 3 × 2 = 18 запросов по сети на один логический вызов, и вдвое больше с цепочкой запасных из двух моделей. Поставьте того же агента на Temporal с его неограниченными повторами по умолчанию, и у худшего случая не останется верхней границы. Совет документации короткий: назначьте один слой ответственным за повторы, остальным дайте по одной попытке.
Моё мнение: при долговечном исполнении отдайте повторы движку и задайте maximum_attempts сами; повторы SDK провайдера поставьте в ноль или один, бюджеты инструмента и ответа держите на одном. Цена — восстановление медленнее, когда провайдер сбоит несколько секунд: повтор на уровне движка тяжелее быстрой переотправки из SDK. Без движка пусть временные ошибки обрабатывает SDK провайдера, а у остальных слоёв будет одна попытка. В обоих случаях запишите решение, иначе следующий инженер добавит четвёртый слой.
08 · Человек в цикле и прогоны, которые переживают сбой
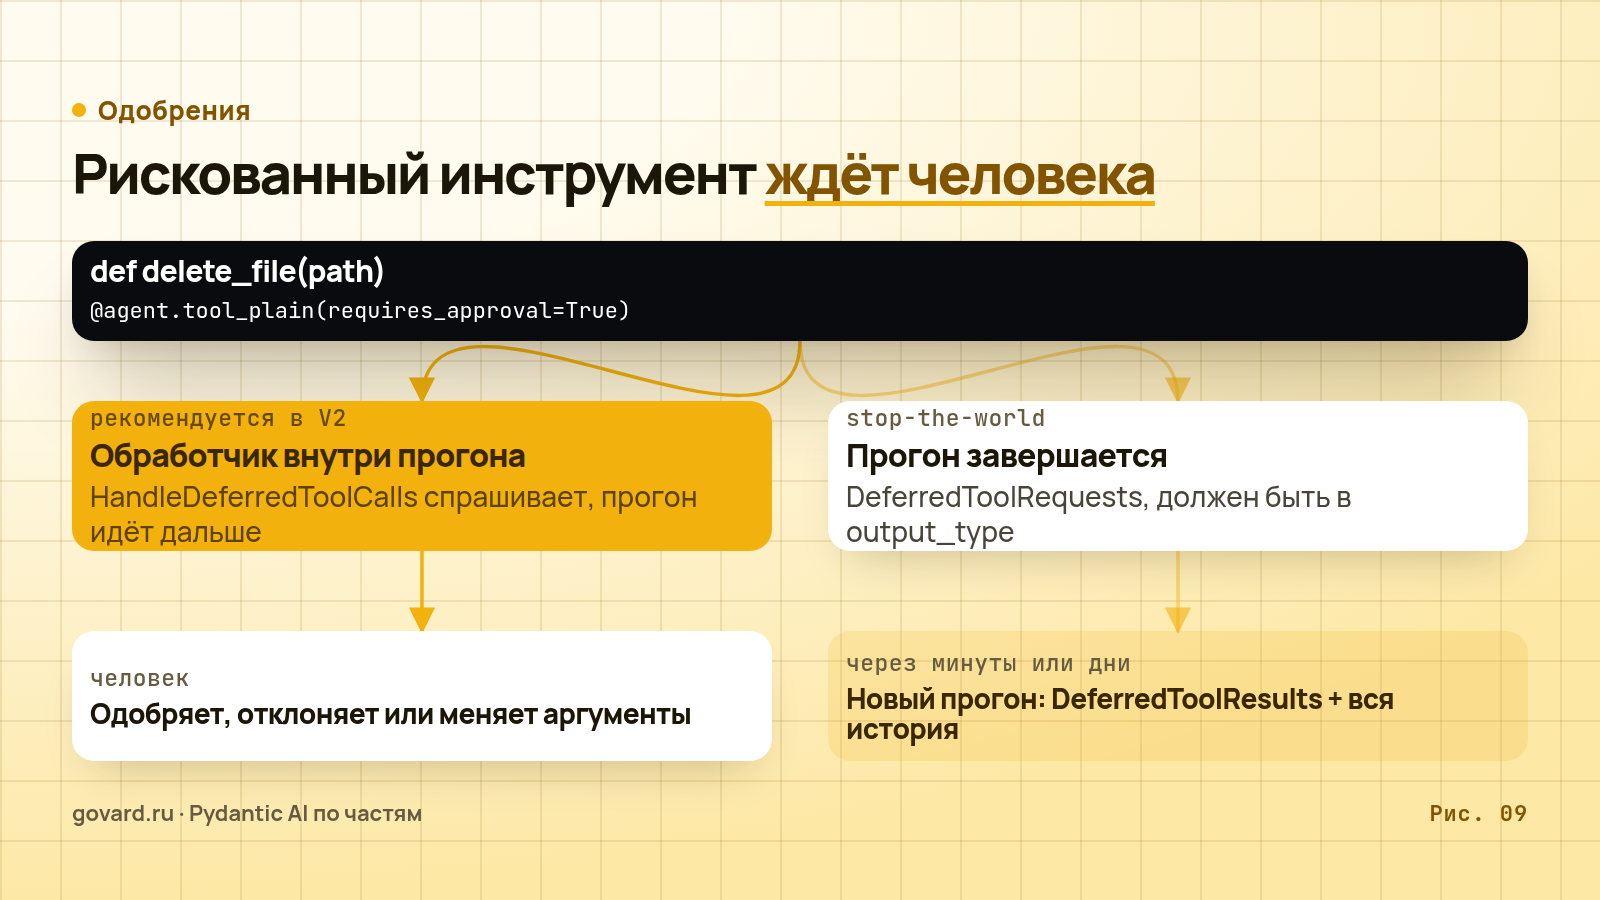
Источник: документация Pydantic AI, раздел deferred tools, ноябрь 2026.
Подтверждения. Пометьте инструмент requires_approval=True или выбрасывайте ApprovalRequired внутри него, если подтверждение нужно только части вызовов:
@agent.tool_plain(requires_approval=True)
def delete_file(path: str) -> str:
    return f'File {path!r} deleted'

@agent.tool
def update_file(ctx: RunContext, path: str, content: str) -> str:
    if path == '.env' and not ctx.tool_call_approved:
        raise ApprovalRequired
    return f'File {path!r} updated: {content!r}'
В V2 паузу обрабатывают двумя способами. Рекомендуемый — обработчик внутри прогона: подключаете capability HandleDeferredToolCalls, спрашиваете человека прямо из прогона и продолжаете. Второй называется «stop-the-world»: прогон завершается ответом DeferredToolRequests со списком ожидающих вызовов, у каждого имя, аргументы и ID. Для этого DeferredToolRequests должен входить в output_type агента. Позже, через минуты или дни, вы запускаете новый прогон с DeferredToolResults, где каждый вызов одобрен, отклонён с сообщением или одобрен с изменёнными аргументами.
Офлайн-лаборатория в моём исследовательском репозитории прогнала путь stop-the-world (ApprovalRequiredToolset) на pydantic-ai 2.33.0 в августе 2026 года с TestModel, без сети и ключей: прошли 17 проверок по capabilities, подтверждениям, хукам и лимитам. Три результата стоит знать. Ни один инструмент под подтверждением не запустился до решения: первый прогон вернул только список ожидающих подтверждений. Решения пережили имитацию сбоя в виде обычного JSON, так что очередь подтверждений может жить в обычной таблице БД. Отказ дошёл до модели обычным результатом инструмента, и прогон завершился штатно. И одна ловушка: если отправить решения новым пользовательским промптом, Pydantic AI выбросит UserError («Cannot provide a new user prompt when the message history contains unprocessed tool calls»). Передавайте их через deferred_tool_results= вместе с полной message_history.
Долговечные прогоны. Что будет с прогоном, если процесс остановится, пока ждёт подтверждения, во время деплоя или сбоя API? Pydantic AI поддерживает девять движков долговечного исполнения: Temporal, DBOS, Prefect, Restate, AWS Lambda, Absurd, pgtask, Azure Durable Task и Apache Airflow, плюс конструктор для любого другого движка. Когда мы публиковали рейтинг 23 октября, их было восемь. Механизм — журнал: движок записывает запросы к модели и вызовы инструментов, а перезапущенный прогон берёт завершённые из журнала и повторяет тот, что был в работе.
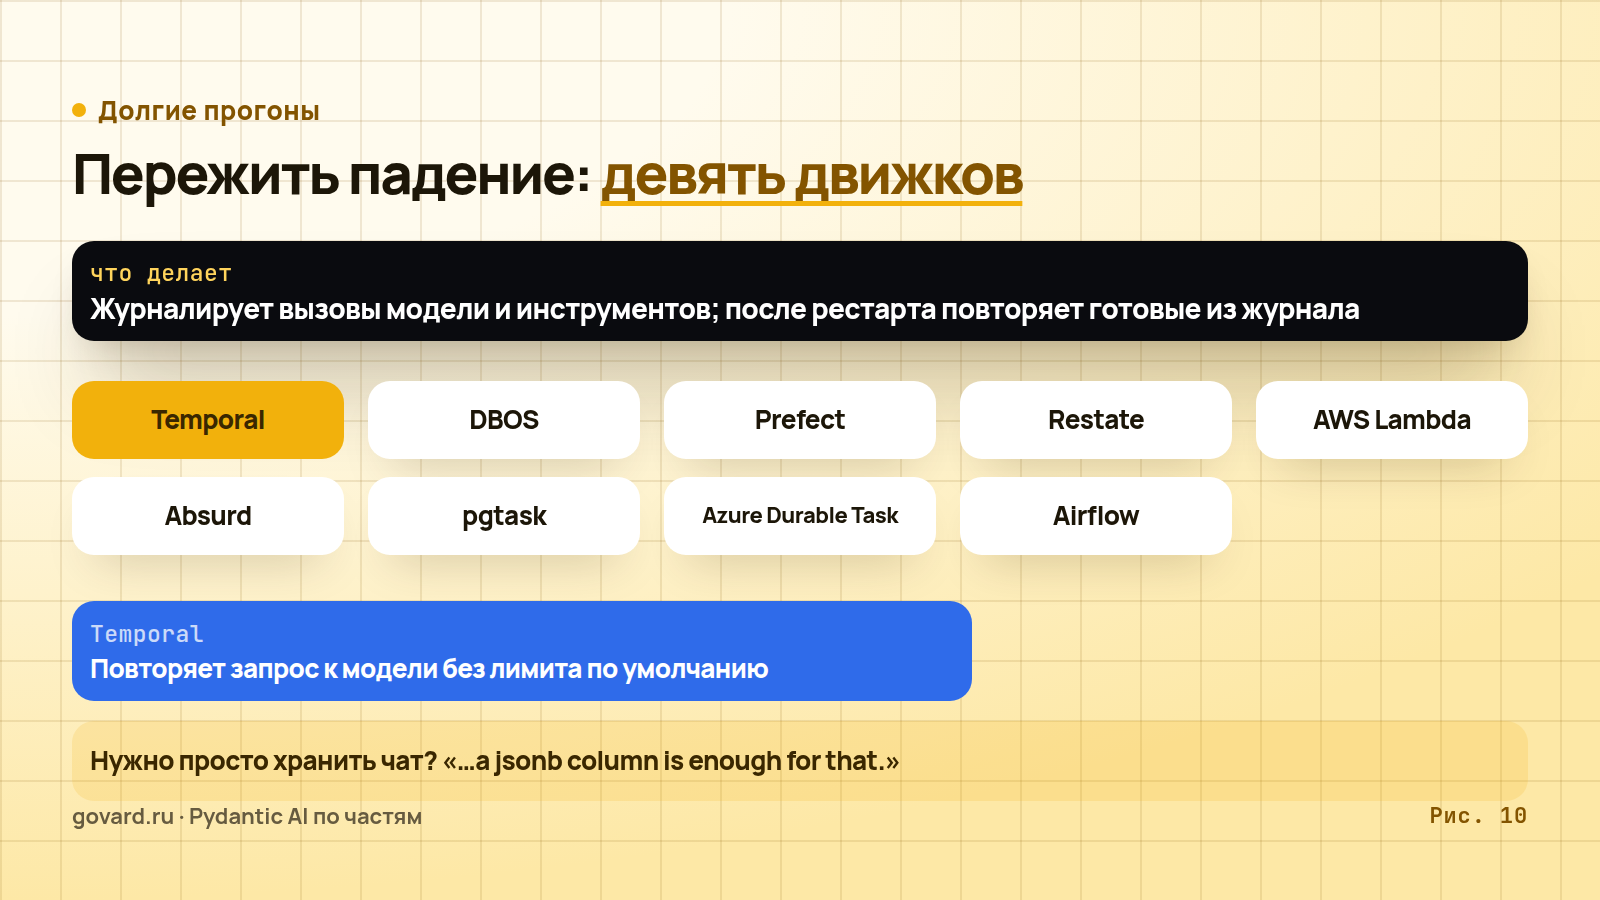
Источник: документация Pydantic AI, раздел durable execution, ноябрь 2026.
Три ограничения из документации. Один движок на агента: подключение второго выбрасывает UserError. В Temporal подключение TemporalDurability «does not by itself make runs durable»: прогон должен идти внутри workflow Temporal, который запускает ваше приложение, зависимости должны сериализоваться, а размер данных Temporal по умолчанию ограничивает 2 МБ.
Хранение и долговечность — разные задачи. Про историю чата документация говорит резко: «a jsonb column is enough for that» — чтобы хранить ветку чата, хватит колонки jsonb, движок для этого брать незачем. Память агента о разговоре «is its message history» — это и есть история сообщений. V2 добавляет объект Conversation (result.conversation на выходе, conversation= обратно на вход) и ConversationStore, который хранит каждое сообщение один раз, ловит конфликтующие сохранения и поддерживает ветвление.
09 · Capabilities и Harness: строительные блоки V2
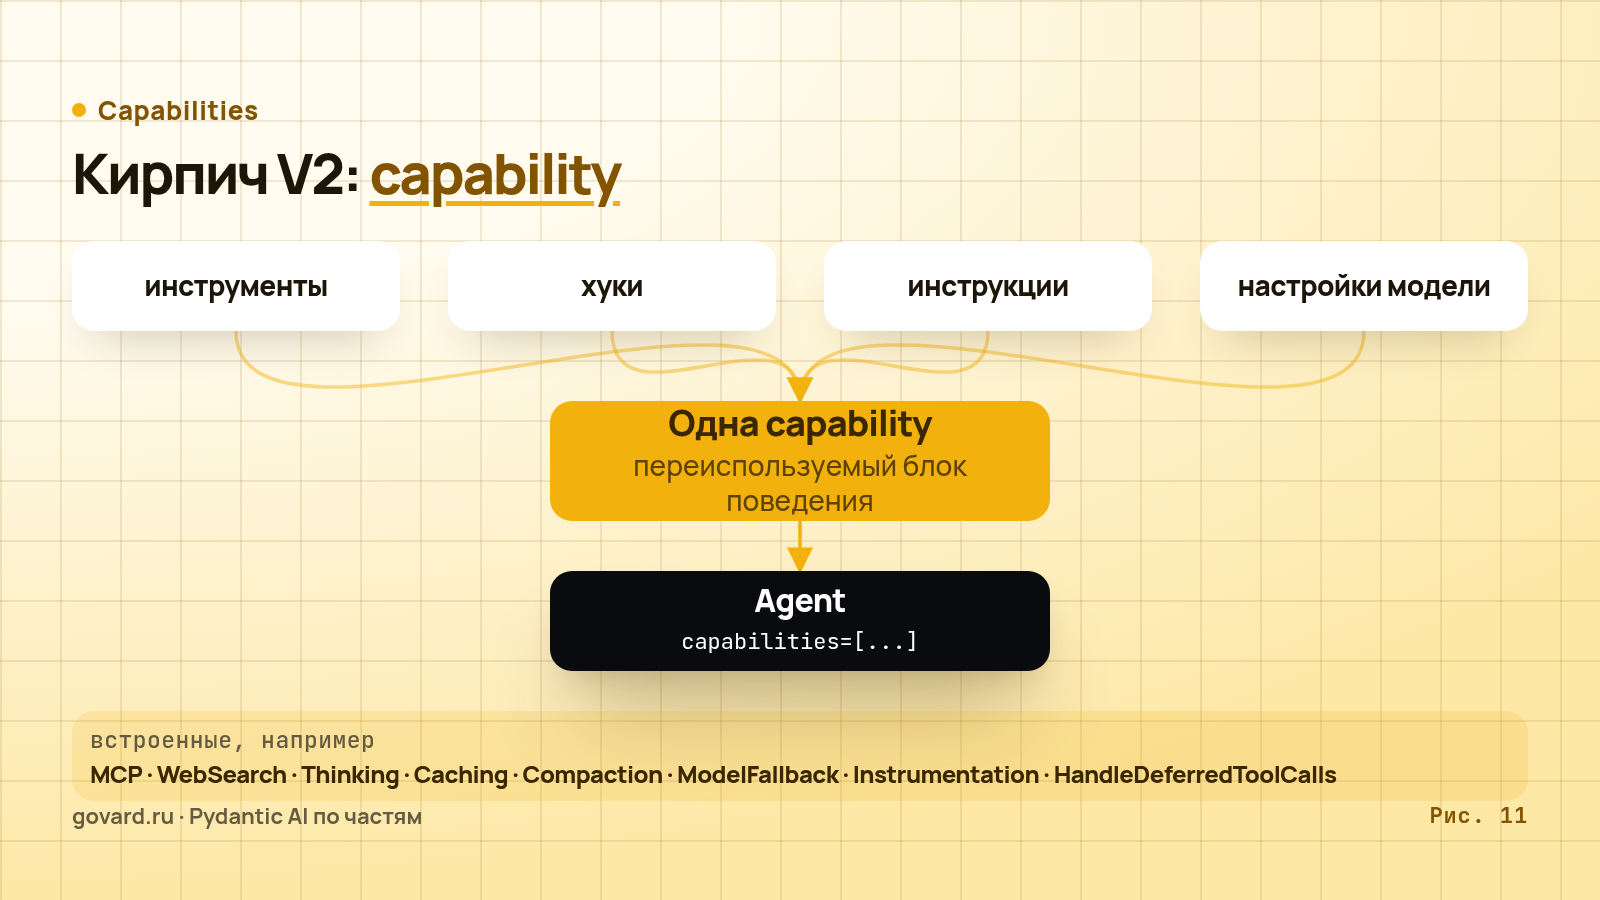
Источник: документация Pydantic AI, раздел capabilities, ноябрь 2026.
Главная идея V2 — capability. Одна capability может добавить инструменты, хуки жизненного цикла, инструкции, настройки модели и даже саму модель. Для памяти, ограничителя, учёта расходов или процесса подтверждений документация советует одну и ту же абстракцию.
Поэтому многие аргументы V1 переехали. instrument= стал capability Instrumentation, history_processors= — ProcessHistory, prepare_tools= — PrepareTools, запасная модель — ModelFallback. Среди базовых capabilities есть MCP, WebSearch, WebFetch, Thinking, Caching (несколько провайдеров, включая Anthropic, ничего не кэшируют, пока запрос не попросит), Compaction, HandleDeferredToolCalls, Hooks и другие.
Хуки дают capability доступ к каждой стадии цикла (до, после, вокруг, при ошибке) для прогонов, узлов, запросов к модели, инструментов и ответа. Учёт расходов читает расход (usage) в хуке after_model_request (в Harness он есть готовым, SpendLimits). Ограничитель может выбросить там же ModelRetry, и, как показал слой 8, это тратит бюджет повторов ответа. Лаборатория нашла ещё одну ловушку: инструменты одного шага выполняются параллельно, поэтому хук-обёртка с общим состоянием должен выдерживать одновременные вызовы.
Harness — официальный отдельный пакет для тяжёлых capabilities, их там больше 80. Несколько из них меняют то, что умеет агент:
Coder, «a complete coding-agent stack»: файловая система, shell, контекст репозитория, планирование, субагент-исследователь только на чтение и управление контекстом, которое удаляет старые результаты инструментов и обрезает их вывод на 64 тыс. символов. Документация предупреждает, чтоLocalWorkspace('.')«is not a sandbox, so commands can reach anything you can». Harness предлагает песочницы от Docker и SSH до Modal, E2B и Daytona.Memory— постоянный блокнот с пространствами имён и четырьмя инструментами (write_memory,read_memory,delete_memory,search_memory). Пространство имён задаёт ваш код, например по ID пользователя, «so the model cannot reach another user’s files».StepPersistence: сохранение, возобновление, продолжение и ветвление прогонов в файле, SQLite или Mongo, без движка долговечного исполнения.- Контроль:
Guardrails,SpendLimits,PromptInjectionDefender,DetectLoops,AskUser.
Harness на версии 0.x, и документация это признаёт: «the API may change between minor releases». Фиксируйте его версию строже, чем ядро.
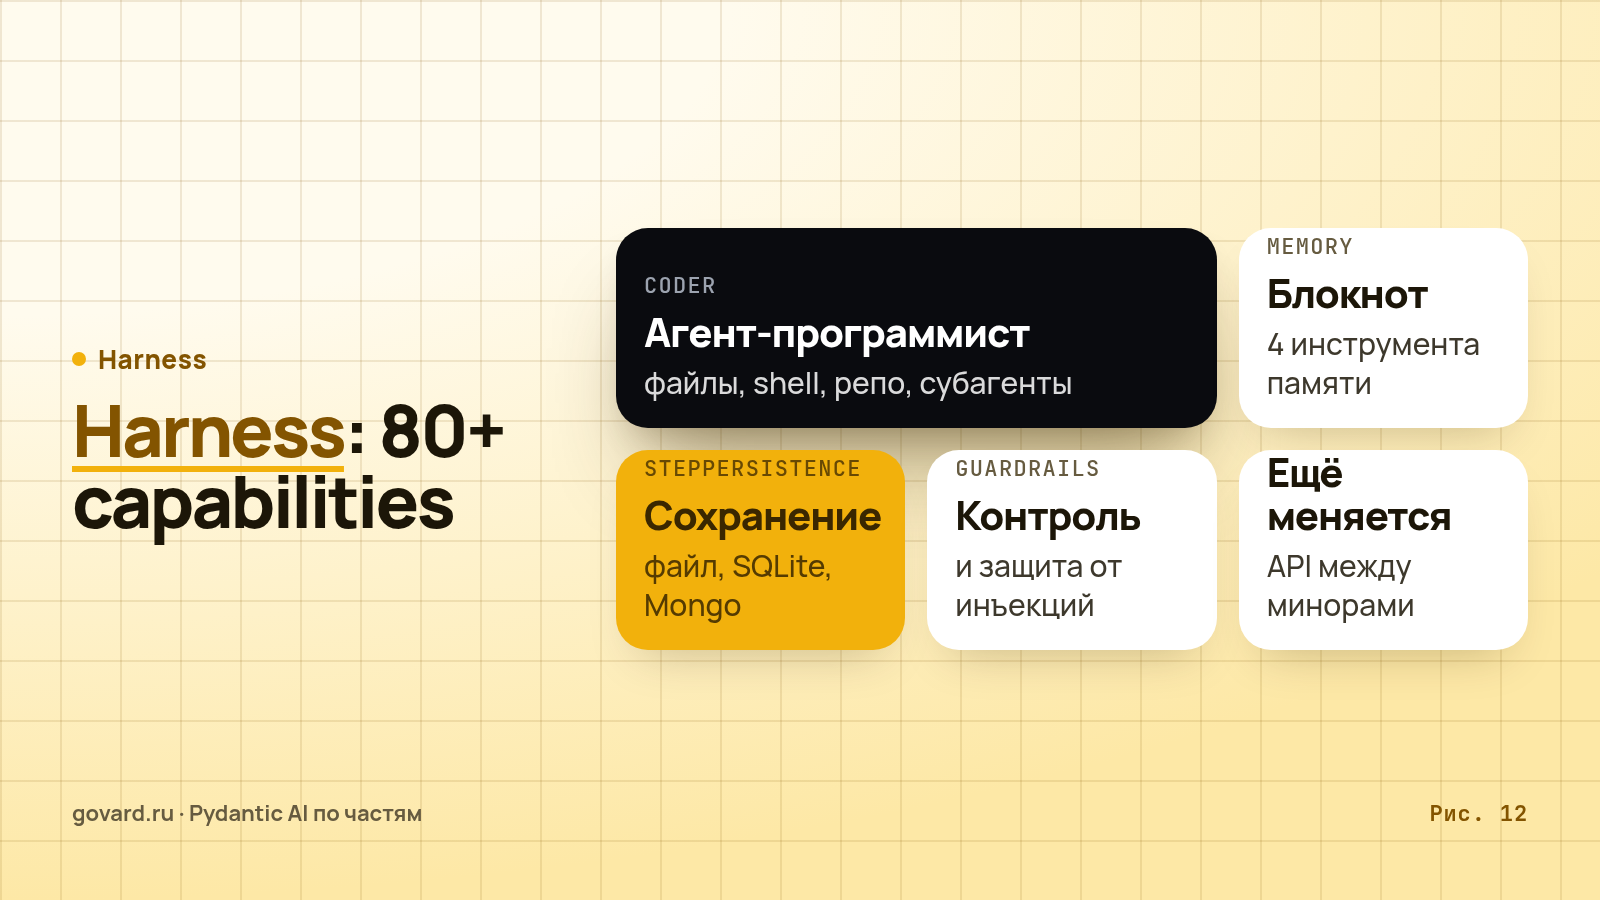
Источник: документация Pydantic AI Harness, ноябрь 2026.
10 · Много агентов: пять уровней, поднимайтесь только по необходимости
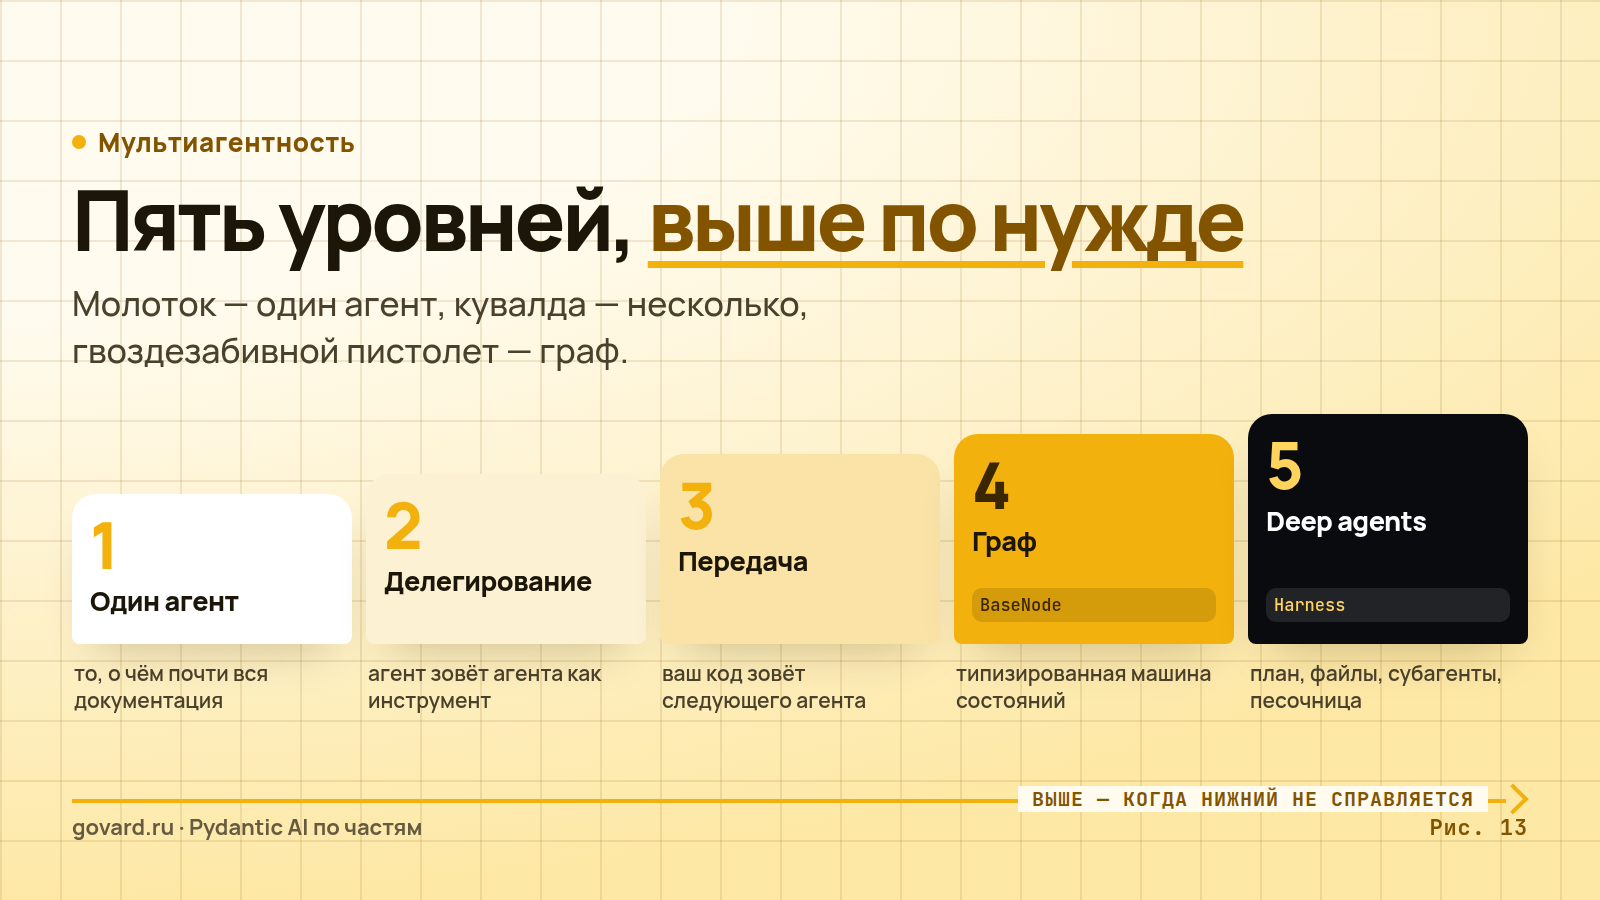
Источник: документация Pydantic AI, разделы multi-agent и graph, ноябрь 2026.
Документация описывает пять уровней сложности, и порядок здесь — рекомендация:
- Один агент — ему посвящена большая часть документации.
- Делегирование: агент использует другого агента через инструмент, вручную или через capability
SubAgentsиз Harness. - Передача управления кодом: отработал один агент, потом код приложения вызывает следующего.
- Граф — для самых сложных случаев.
- Deep agents: автономные агенты с планированием, работой с файлами, делегированием задач и выполнением кода в песочнице.
Делегирование — инструмент, который запускает другого агента. Главное правило касается учёта: передавайте usage=ctx.usage, чтобы запросы делегата считались в лимиты родителя.
@joke_selection_agent.tool
async def joke_factory(ctx: RunContext, count: int) -> list[str]:
    r = await joke_generation_agent.run(
        f'Please generate {count} jokes.',
        usage=ctx.usage,
    )
    return r.output
Без этого родитель с лимитом 50 запросов вызовет делегата, который сделает свои 50, и лимит ничего не защитит.
Граф. pydantic-graph — асинхронная библиотека графов и машин состояний, где узлы и рёбра задаются аннотациями типов. Узлы обычно dataclass; аннотация возвращаемого значения у метода run задаёт исходящие рёбра, End останавливает граф. Документация необычно честна о том, когда его брать: «If Pydantic AI agents are a hammer, and multi-agent workflows are a sledgehammer, then graphs are a nail gun» (молоток, кувалда и гвоздезабивной пистолет), и «Don’t use a nail gun unless you need a nail gun». Граф нужен, когда сложность в самом порядке шагов: явные состояния, ветвления и переходы с возобновлением, которые вы хотите типизировать и видеть на схеме.
V2 вывела из беты builder API (GraphBuilder с узлами step, decision, spread, broadcast и join). Она же удалила pydantic_graph.persistence, и builder API состояние графа не сохраняет. Чтобы сохранять и возобновлять прогон агента, документация отправляет к StepPersistence из Harness или к движку долговечного исполнения.
11 · Оценки, тесты и наблюдаемость
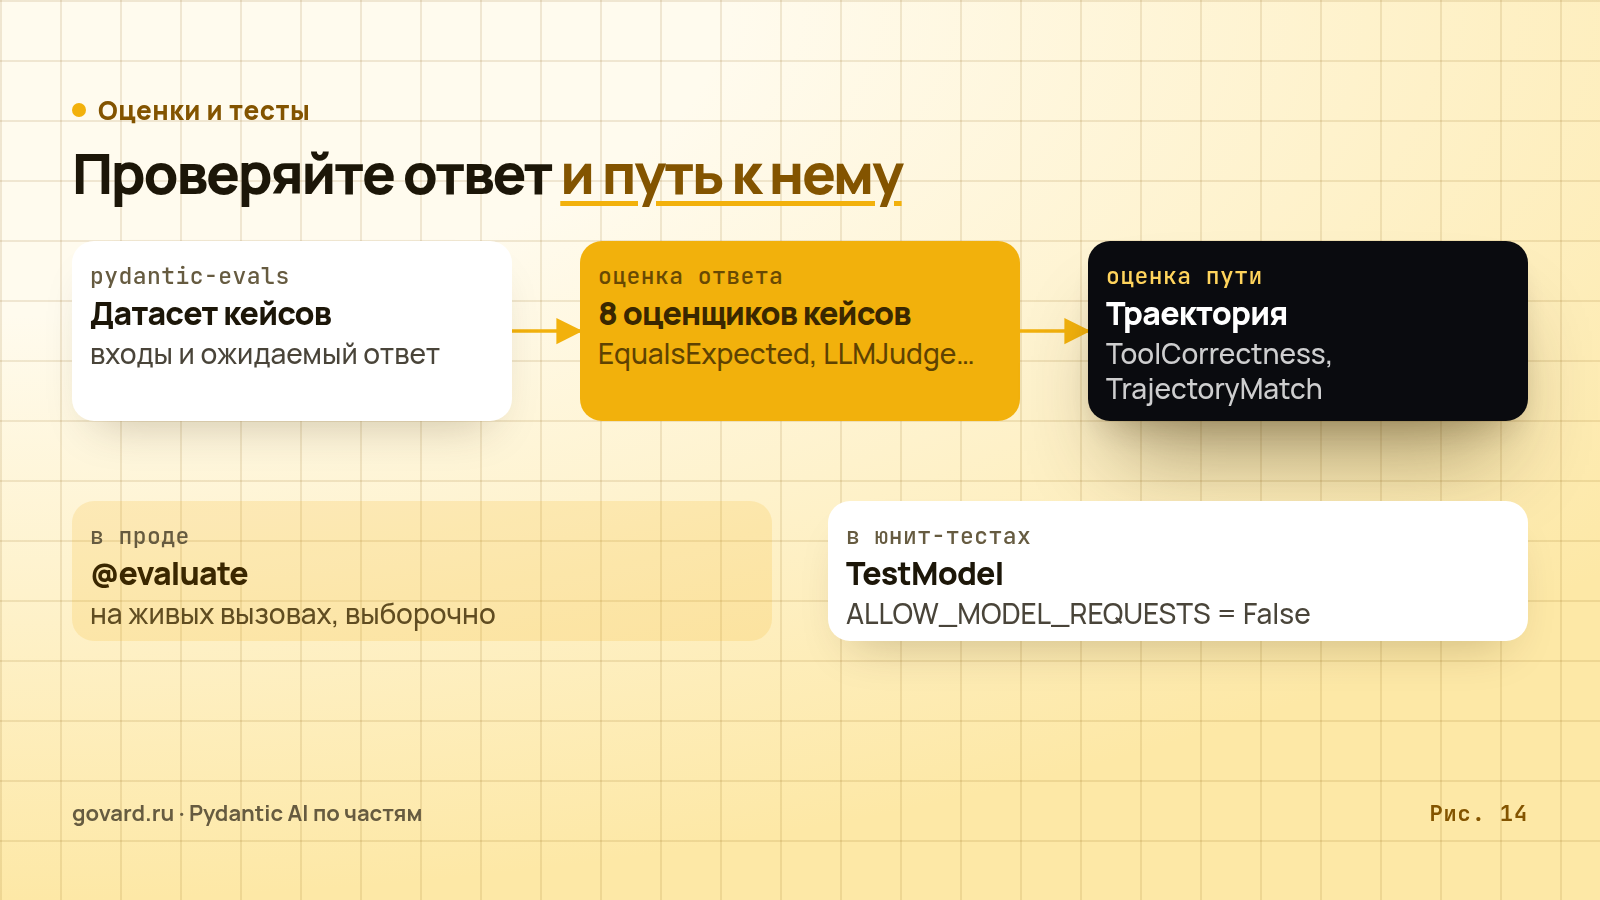
Источник: документация Pydantic AI, разделы evals и testing, ноябрь 2026.
Оценки. pydantic-evals оценивает финальные ответы агента и его траекторию — последовательность вызовов инструментов с аргументами — на наборах данных в коде или, в режиме онлайн-оценки, на выборке живого трафика. Набор данных — список кейсов со входами и ожидаемыми ответами:
dataset = Dataset(name='capital_quiz', cases=[
    Case(name='simple_case', inputs='What is the capital of France?', expected_output='Paris'),
])
Встроенных оценщиков кейсов восемь: EqualsExpected, Equals, Contains, IsInstance, MaxDuration, LLMJudge, GEval и HasMatchingSpan. Для агентов интереснее оценщики траектории: ToolCorrectness, TrajectoryMatch, ArgumentCorrectness, MaxToolCalls и MaxModelRequests. Они детерминированные и читают спаны OpenTelemetry, поэтому им нужен pydantic-evals[logfire], но не аккаунт в Logfire. Онлайн-оценка подключается к функциям в продакшене декоратором @evaluate.
Юнит-тесты. TestModel или FunctionModel заменяют настоящую модель, чтобы не платить за вызовы и не зависеть от их задержки и случайности. TestModel вызывает каждый инструмент с аргументами, сгенерированными по схеме, потом возвращает текст или структурированный ответ; «there’s no ML or AI in TestModel». Поставьте глобально models.ALLOW_MODEL_REQUESTS = False, чтобы тест, где забыли подмену, упал раньше, чем выставит вам счёт, и используйте agent.override(model=TestModel()) в самом тесте. Офлайн-лаборатория так прогнала весь цикл подтверждений, с детерминированными ID вызовов инструментов, которые удобны для снапшот-тестов.
Наблюдаемость. Pydantic AI пишет трассы OpenTelemetry для каждого прогона, запроса к модели и вызова инструмента. Logfire, коммерческий продукт Pydantic, — одно из мест, куда можно их отправить, но инструментирование «is plain OpenTelemetry», и те же спаны могут уходить в ваш собственный бэкенд. В V2 его включают capability Instrumentation. Атрибуты спанов могут меняться в минорных релизах.
12 · Что это значит для команд в России
Готовых провайдеров нет. В таблице провайдеров Pydantic AI и на странице Other compatible APIs GigaChat и YandexGPT я не нашёл на 05.11.2026. Для таких случаев есть OpenAICompatibleProvider (имя сервиса, base_url, ключ) с OpenAIChatModel или OpenAIResponsesModel. Документация предупреждает, что поддержка всех функций OpenAI не гарантирована, и если структурированный ответ игнорируется, надо настроить профиль модели.
GigaChat. Есть отдельный пакет pydantic-ai-gigachat от ai-forever (MIT). Он ходит в собственный API GigaChat и заявляет вызов функций, стриминг и обновление OAuth-токена. Версия одна, 0.1.0 от 20 мая 2026 года, до выхода V2; совместимость с 2.66 не заявлена, проверьте на стенде. Второй путь — OpenAI-совместимый API. В документации Сбера (обновлено 25 июня 2026 года) формат назван «частично совместимым с OpenAI API», base_url — https://api.giga.chat/v1, а ключом служит токен доступа из OAuth, который «действует 30 минут». Значит, обновлять токен придётся вашему коду. Пример с функциями там использует старый параметр functions, поэтому вызовы инструментов через OpenAIChatModel проверьте отдельно.
Yandex AI Studio. Последняя версия страницы о совместимости в репозитории документации (март 2026, до переезда на aistudio.yandex.ru): Responses API поддержан полностью, Chat Completions — частично, с параметрами temperature, max_tokens, stream, response_format, а tool_choice — только со значениями auto и none. Адрес — https://ai.api.cloud.yandex.net/v1, ключ — API-ключ сервисного аккаунта, ID каталога передаётся как project, модель — gpt://<ID_каталога>/yandexgpt/latest. Актуальную страницу 05.11.2026 открыть не удалось, сверьтесь с ней. Из-за project удобнее передать готовый клиент:
client = AsyncOpenAI(api_key=YC_API_KEY, base_url='https://ai.api.cloud.yandex.net/v1', project=FOLDER_ID)
model = OpenAIChatModel(f'gpt://{FOLDER_ID}/yandexgpt/latest',
                        provider=OpenAICompatibleProvider('yandex', openai_client=client))
Код собран по документации обеих сторон, на живом ключе я его не запускал. Если типизированный ответ через инструмент не проходит, попробуйте NativeOutput: response_format у Яндекса в списке поддержанных.
Свой контур. Logfire не обязателен: раздел «OTel without Logfire» отправляет спаны через opentelemetry-sdk и OTLP-экспортёр в ваш бэкенд. InstrumentationSettings(include_content=False) убирает из телеметрии промпты, ответы и аргументы инструментов. Для локальных моделей в таблице провайдеров есть Ollama (ollama:, локальный адрес http://localhost:11434/v1) и vLLM (vllm:). Для вызова инструментов vLLM нужно запускать с --enable-auto-tool-choice и --tool-call-parser.
13 · Переход с V1 на V2 и когда брать
Путь с V1 по документации: обновиться до последней V1 (1.100.0 или новее), убрать все предупреждения об устаревании, потом переходить на V2. Изменения, на которые вы скорее всего наткнётесь:
Agent(builtin_tools=[...])становитсяAgent(capabilities=[NativeTool(...)]); всё, что называлось builtin, теперь native.Agent(mcp_servers=[...])становитсяAgent(toolsets=[...]), четыре класса MCP-серверов —MCPToolset.- В строке модели нужен префикс провайдера;
openai:теперь означает Responses API. output_retries=иtool_retries=становятсяretries={'output': N}иretries={'tools': N}.instrument=,history_processors=,prepare_tools=иevent_stream_handler=становятся capabilities.Agent.to_a2a()переезжает в пакетfasta2a;to_ag_ui()становитсяAGUIAdapter.end_strategyпо умолчанию'graceful', поэтому инструменты, запрошенные рядом с финальным ответом, теперь выполняются.- Голый
pip install pydantic-aiставит меньше дополнений: Bedrock, Groq, Mistral, Cohere, xAI, Temporal и AG-UI теперь требуют явных extras. pydantic_graph.persistenceиpydantic_graph.mermaidудалены.
Хорошая новость: «Message history serialized with V1 … continues to deserialize in V2», сохранённые разговоры переживут обновление.
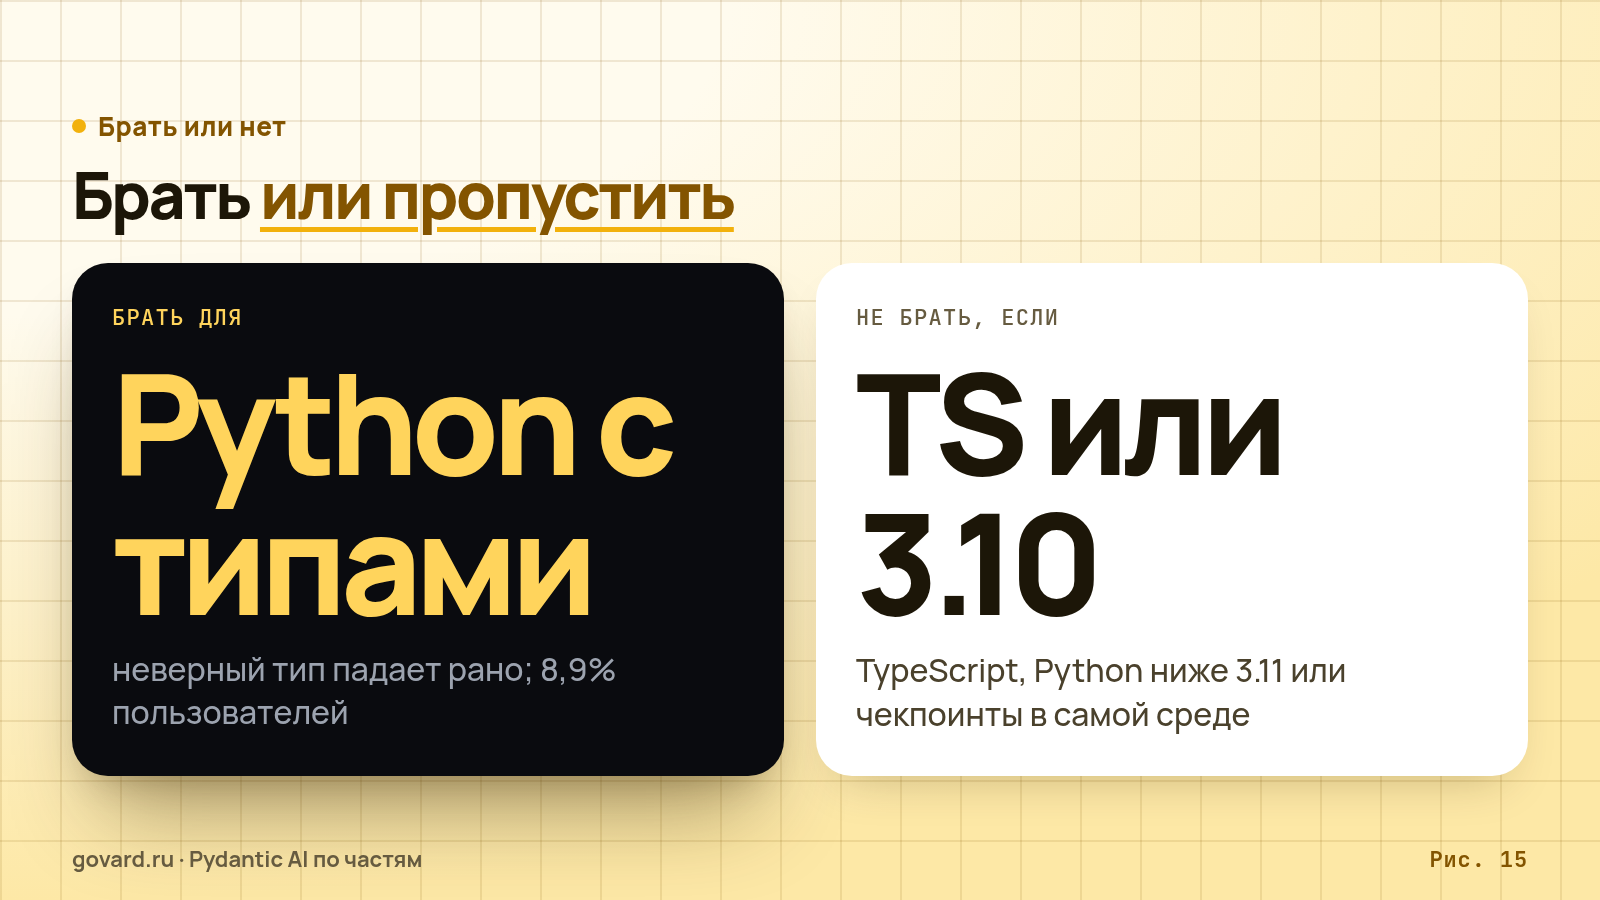
Источник: опрос Stack Overflow 2026; документация Pydantic AI.
Брать Pydantic AI стоит, когда агент живёт в Python-сервисе и неверные данные должны падать рано. Типизированные зависимости, проверенные аргументы инструментов и гарантированный тип ответа убирают целый класс ошибок, который другие фреймворки оставляют на совести промптов. Он подходит командам, которым нужна библиотека, которую вызывают из своего кода. Tiger Data в кейсе на сайте вендора выбрали его как «a library for the LLM and agent parts, not an opinionated framework for the whole project»; Overjoy, в другом кейсе вендора, ушли с LangChain, потому что тот был «overly complicated». Оба кейса — материалы вендора, а Pydantic продаёт Logfire.
Заложите дополнительную работу на повторы (выберите один ответственный слой и запишите решение), явные лимиты под свою нагрузку и API Harness на 0.x, если вы им пользуетесь.
Не берите или смотрите на другое, если не можете запустить Python 3.11 или новее; если агент живёт в веб-приложении на TypeScript, где родной выбор — Vercel AI SDK; или если в центре вашего дизайна состояние графа с чекпоинтами и вы хотите, чтобы его давала среда исполнения. Так устроен LangGraph (см. наши разборы LangChain по слоям и OpenAI Agents SDK по частям). Pydantic AI оставляет долговечность внешним движкам, у LangGraph чекпоинты в ядре.
Чек-лист перед продакшеном:
- Задайте
deps_typeиoutput_typeкаждому агенту; никаких нетипизированныхAgent(...). - Задайте
UsageLimitsпод свою нагрузку, не надейтесь на 50. - Выберите один слой для повторов; явно задайте повторы SDK провайдера и
maximum_attemptsв Temporal. - Передавайте
usage=ctx.usageкаждому агенту-делегату. - Используйте обработчик подтверждений внутри прогона или держите
DeferredToolRequestsвoutput_typeи продолжайте с полной историей. - Запускайте юнит-тесты с
TestModelиALLOW_MODEL_REQUESTS = False. - Добавьте хотя бы один оценщик траектории для инструментов, которые меняют данные.
- Зафиксируйте
pydantic-aiна минорной версии, аpydantic-ai-harness— строже.
Кто сегодня отвечает за повторы в вашем стеке агентов: SDK провайдера, фреймворк или движок workflow? Если ответ «все трое», теперь вы знаете, сколько это стоит.
FAQ
Что такое Pydantic AI? Типизированная библиотека агентов для Python от команды Pydantic; текущая версия 2.66.0 (4 ноября 2026 года).
Что изменилось в V2?
Capabilities стали главной точкой расширения; встроенные инструменты стали native tools, классы MCP слились в MCPToolset, в строке модели нужен префикс провайдера.
Сколько раз он повторяет неудачный запрос? Зависит от восьми слоёв, которые перемножаются; в примере из документации один вызов превращается в 18 запросов.
Какой лимит запросов по умолчанию? 50 запросов к модели на прогон, после этого прогон выбрасывает исключение.
Нужен ли pydantic-graph для нескольких агентов? Обычно нет: большинство случаев закрывают делегирование и передача управления кодом.
Можно ли подключить GigaChat или YandexGPT?
Готовых провайдеров нет. Есть пакет pydantic-ai-gigachat от ai-forever (вышел до V2) и OpenAI-совместимые API GigaChat и Yandex AI Studio, которые подключают через OpenAICompatibleProvider.