Код-ревью, когда код пишут агенты: что команде из 10 человек взять у Anthropic
Как команда Claude Code проверяет код, который пишет ИИ: семь слоёв проверок, уровни риска, пять правил одобрения, потолок раундов для петли агент↔агент. Что команда из 10 человек берёт сразу, что позже и что не переносится; примеры Т-Банка, Content AI и SourceCraft.
В репозиториях Claude Code часть изменений попадает в main без одобрения человека. Около 90% этого кода пишет сам Claude, а внимание людей команда распределяет по риску: документацию, тексты и добавления за фичефлагом от доверенных авторов не одобряет никто, обычные изменения продукта — один человек, самый рискованный код — двое. Остальное читают машины.
Коротко
- Семь слоёв проверок. Человек подключается на пятом.
- Уровень риска задаёт изменение, а путь без людей открыт только доверенным авторам.
- Агент-автор и агент-ревьюер могут ходить по кругу всю ночь. Четыре изменения в повторном ревью, включая потолок в три раунда, подняли долю PR, прошедших с первого раза, с 65% до 78%.
- С июня по сентябрь принятых PR стало больше чем вдвое, доля откатов упала больше чем на 40%. Цифры внутренние, и ревьюера Anthropic продаёт.
- Команда из 10 человек возьмёт большую часть проверок за месяц. Слияние без людей подождёт, пока нет отката в один шаг и замера доли откатов.
01 · Семь слоёв между промптом и main
Команда опубликовала свой регламент код-ревью 15 октября 2026 года. Причина — объём. В монорепозитории Anthropic число изменений в день выросло примерно с 2 500 в мае до 30 тыс. с лишним в сентябре, пишет инженерный блог компании. У Claude Code свой репозиторий, но нагрузка, по словам авторов, та же. Большинство исследований из разбора продуктивности разработчиков с ИИ показали рост выработки, и весь этот прирост приходит на ревью.
Авторы считают, что вопрос «прочитал ли код человек?» плохо описывает суть. Важнее другое: что может сломаться в этом изменении и какая проверка, автоматическая или человеческая, это поймает. Отсюда семь слоёв:
- Проверка до пул-реквеста. Агенту дают то, что можно запустить: тесты, сборку, скриншот для сравнения с макетом. Он должен показать вывод. Затем diff смотрит субагент с чистым контекстом.
- ИИ-ревью на каждый PR. Несколько агентов ищут баги, другая группа голосует по каждому замечанию, и публикуется только то, с чем согласились многие. Замечания о стиле отбрасываются. На каждое замечание надо ответить: исправить или закрыть с причиной.
- Ревью безопасности, которое блокирует. Пока открыто хоть одно замечание по багам или безопасности, слить PR нельзя.
- Обязательный CI. Линтер, типы, тесты на всех платформах, сборка. Шаблон PR спрашивает, как изменение проверяли и как его откатить.
- Одобрение людьми по уровню риска. Разделы 02 и 03.
- Очередь слияния, флаги, поэтапный релиз. Очередь заново запускает проверки на main вместе с изменением. Новые функции сначала включают флагом только для сотрудников, потом выпускают в канал
latest, затем вstable. - Быстрое обнаружение и откат. Флаг выключается без деплоя. На разборе инцидента ищут слой, который должен был поймать ошибку.
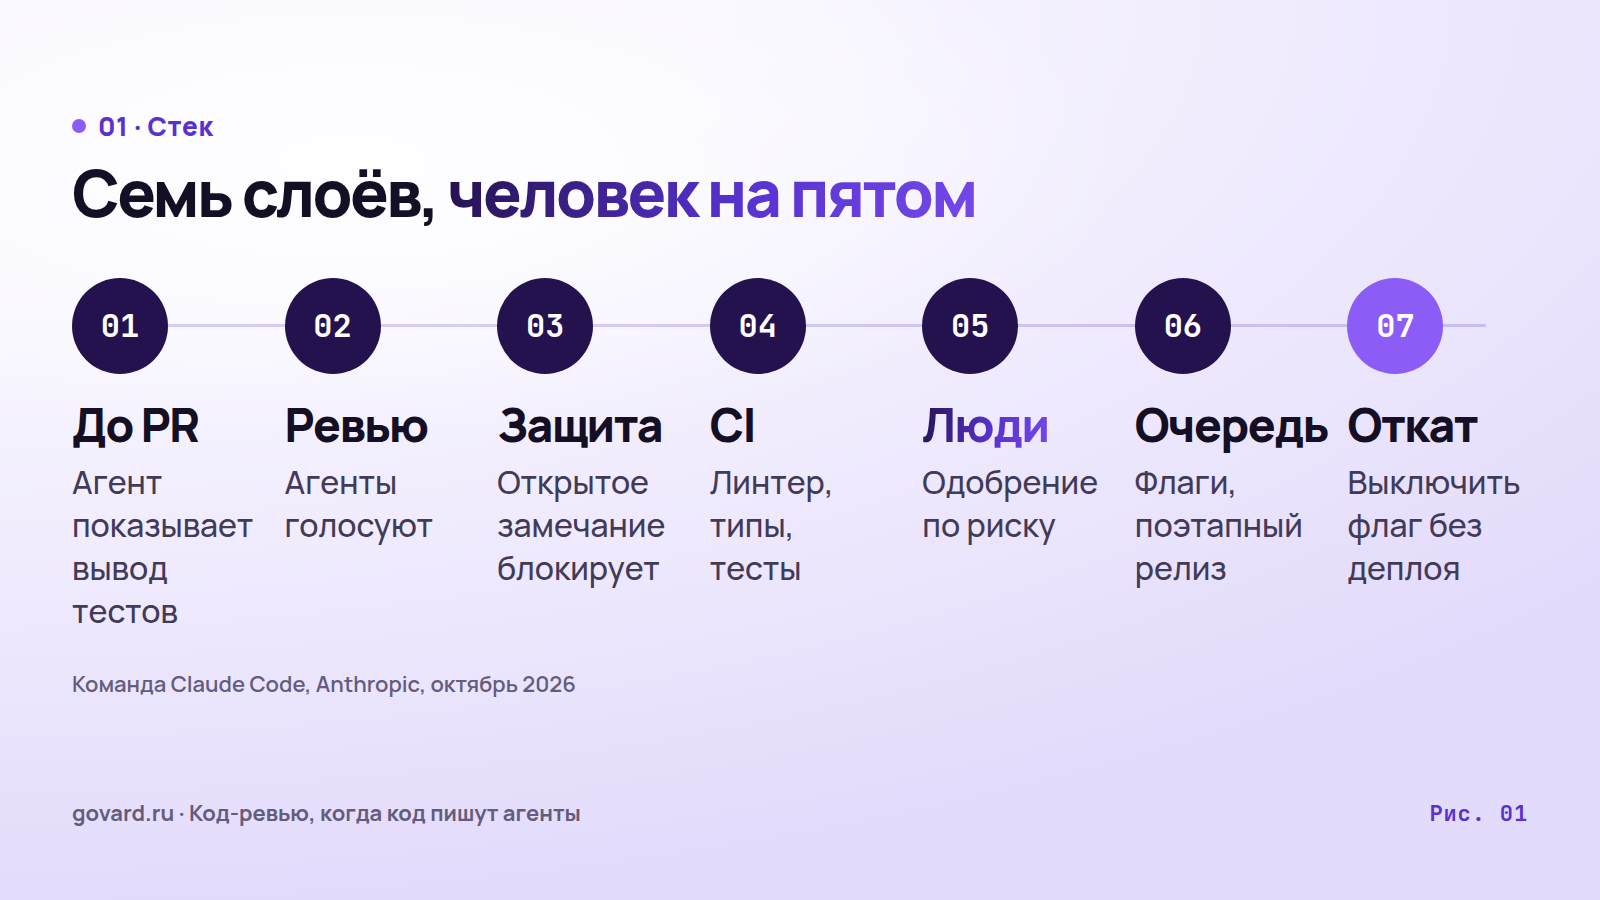
Источник: команда Claude Code, «How the Claude Code team does code review», Anthropic, октябрь 2026.
К пятому слою Claude обычно уже хотя бы раз проверил и поправил изменение.
Одну деталь стоит взять в первый же день — файл REVIEW.md. В нём владельцы кода объясняют ревьюеру, что важно в их части репозитория. Хороший REVIEW.md короткий: как здесь выглядит поломка (документация «врёт», конфиг «отправляет не туда»), сколько мелких замечаний допустимо, какие пути пропускать, и требование ссылаться на файл и строку. Примерно так (пример мой, не файл Anthropic):
# REVIEW.md — billing/
Поломка здесь — клиенту выставлен неверный счёт.
Отмечать: расчёт сумм, округление, валюты, повторы, которые спишут деньги дважды.
Пропускать: generated/, *.snap, fixtures/.
Не больше трёх мелких замечаний.
У каждого замечания — файл:строка. Сводка начинается с числа замечаний.
Если ревьюер раз за разом ловит одно и то же, правят источник: CLAUDE.md, REVIEW.md, правило линтера или навык агента.
02 · Таблица рисков
На пятом слое регламент конкретен. Команда хочет, чтобы большинство PR проходило с одобрением не больше чем одного человека (им может быть сам автор), а откатов и инцидентов не стало больше. Одобрения распределены по уровням:
| Риск | Примеры | Одобрений людей |
|---|---|---|
| Низкий | Документация, тексты, внутренние функции, добавления за фичефлагом | Ни одного, если автоматическое ревью и проверка безопасности зелёные |
| Средний | Обычные изменения продукта; чувствительные зоны: кэш, автообновление, системные промпты | Один человек |
| Высокий | Самый рискованный код и небольшой список путей, где всегда нужны двое | Двое |
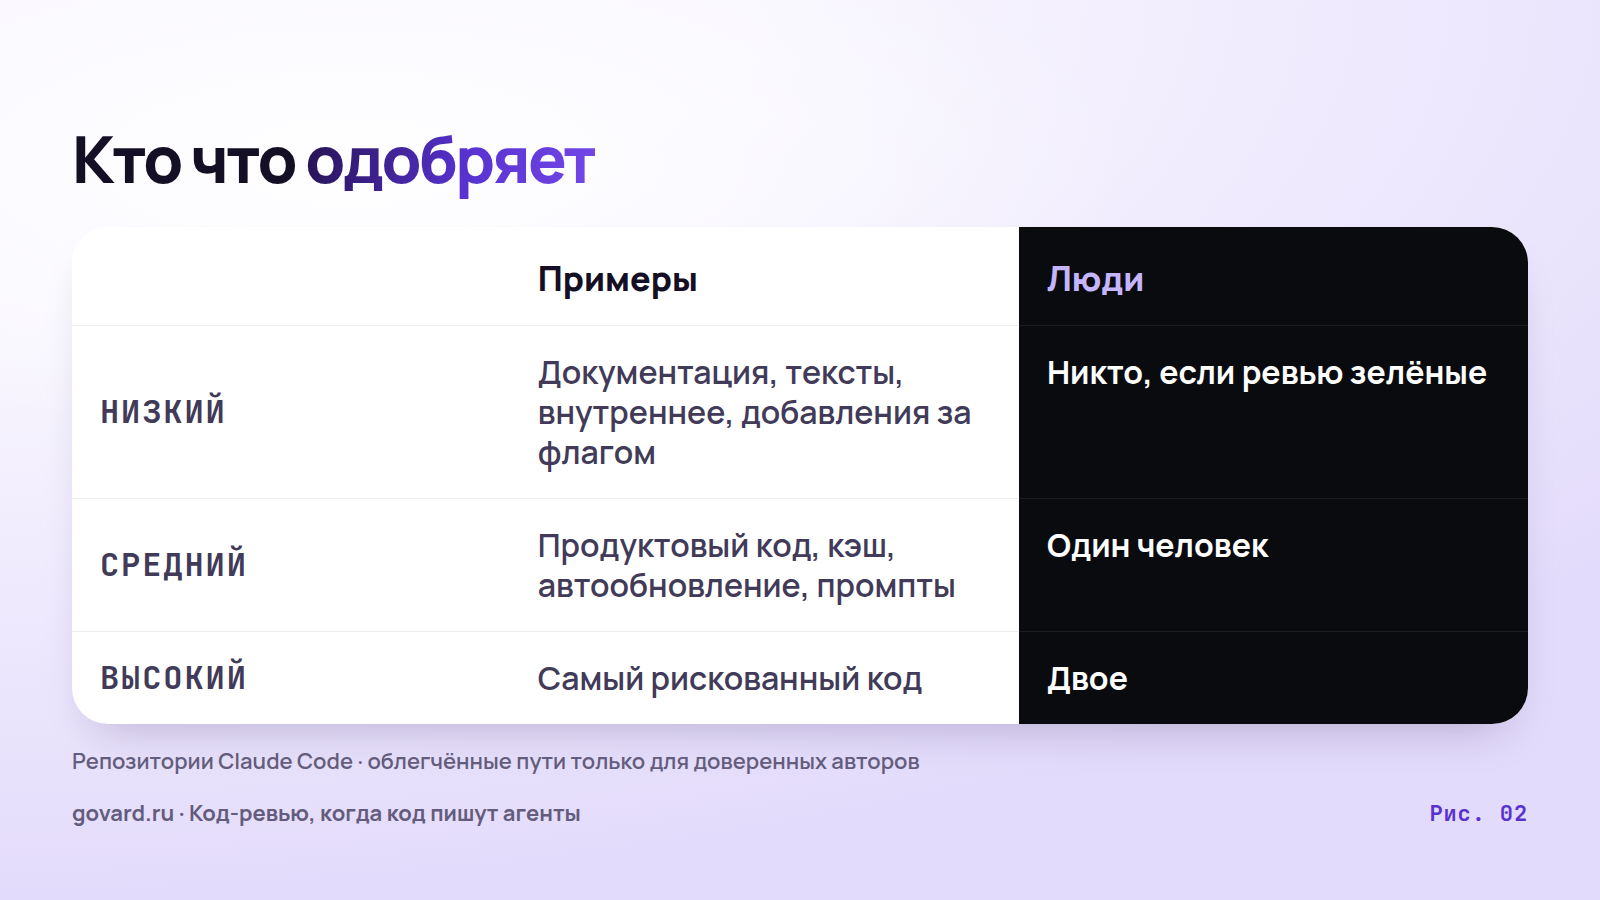
Источник: команда Claude Code, Anthropic, октябрь 2026. Облегчённые пути — только для доверенных авторов.
Уровень выбирает классификатор, который читает изменение. Второй классификатор решает, не нужен ли человек именно этому изменению, даже если уровень говорит «не нужен». Часть путей всегда требует человека: всё, что владельцы пометили как чувствительное, и любой файл CI.
Время людей меряют тремя числами: одобрения на PR, комментарии людей и сколько PR ждёт человека. Ограничитель — доля откатов и инцидентов. Если она растёт, время людей просто перенесли с ревью на починку.
03 · Пять правил одобрения
Таблицу легко обойти, поэтому её держат пять правил:
- Уровень задаёт изменение. Классификатор читает его и выбирает уровень, кто бы ни был автором.
- Облегчённые пути только у доверенных авторов. В основном это команда — владелец репозитория. Всем остальным нужен второй человек.
- Одобрение агента никогда не засчитывается за человеческое. Автоматическое ревью может пропустить изменение низкого риска, но не займёт место, где нужен человек.
- Кто поставил задачу агенту, тот отвечает. В PR, написанном агентом, этот человек считается одним из обязательных ревьюеров, как если бы сам набрал код.
- Одобрение действует на один конкретный коммит. Если агент добавил новый коммит или кто-то вручную разрешил конфликт слияния, одобрение дают заново.
Правила 3–5 закрывают лазейки, которые с агентами стали шире. Бот не голосует за бота. Человек не прячется за «это агент написал». Агент не протащит новый код под старым одобрением.
04 · Агент проверяет агента: раунды должны сходиться
Правила одобрения касаются людей. Для петли агент↔агент понадобились свои правила. «Шум обходится дороже, когда автор — агент», — пишут в Anthropic. Человек отмахнётся от мелкого замечания за секунды. Агент его исправит: новый коммит, новый раунд ревью.
Один PR в CLI за ночь прошёл больше пятидесяти раундов ревью и правок, пока автор его не остановил. Команда запустила git blame по тому, что ревьюер отмечал снова и снова: около 59% было кодом, который существовал ещё до первого прохода. Новых багов ревьюер почти не находил, каждый раунд он выкапывал ещё несколько старых. Команда признаёт, что сама усугубила дело, запуская несколько раундов по умолчанию.
Теперь рядом с полнотой (recall) отслеживают число раундов до прохождения, а в повторное ревью внесли четыре изменения:
- Потолок раундов. После трёх раундов ревьюер просит автора остановиться и пересмотреть подход.
- Повторное ревью только нового diff после первых проходов.
- Отмечать класс ошибки, чтобы автор исправил все её экземпляры за один раз.
- Без повторов уже опубликованных замечаний.
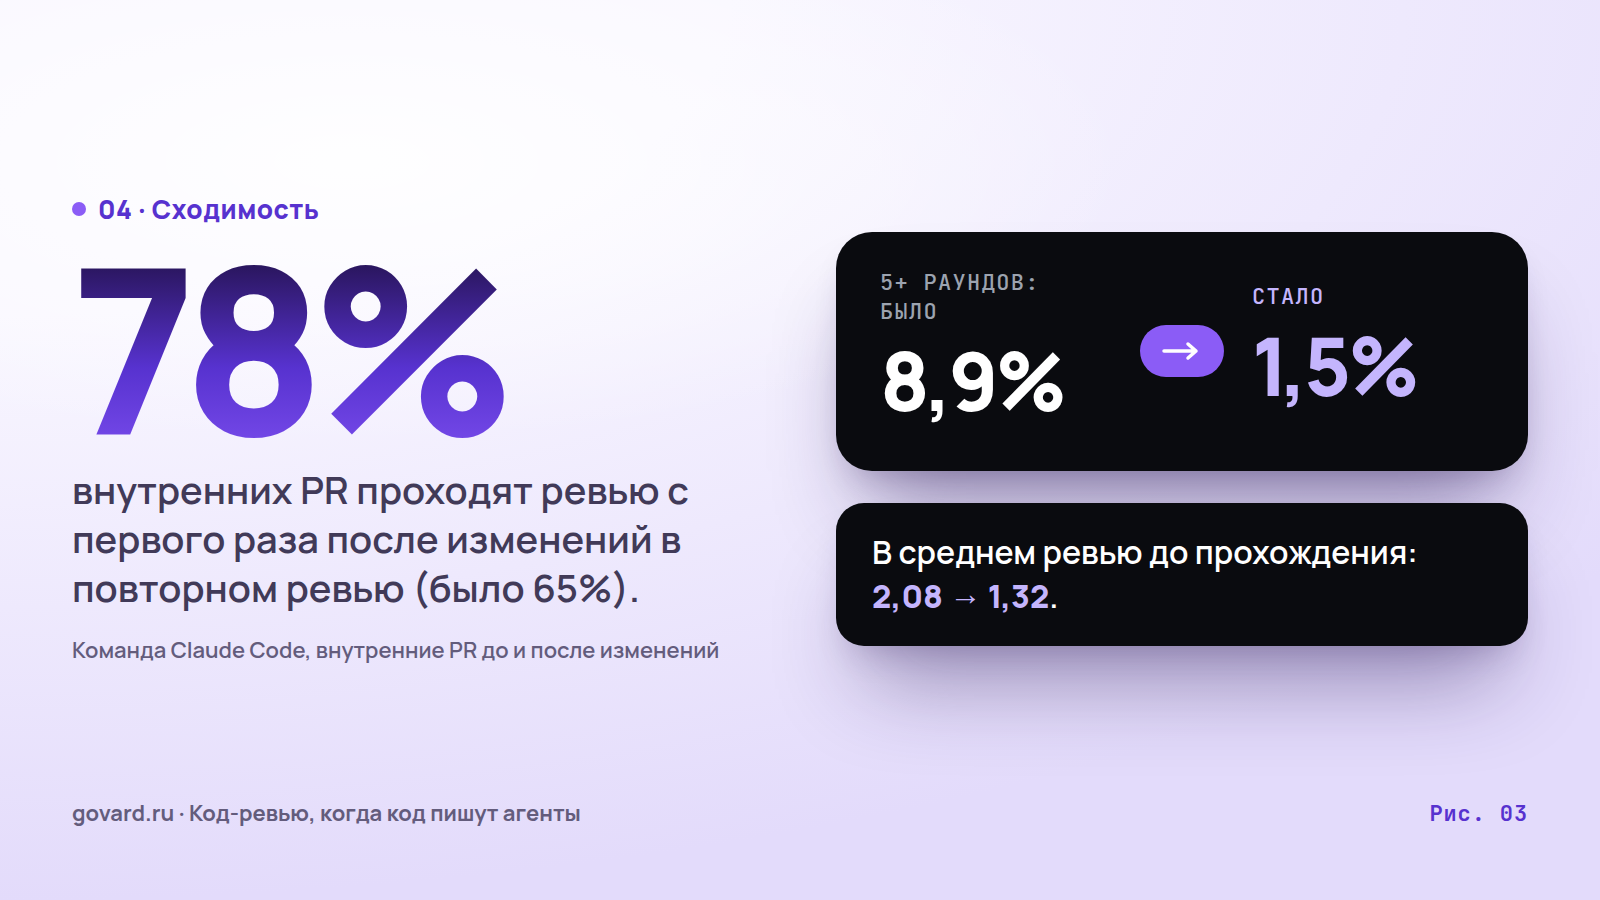
Источник: команда Claude Code, внутренние пул-реквесты до и после изменений, Anthropic, октябрь 2026.
Потолок раундов — самое дешёвое правило регламента. Он останавливает петлю на третьем раунде, вместо того чтобы дать ей идти всю ночь.
05 · Ревьюер учится на инцидентах
Петле с потолком всё равно нужен ревьюер, который ловит правильные баги. Команда собрала прошлые PR, вызвавшие инциденты, с их откатами и исправлениями, а инженеры, знающие этот код, подтвердили каждую ошибку. Ревьюер проходит этот набор каждый день. Правку его промптов, инструментов или модели оставляют, только если оценка выросла. Это та же дисциплина, что и в оценке ИИ-агентов, только для ревьюера.
Шум меряют отдельно, иначе полноту легко накрутить. На каждое замечание ставят одну из четырёх меток по реакции автора PR: исправил, ошибка ревьюера, так задумано, неважно. Приоритет записан: сначала реальные баги, потом меньше раундов.
06 · Где остаются люди
Всё это освобождает людей для решений, в которых машины слабы. Anthropic называет пять:
- Нужно ли это делать вообще? Направление, вкус, границы задачи.
- Рискованный код: биллинг, автообновление, CI.
- Архитектура, которую остальные будут копировать.
- Чтение доказательств. Если не можете сказать, что пропустят проверки, просите полноценное ревью.
- Ответственность. За каждое выпущенное изменение отвечает человек, кто бы его ни набрал.
Норма команды: «влил в main — отвечаешь». Она работает, потому что изменения маленькие, а флаги и откаты исправляют большинство ошибок за минуты.
Внешние данные тоже говорят, что подпись человека под PR мало что гарантирует. Исследование «Habituation at the Gate» разобрало 11 429 ревью пул-реквестов от ИИ-агентов: 400 постоянных ревьюеров, семь месяцев. Доля одобрений выросла с 30,1% до 36,8%, построчных комментариев стало на 22% меньше. Авторы называют это рефлекторным привыканием под растущей нагрузкой. Уставший клик «одобрить» мало что проверяет.
07 · Что переносится в команду из 10 человек
Схема Anthropic рассчитана на объёмы, которых у маленькой команды нет (монорепозиторий Anthropic — 30 тыс. с лишним изменений в день), на инженеров, которые весь день работают в собственном продукте, и на собственного ревьюера. Что, по-моему, переносится:
| Брать сразу | Брать после замеров | Пока не переносится |
|---|---|---|
| Вывод тестов или сборки в PR | Уровни риска как правила путей в CODEOWNERS | Классификаторы уровня: на вашем объёме точность не проверить |
Короткий CLAUDE.md или AGENTS.md и REVIEW.md | Слияние без людей для документации, когда есть откат в один шаг и замер доли откатов | Сотрудники как первые пользователи: инженеры Anthropic живут в Claude Code |
| Один ИИ-ревьюер, ответ на каждое замечание | Набор инцидентов для оценки ревьюера: файл завести сейчас | «Полная картина кода не нужна»: в маленькой команде ревью — главный способ узнать код |
| Потолок в три раунда, потом ревью только нового diff | Замер шума по реакции авторов | Ночные ревью-агенты по всему коду: стоимость не раскрыта |
| Бот не одобряет за человека; новый коммит сбрасывает одобрения | Очередь слияния, когда зелёные PR начнут вместе ломать main |
Многое из левой колонки — настройки. В GitHub ревью Copilot по умолчанию не засчитывается в обязательные одобрения, но с 1 сентября 2026 года администратор может это разрешить. По третьему правилу Anthropic эту настройку лучше не трогать. Для правила 5 в защите веток уже есть флажок «Dismiss stale pull request approvals when new commits are pushed». Правила путей начинаются с трёх строк:
# CODEOWNERS
/billing/            @acme/payments
/.github/workflows/  @acme/platform
/install/            @acme/platform
Одна оговорка: GitHub засчитывает одобрение любого одного владельца, поэтому уровень «двое» одним CODEOWNERS не собрать. Для него нужно отдельное правило, например проверка в CI, которая считает одобрения на этих путях. В SourceCraft от Яндекса правила одобрения лежат в .sourcecraft/review.yaml, но засчитывается ли там ИИ-бот, документация не говорит.
Российские команды пока на разных ступенях:
- Т-Банк проверяет ИИ весь новый код в веб-интерфейсе git-платформы: несколько сотен комментариев в день, и около 30% из них разработчики отмечают лайком, по данным блога компании на Хабре (ноябрь 2025). Это замер шума по одной метке вместо четырёх. Кто одобряет слияние, в статье не сказано.
- Content AI (101–200 сотрудников) собрала ИИ-ревьюер за три дня как шаг в CI: около пяти минут на проверку, комментарии прямо в PR. Слияние он намеренно не блокирует, пока у модели есть ложные срабатывания: по оценке команды, мимо примерно каждое пятое замечание. Расход вырос с ~5 тыс. до ~15 тыс. рублей в месяц, когда ревьюер включили большему числу людей.
Такой старт я и советовал бы маленькой команде: ИИ советует, люди одобряют, шум считают до того, как дать боту право блокировать.
Моя команда тоже небольшая. AgenticCRM я строю с шестью инженерами. Кодинг-агенты работают по правилам репозитория и через контрольные точки перед релизом, на каждый PR поднимается превью-окружение, в наборе около 800 unit-тестов. Новые тесты добавляются только с одобрения человека, через отдельный шаг CI — «бюджет тестов». Если агент может сам писать себе тесты, решать, что считается «прошло», должен человек.
08 · Чек-лист на четыре недели
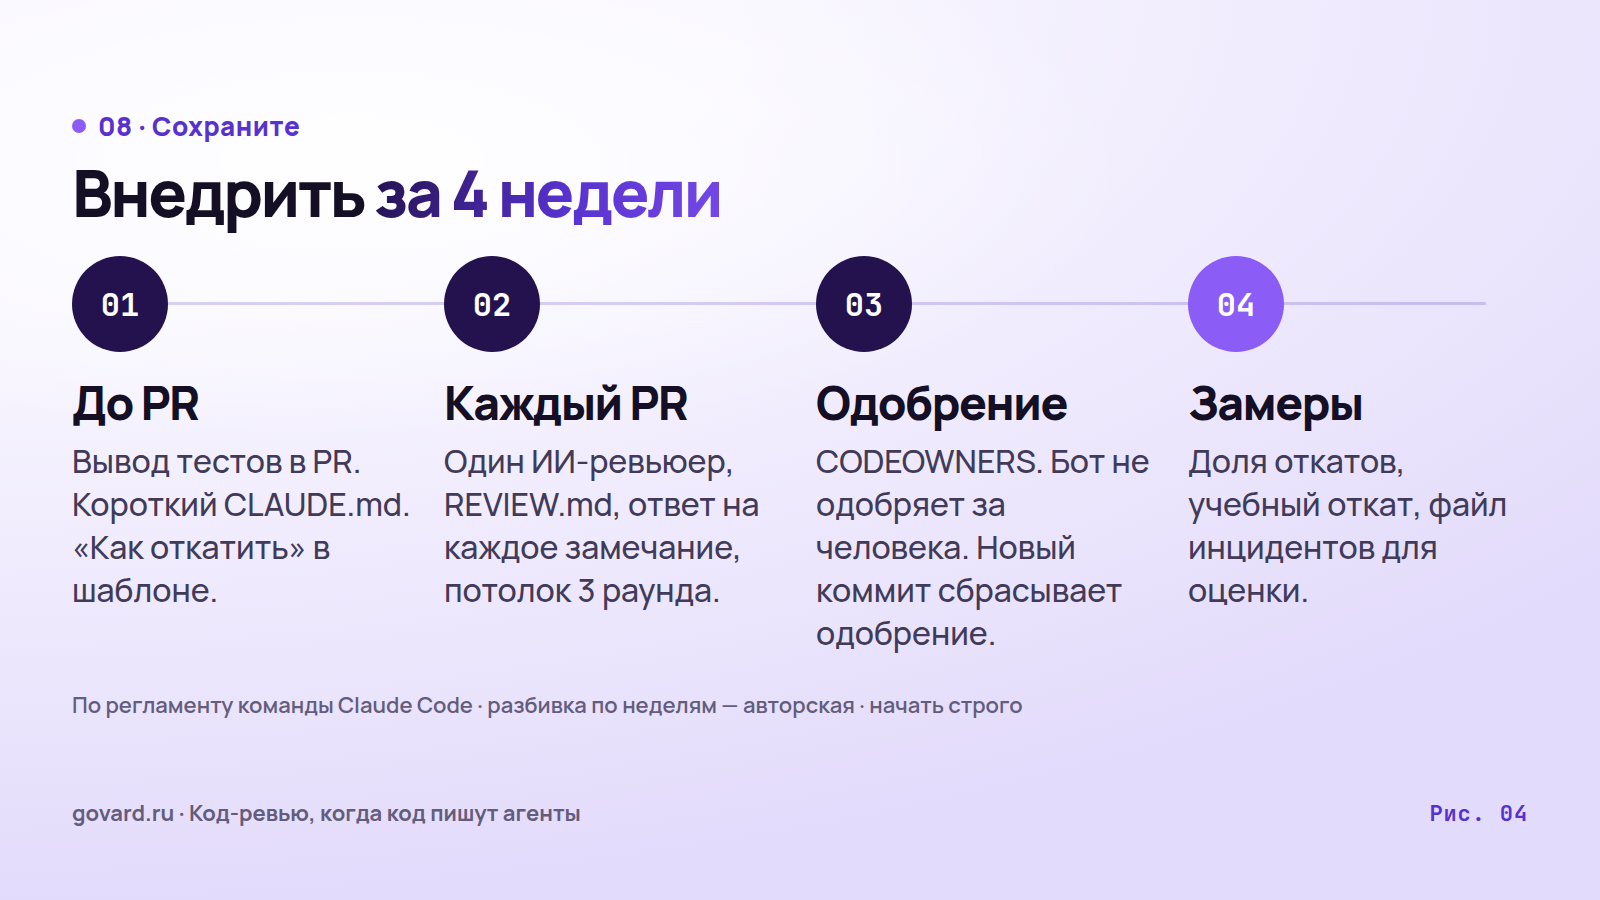
По разделу о внедрении из регламента команды Claude Code, Anthropic, октябрь 2026; разбивка по неделям — авторская.
Неделя 1. До пул-реквеста
- Агент прикладывает к PR вывод тестов или сборки.
- Короткий
CLAUDE.mdилиAGENTS.md, хуки форматтера и линтера. - Шаблон PR: «Как проверено», «Риск», «Как откатить».
Неделя 2. На каждом PR
- Один ИИ-ревьюер на одном репозитории и
REVIEW.md. - На каждое замечание ответ до слияния: исправлено или закрыто с причиной.
- Потолок в три раунда, дальше ревью только нового diff.
Неделя 3. Одобрение
- CODEOWNERS: авторизация, биллинг, CI и релизные процессы, установщики всегда требуют человека.
- Одобрение бота не засчитывается; новый коммит сбрасывает одобрения.
- Уровни риска записаны и задаются изменением. Начать строго.
Неделя 4. Замеры и откат
- Базовые цифры: одобрения на PR, время ожидания человека, доля откатов, инциденты.
- Учебный откат: выключить флаг или откатить коммит с выкладкой в один шаг и засечь время. Цель — минуты.
- Завести файл инцидентов для оценки ревьюера. Ослаблять уровень только после того, как доля откатов не выросла.
09 · Чего мы не знаем
Один пробел Anthropic называет сама. Плохое слияние по-прежнему замечают автор, дежурный и дашборды. Автоматических стоп-кранов, которые ужесточают одобрение при росте откатов, пока нет, и инженеры команды хотят их раньше, чем больше кода пойдёт в main без людей. Кто копирует уровень «без людей», копирует его и без этой страховки.
Другие ограничения:
- Цифры внутренние. Нет абсолютного числа PR, исходной доли откатов, внешней проверки. С июня по сентябрь менялось многое сразу, поэтому падение на 40% нельзя приписать одному слою.
- Нет ключевых параметров. Точность классификаторов, размер списка доверенных авторов и стоимость глубокого ревью не опубликованы.
- Интерес вендора. Code Review for Claude Code — платный продукт на тарифах Team и Enterprise. Сам продукт публикует замечания и оставляет одобрение людям. Слияние только по автоматическим проверкам — это регламент внутренних репозиториев Anthropic.
- Внешних данных мало. Исследование о привыкании — один препринт, российские примеры — блоги и документация самих компаний, без внешней проверки.
Где ваша граница: какие изменения вы пустили бы в main без одобрения человека?
Вопросы и ответы
Как Anthropic проверяет код, который пишет Claude? Каждое изменение проходит семь слоёв: проверку до пул-реквеста, ИИ-ревью, блокирующее ревью безопасности, CI, одобрение людьми по уровню риска, очередь слияния с флагами и поэтапным релизом, быстрый откат. Большую часть кода читают машины.
Попадает ли в Anthropic код в main без одобрения человека? Да, в репозиториях Claude Code: документация, тексты, внутренние функции и добавления за фичефлагом, если автоматические ревью зелёные и автор в списке доверенных. Обычные изменения продукта одобряет один человек, самый рискованный код — двое.
Считается ли одобрение ИИ-ревьюера одобрением человека? В Anthropic нет: одобрение агента никогда не засчитывается за человеческое. В GitHub с 1 сентября 2026 года Copilot можно разрешить одобрять PR, по умолчанию настройка выключена.
Как не дать ИИ-ревьюеру и кодинг-агенту ходить по кругу? Ограничить ревью тремя раундами, дальше проверять только новый diff, отмечать класс ошибки целиком и не повторять замечания. После этих четырёх изменений доля PR, прошедших ревью с первого раза, выросла с 65% до 78%.
Что маленькая команда может взять у Anthropic сразу? Вывод тестов в каждом PR, короткие файлы инструкций и REVIEW.md, одного ИИ-ревьюера с ответом на каждое замечание, потолок раундов и защиту веток, где бот не заменяет человека. Слияние без людей стоит отложить до отката в один шаг и замера доли откатов.