Продуктивность разработчиков с ИИ: от −19% до +56% — что измерило каждое исследование
Продуктивность разработчиков с ИИ в 2025–2026 годах: что мерили METR, полевые эксперименты Microsoft, исследование внедрения Claude Code, GitClear, DORA и Stack Overflow, почему цифры расходятся и как измерить эффект в своей команде.
Две опубликованные цифры о продуктивности разработчиков с ИИ верны одновременно: с GitHub Copilot разработчики выполнили задачу на 55,8% быстрее, а опытные разработчики с ИИ-инструментами работали на 19% дольше. Это разные исследования с разными вопросами: одна изолированная задача в контролируемом эксперименте и реальные задачи в больших проектах, которые разработчики хорошо знают.
Самый чистый способ закрыть спор — рандомизированный эксперимент на реальной работе — в 2026 году перестал давать надёжную цифру. Во втором эксперименте METR 30–50% опрошенных участников не отдавали в исследование часть задач, где больше всего ждали помощи от ИИ. Остаётся один источник, которому можно доверять полностью: собственный замер. Ниже — что измерило каждое крупное исследование, где его выводы перестают работать и план замера для вашей команды.
01 · Четыре цифры — четыре разных вопроса
Чаще всего в 2025–2026 годах цитируют такие результаты:
- На 55,8% быстрее — исследователи Microsoft, GitHub и MIT (эксперимент 2022 года, статья 2023-го): 95 разработчиков-фрилансеров с GitHub Copilot написали HTTP-сервер на JavaScript на 55,8% быстрее контрольной группы.
- На 26% больше завершённых задач — три полевых эксперимента с GitHub Copilot в Microsoft, Accenture и компании из Fortune 100, 4 867 разработчиков (журнал Management Science). Оценка — 26,08% с большой неопределённостью: стандартная ошибка 10,3 пункта.
- На 24% больше принятых пул-реквестов — исследование Microsoft о внедрении Claude Code и GitHub Copilot CLI в начале 2026 года на десятках тысяч инженеров.
- На 19% дольше — рандомизированный эксперимент METR (2025): 16 опытных разработчиков open-source проектов решали реальные задачи на 19% дольше, когда ИИ был разрешён.
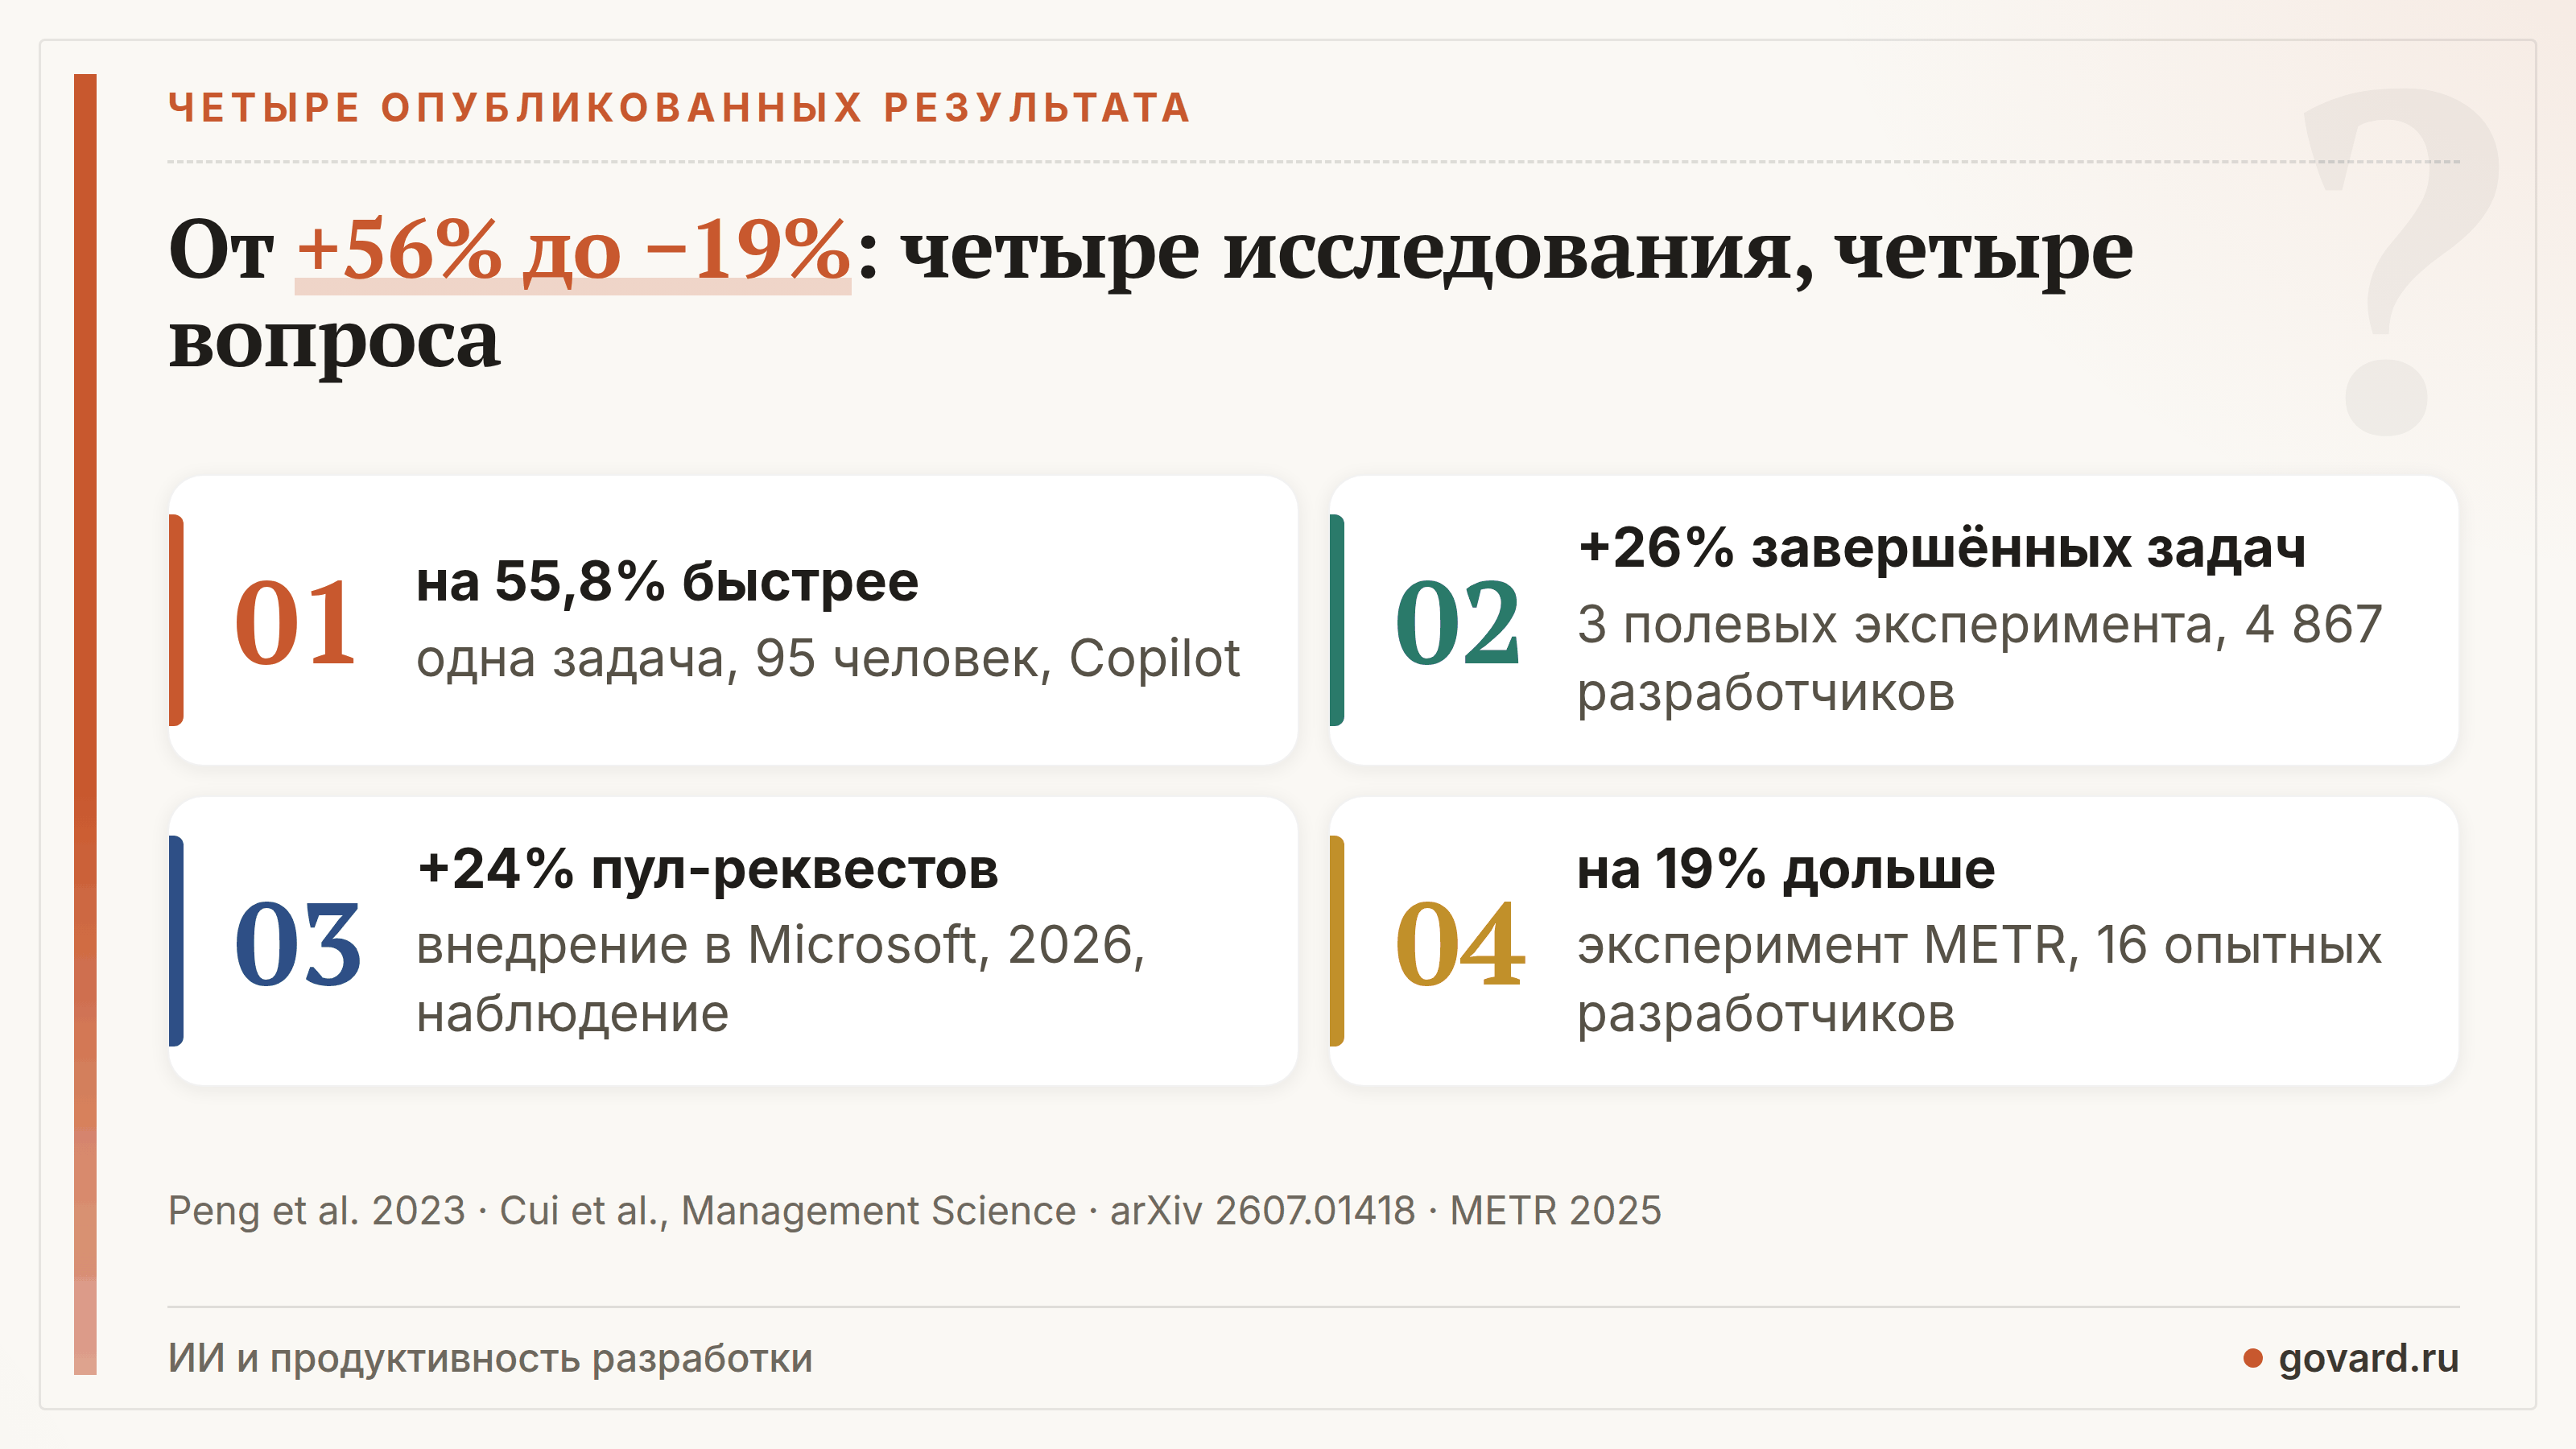
Цифры друг другу не противоречат, потому что меряют разное. Одна — время на одну задачу с нуля, две — количество единиц работы (задачи, пул-реквесты), ещё одна — время на сложные задачи в знакомом коде.
02 · Доказательства бывают разной силы
Прежде чем цитировать любую из этих цифр, проверьте, как её получили. Сначала рандомизированные эксперименты, затем наблюдение и анализ кода, в конце опросы:
| Исследование | Как устроено | Выборка | Результат | О чём может сказать |
|---|---|---|---|---|
| Cui et al. | Три полевых рандомизированных эксперимента, GitHub Copilot | 4 867 разработчиков | +26% завершённых задач | Широко, но «завершённые задачи» — косвенная метрика |
| METR 2025 | Рандомизированный эксперимент на реальных задачах | 16 разработчиков, 246 задач | на 19% дольше | Опытные разработчики, знакомые большие проекты, инструменты начала 2025 года |
| Peng et al. | Контролируемый эксперимент, GitHub Copilot | 95 разработчиков, одна задача | на 55,8% быстрее | Новый код с нуля |
| Внедрение в Microsoft, 2026 | Наблюдение без случайного распределения | десятки тысяч | +24% пул-реквестов | Эффект внедрения; пул-реквест — ещё не ценность |
| GitClear 2026 | Анализ кода, причинность не доказывает | 623 млн изменений | дублирование растёт, рефакторинг падает | Качество кода |
| DORA 2025 | Опрос и интервью | ~5 000 человек | 80%+ чувствуют себя продуктивнее | Ощущения |
| Stack Overflow 2025 | Опрос | ~49 000 человек | 84% используют ИИ, 33% доверяют точности | Распространённость и доверие |
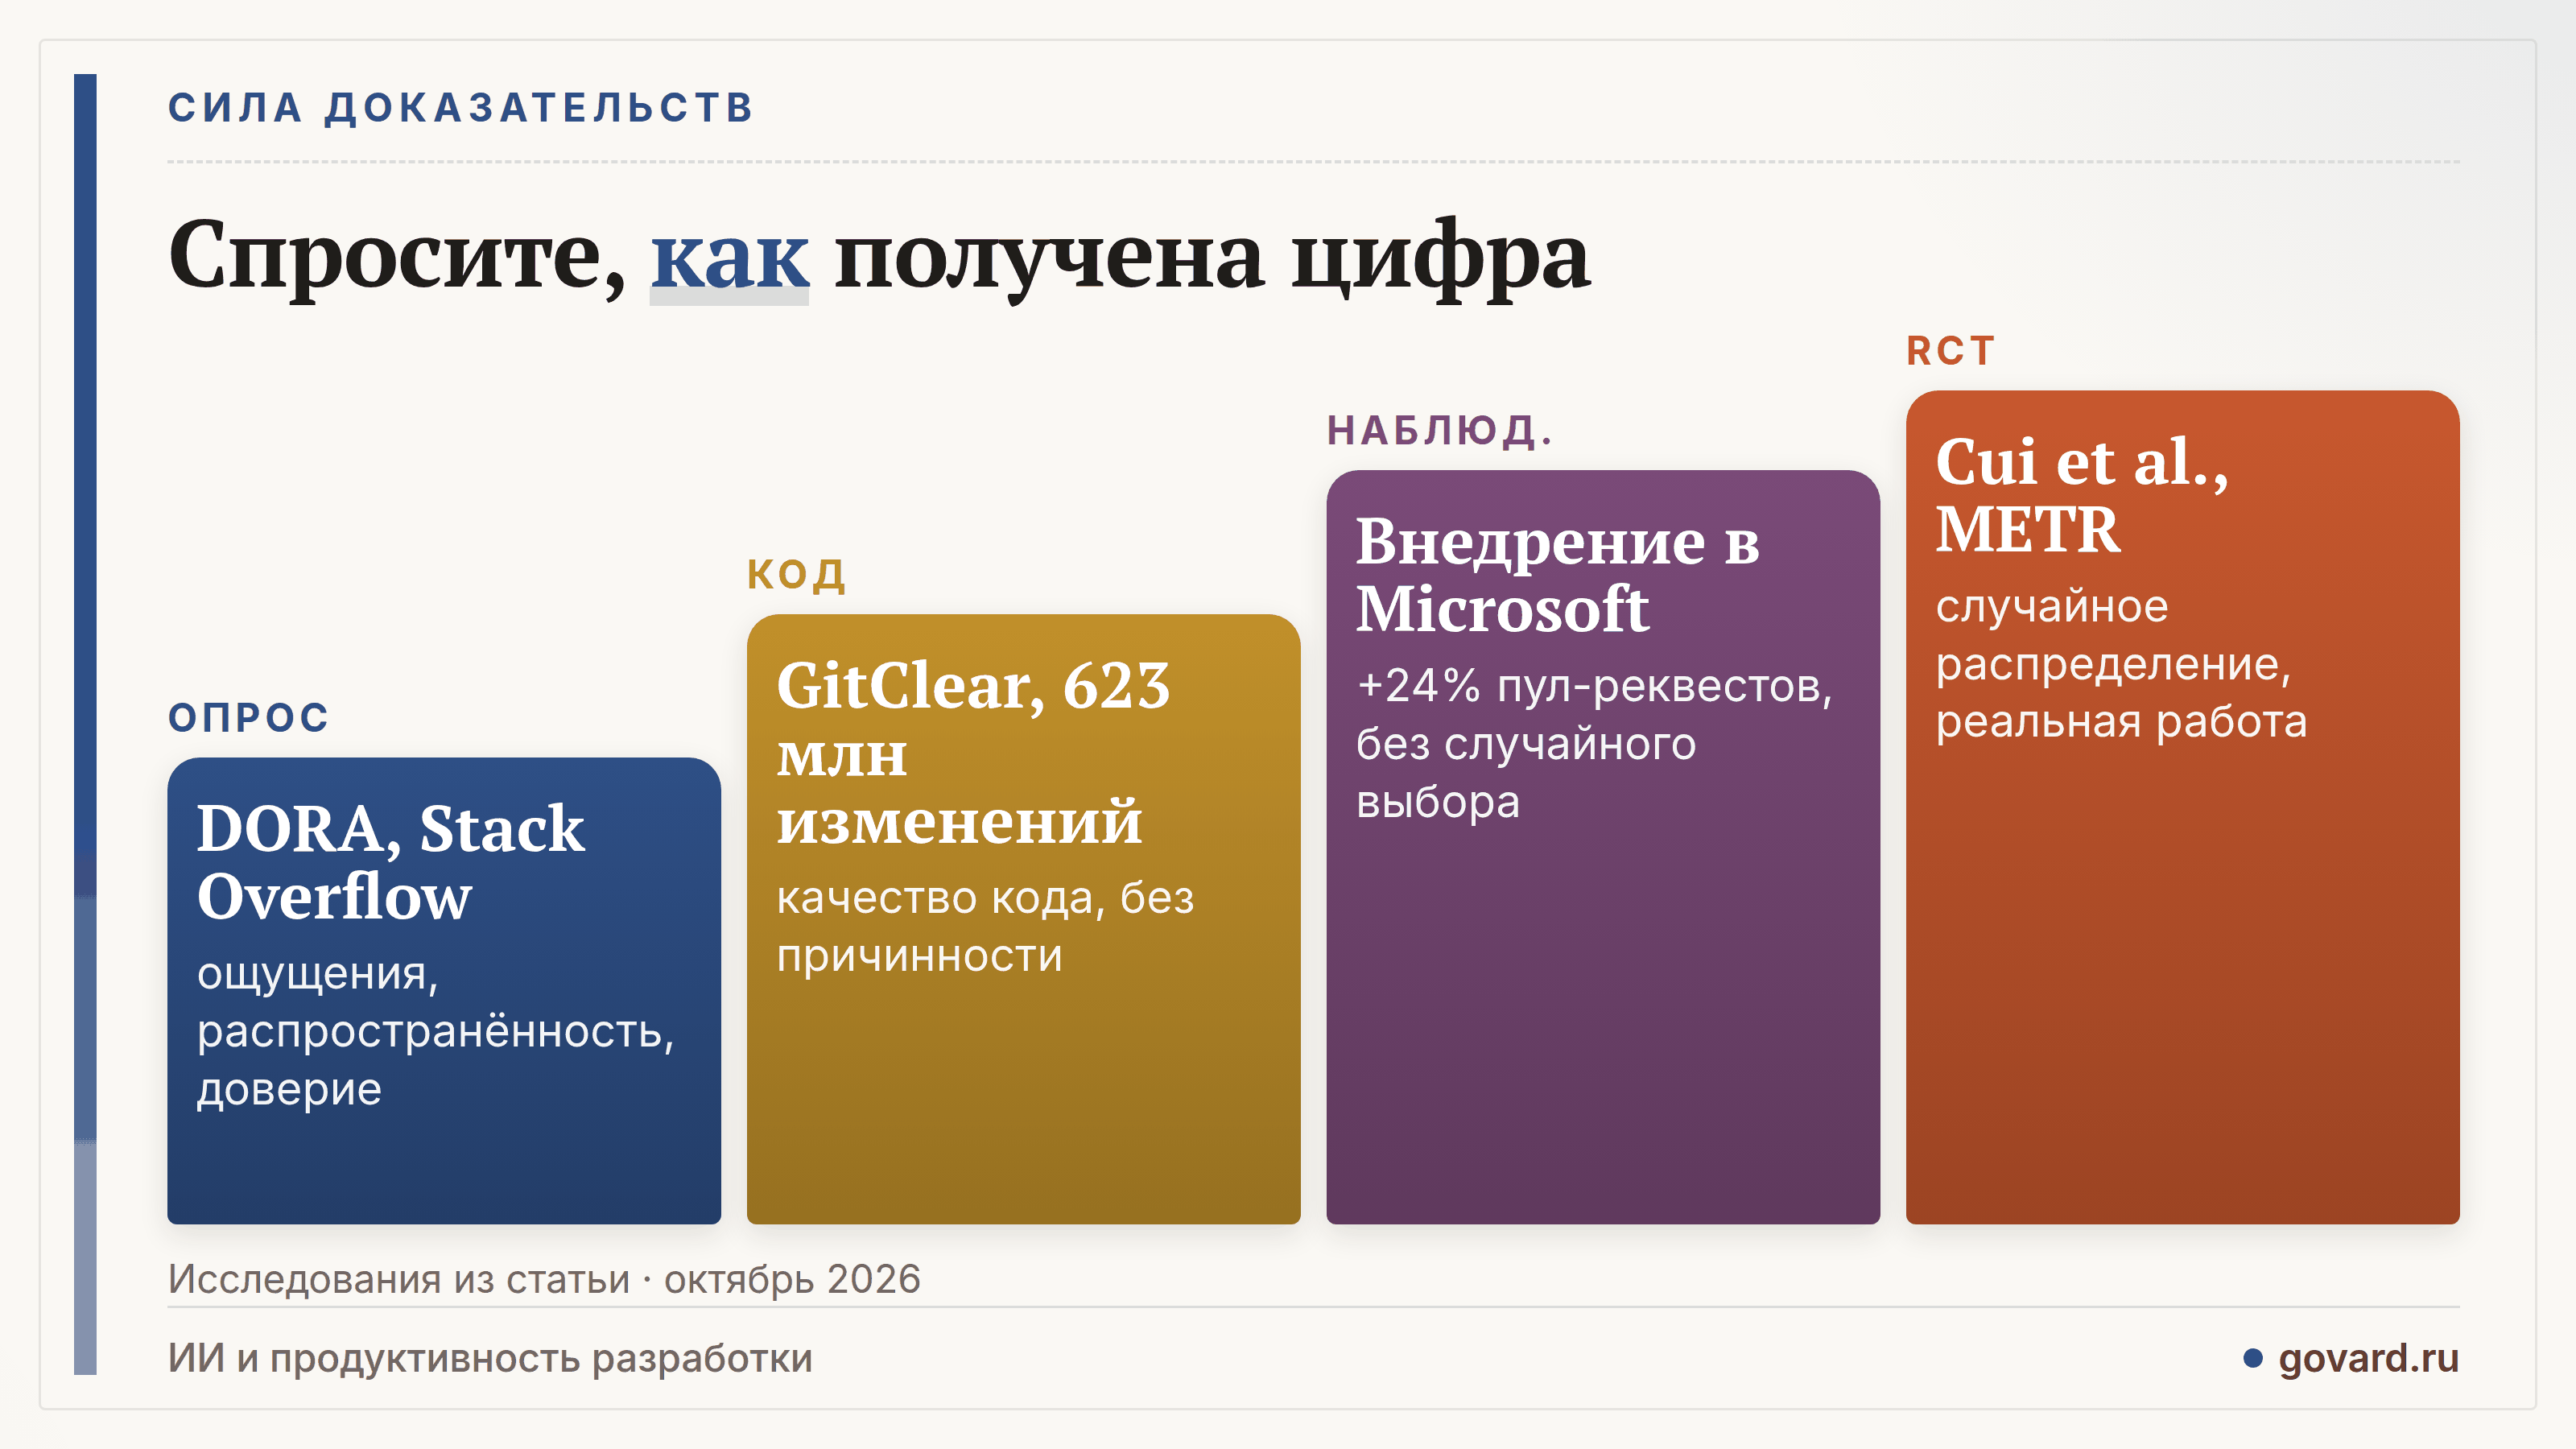
Авторы исследования Microsoft сами называют предел своей цифры: принятый пул-реквест и ценность, которую он приносит, — разные вещи. Работа Cui et al. и исследование внедрения связаны с одной компанией, поэтому полностью независимым подтверждением друг друга их не назвать.
03 · METR: работали медленнее и были уверены, что быстрее
Исследование METR цитируют чаще всех, и оно самое узкое. Шестнадцать опытных разработчиков, которые сопровождают крупные open-source проекты (в среднем 22 тыс.+ звёзд на GitHub и больше миллиона строк кода), решали 246 реальных задач примерно по два часа каждая. Каждую задачу случайно относили к группе «ИИ можно» или «ИИ нельзя». Инструменты — в основном Cursor Pro с Claude 3.5 и 3.7.
«Когда разработчикам разрешают пользоваться ИИ-инструментами, они решают задачи на 19% дольше». — METR, июль 2025
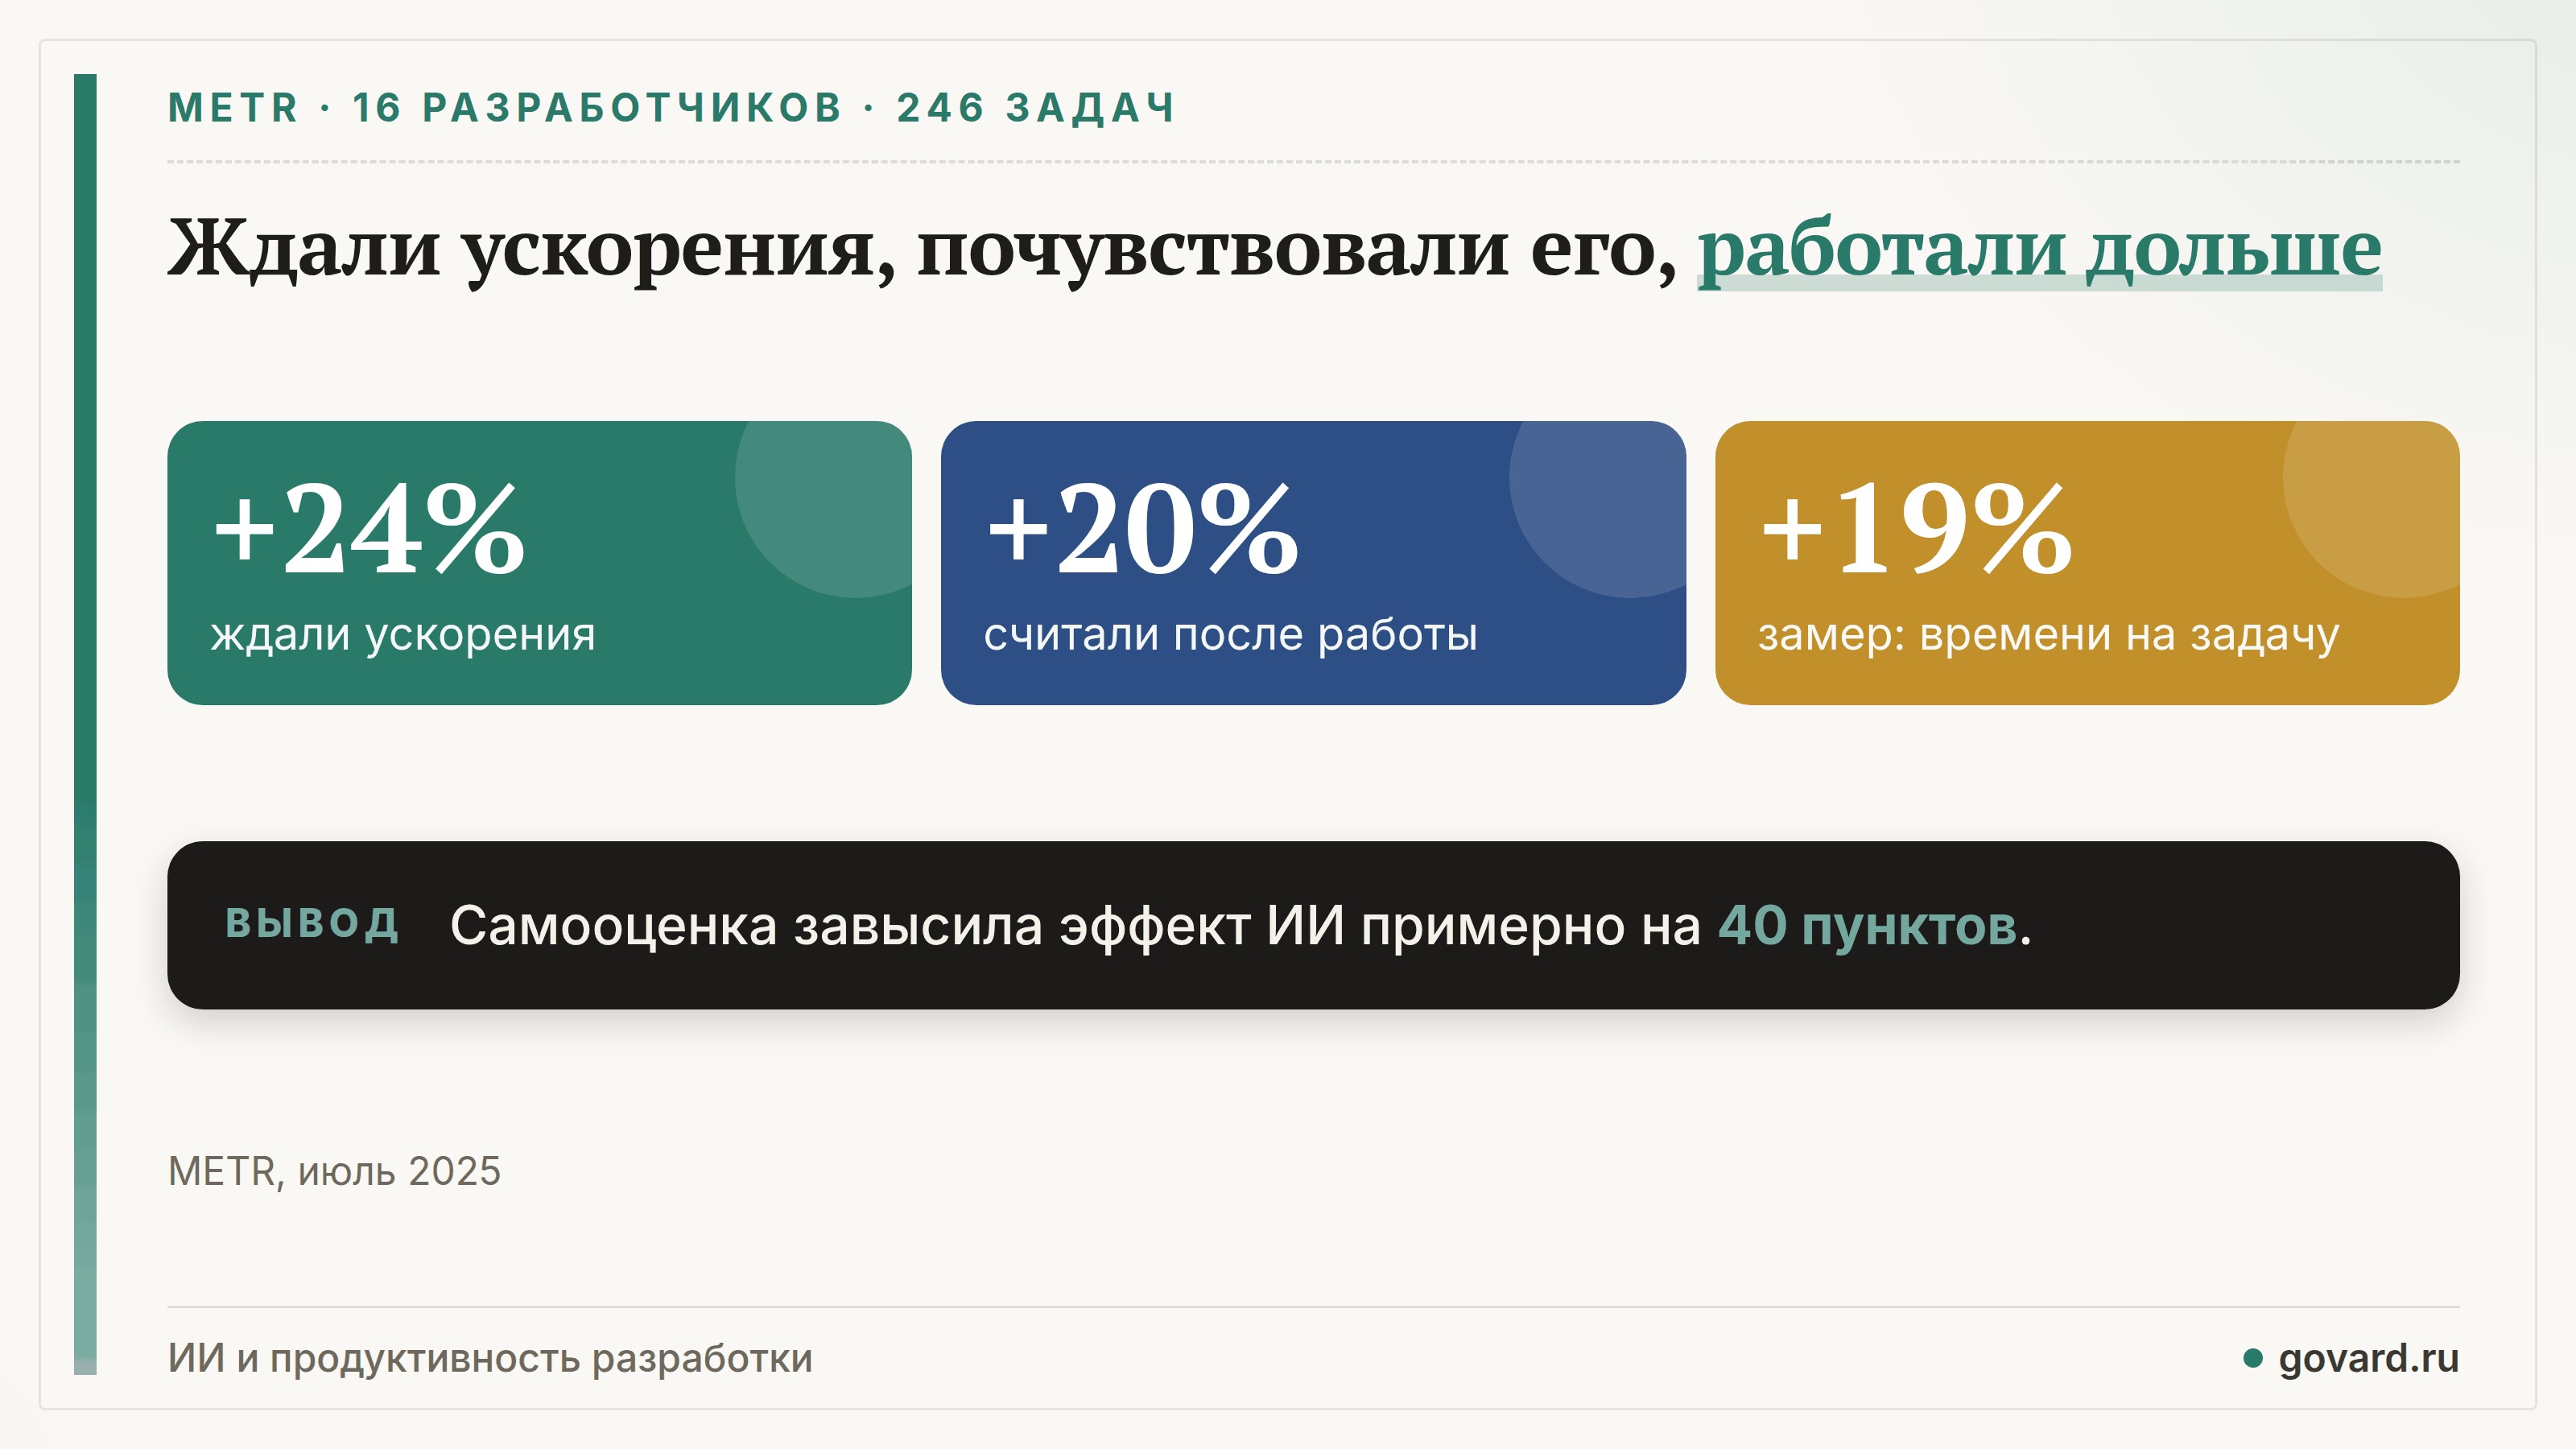
Для руководителя важнее вторая находка. До эксперимента разработчики ждали ускорения на 24%. После выполнения задач они всё ещё считали, что ИИ ускорил их на 20%.
METR сам ограничивает вывод. Авторы называют результат снимком возможностей ИИ начала 2025 года в одной конкретной ситуации. Они допускают, что ИИ помогает менее опытным разработчикам и тем, кто работает в незнакомом коде, и что эффект обучения может проявиться только после нескольких сотен часов использования. У участников было несколько десятков часов работы с Cursor.
04 · Почему второй эксперимент METR дал ненадёжный результат
В августе 2025 года METR начал второй эксперимент: 10 разработчиков из первого исследования и 47 новых, а оплату снизили со $150 до $50 в час. В феврале 2026 года команда написала, что новые данные дают ненадёжный сигнал. Одна из причин — отбор: 30–50% опрошенных участников признались, что не отдавали в эксперимент часть задач, которые не хотели делать без ИИ. По оценке METR, это касается меньшинства разработчиков и задач.
По сырым данным вернувшиеся участники работали примерно на 18% быстрее (доверительный интервал — от 38% быстрее до 9% медленнее), новые — примерно на 4% быстрее (от 15% быстрее до 9% медленнее). Оба интервала включают ноль. METR считает результат нижней границей и меняет схему исследования.
Эта неудача — тоже данные. За год заметная часть опытных разработчиков перестала считать «без ИИ» приемлемым условием для задач, где ждёт от него больше всего помощи.
Опрос METR февраля–апреля 2026 года (349 технических специалистов) показывает другую сторону: по самооценке медианное ускорение — в 3 раза, ценность работы выросла в 1,4–2 раза. METR сразу напоминает свой вывод 2025 года: самооценка влияния ИИ на время расходилась с замером в среднем на 40 процентных пунктов.
05 · Что цифры скорости не показывают
Исследования скорости считают задачи, пул-реквесты или часы. Две другие метрики меняют картину.
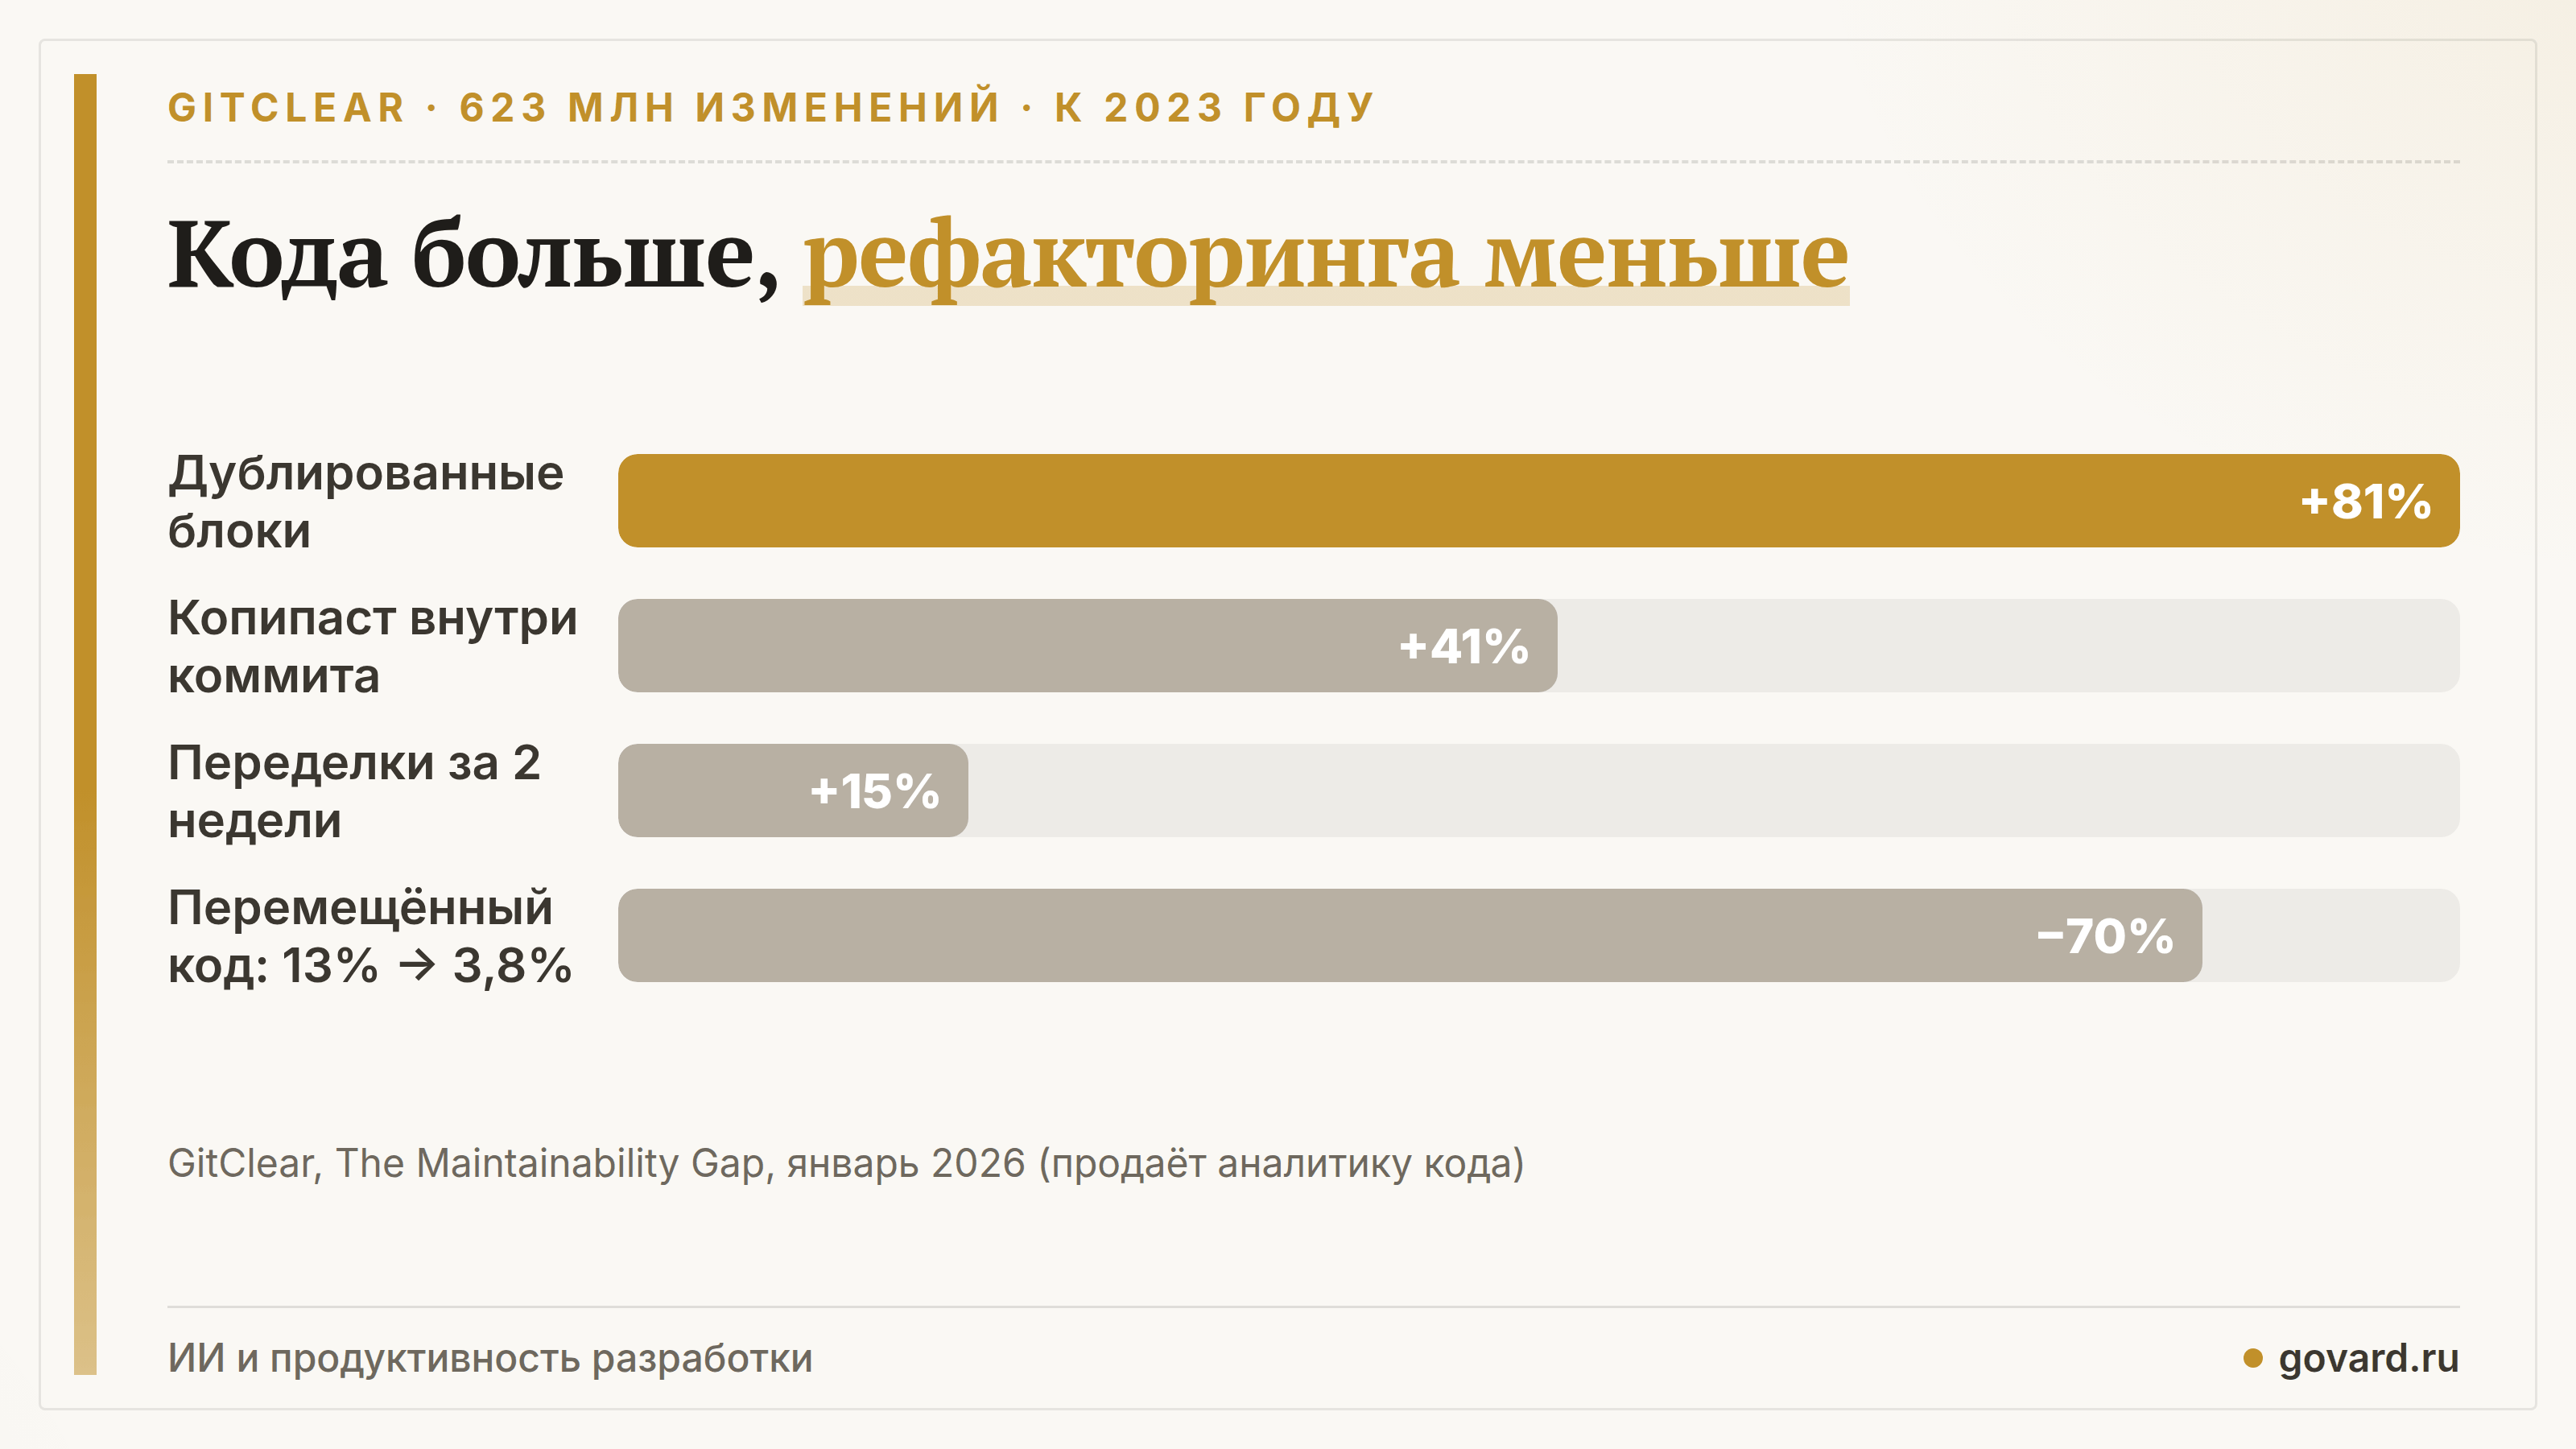
Качество кода. GitClear проанализировал 623 млн изменений кода за 2023–2026 годы. По сравнению с 2023 годом:
- дублированных блоков кода стало на 81% больше;
- копипаста внутри одного коммита — на 41% больше;
- кода, переписанного в течение двух недель после появления, — на 15% больше;
- доля кода, перемещённого при рефакторинге, упала с 13% до 3,8% изменённых строк, то есть примерно на 70%; вызовов функций из других файлов стало на 35% меньше.
Ещё одно наблюдение GitClear: активные пользователи ИИ пишут в 4–10 раз больше кода, чем те, кто им не пользуется, а по сравнению с собственным уровнем до ИИ прирост — около 25%. Разница между людьми и эффект инструмента — разные величины. GitClear продаёт аналитику кода: подсчёты объективны, а трактовка («разрыв в сопровождаемости») — позиция компании.
Доверие. В опросе Stack Overflow 2025 года использование и доверие расходятся: ИИ-инструментами пользуются или собираются пользоваться 84% (годом раньше 76%), а доверие к их точности упало с 43% до 33%, активно не доверяют 46%. В DORA 2025: ИИ на работе используют 90%, а 30% почти или совсем не доверяют коду от ИИ — чуть меньше, чем годом раньше. Главная мысль отчёта DORA: ИИ усиливает то, что в команде уже есть. Сильная инженерная практика становится сильнее, слабая — производит больше кода с теми же проблемами.
06 · Что видно по России
Сопоставимых по масштабу исследований эффекта по российским компаниям в открытом доступе нет, но есть цифры внедрения. Яндекс поставил цель на 2026 год «75/75/75»: не меньше 75% разработчиков регулярно используют ИИ, ИИ участвует не меньше чем в 75% изменений, и в каждом таком изменении не меньше 75% кода генерирует ИИ. На момент публикации цели ИИ регулярно использовали 73% разработчиков компании, а в режиме «ИИ в 75% изменений» работали 17,2%.
Это метрики распространённости, а не эффекта. Цифры эффекта в том же разборе точечные: в отдельных спринтах Яндекс Лавки скорость разработки выросла в 3,3 раза, в Яндекс Браузере новую архитектуру перевода видео сделали за два дня вместо двух-трёх недель. Это хороший материал для вопроса из следующего раздела: что именно мерили, на каких задачах и с чем сравнивали.
07 · Как измерить эффект в своей команде
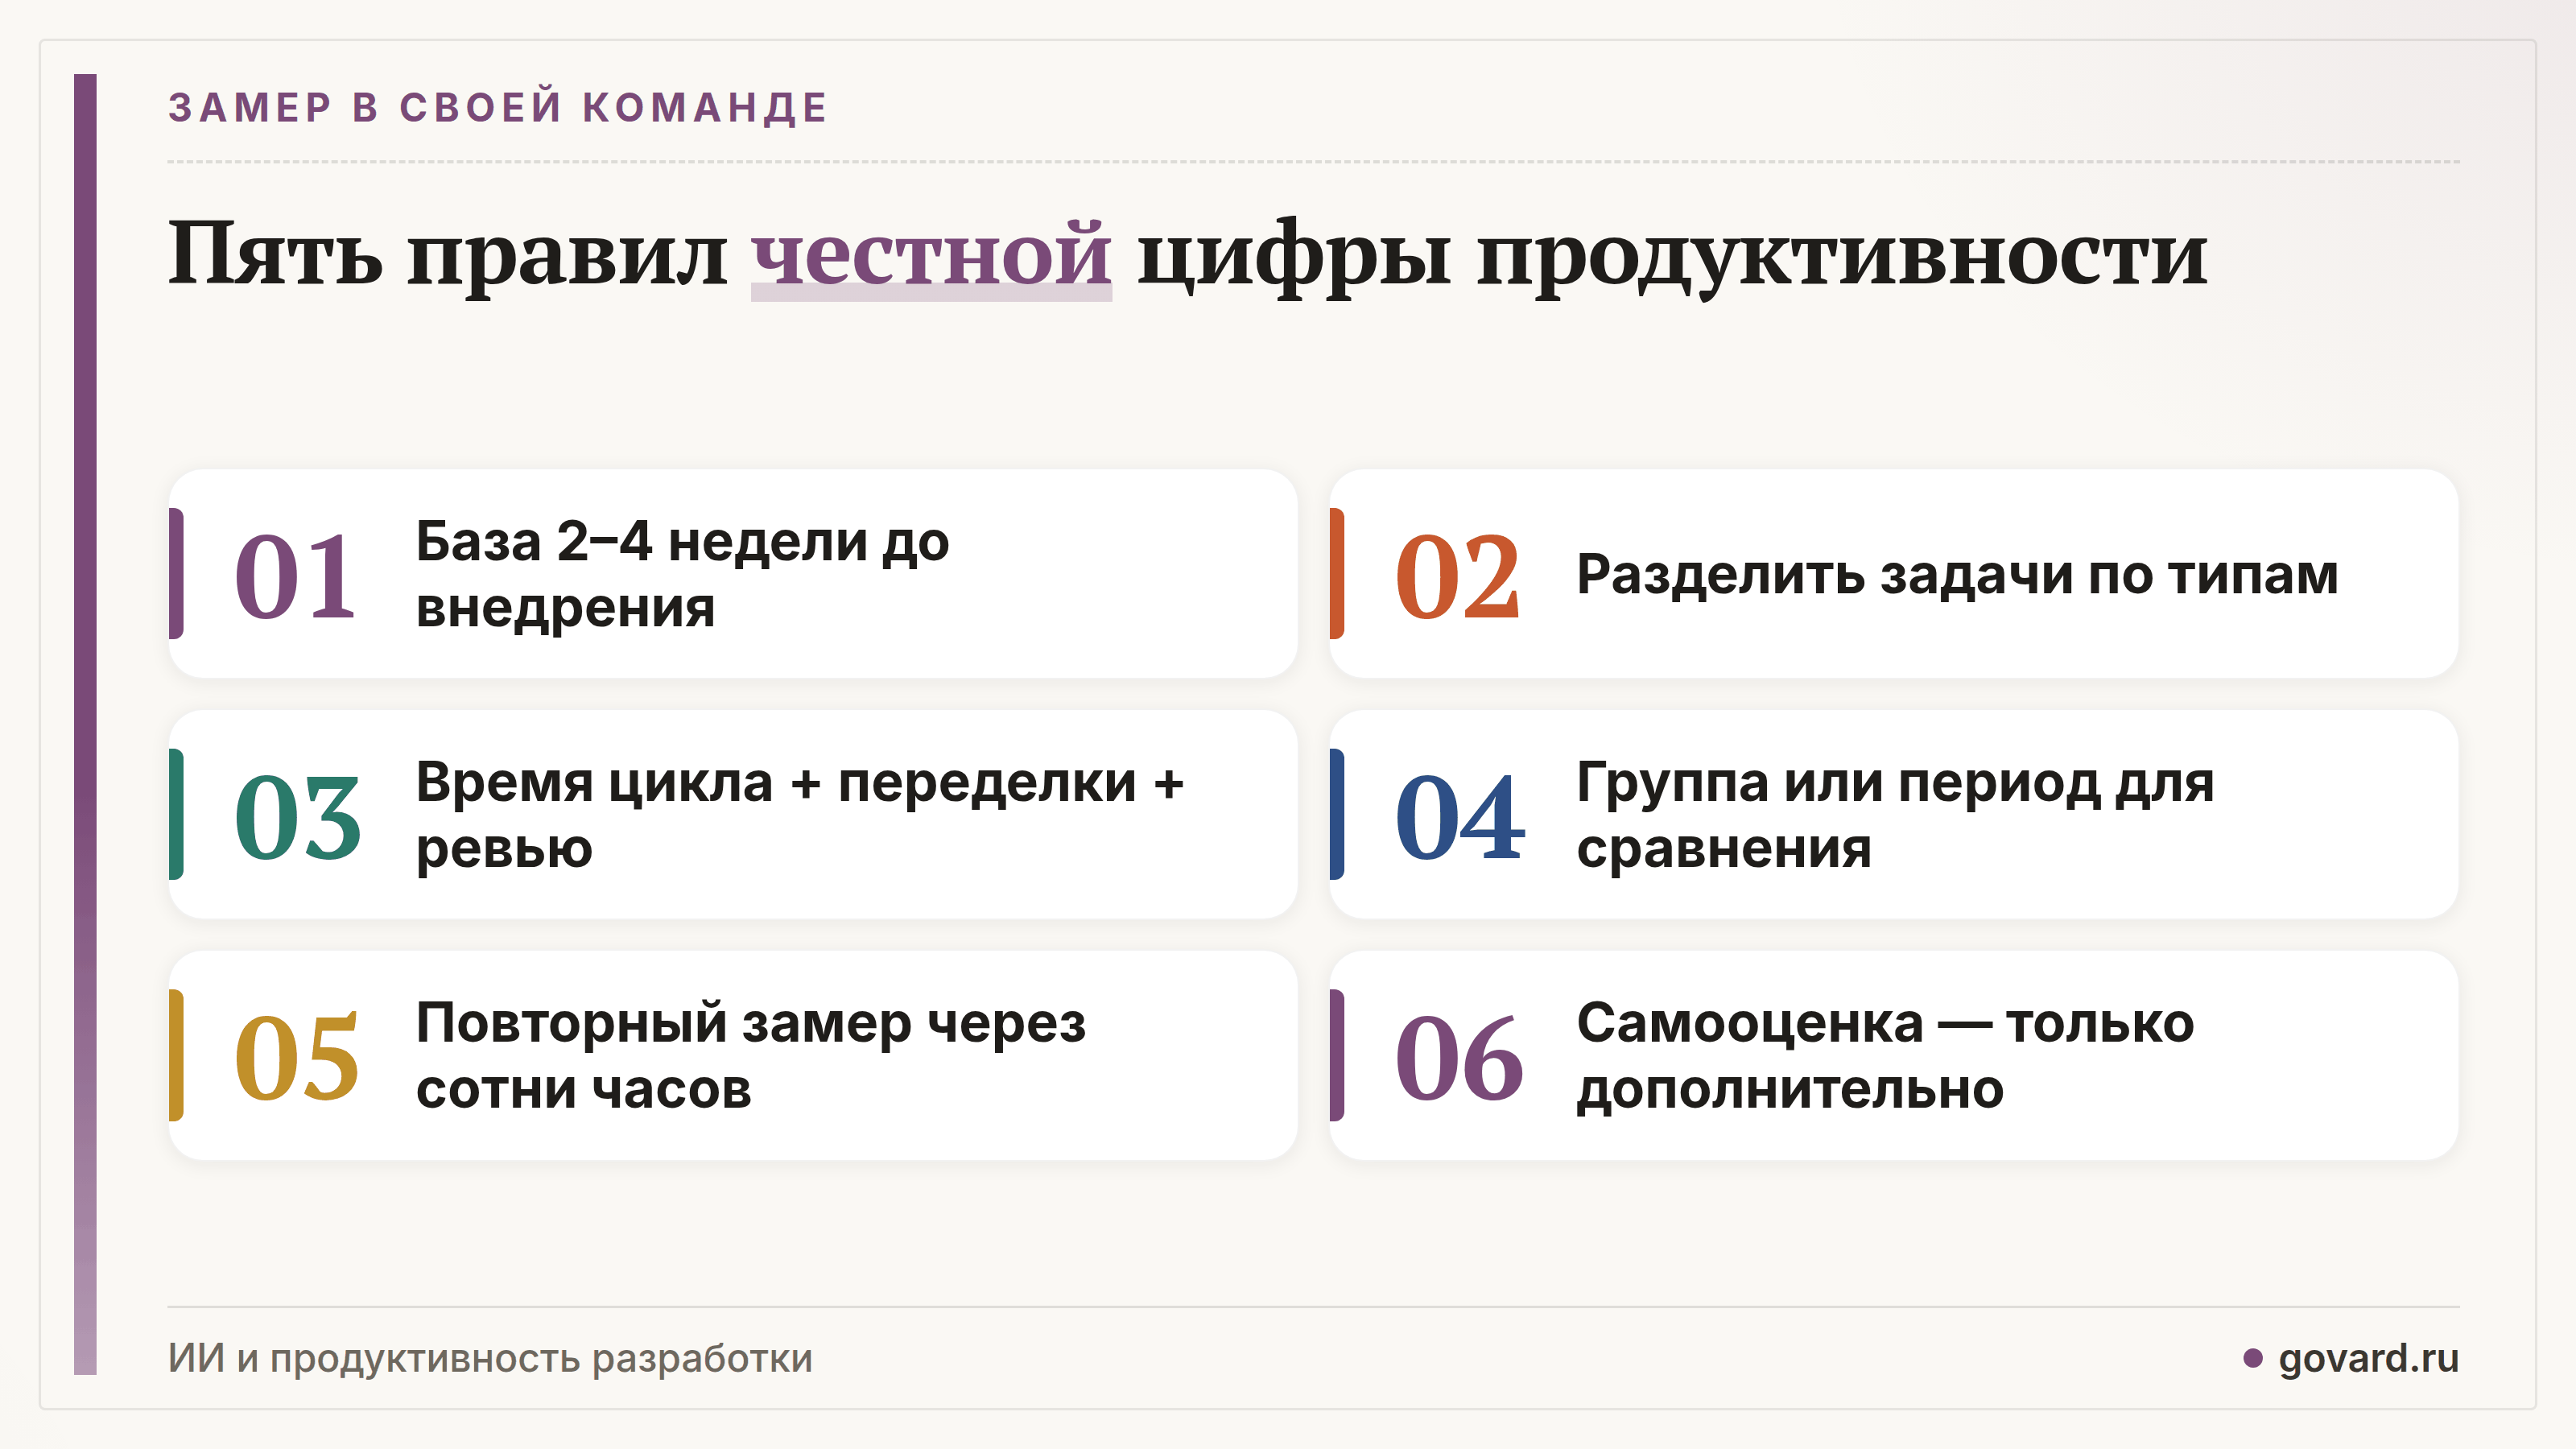
Раз исследования расходятся, полезнее всего провести небольшой замер у себя. План, который обходит частые ловушки:
- Сначала базовые цифры. Снимите текущие показатели за две–четыре недели до внедрения. Без базы любая цифра после — это ощущение.
- Разделите задачи по типам. Новый сервис с нуля, исправление ошибок в старом коде, миграции, тесты и ревью ведут себя по-разному. Замедление в METR и ускорение у Peng — на противоположных концах этого списка.
- Считайте скорость вместе с ценой изменений. Время цикла задачи — вместе с переделками в течение двух недель, временем ревью на пул-реквест и ошибками, найденными после релиза. Больше пул-реквестов при более долгом ревью и росте переделок — это не выигрыш.
- Возьмите группу для сравнения. Команда, период или набор задач без инструмента. Самооценку используйте только как дополнительный сигнал: в METR она разошлась с замером на 40 пунктов.
- Повторите замер через несколько сотен часов. Навык работы с инструментом растёт не сразу, поэтому цифра первого месяца может ошибаться в любую сторону.
Замер лучше работает рядом с практикой, которая держит результат под контролем. В моих текущих проектах мы работаем по процессу, где ИИ — основной инструмент разработки: письменные спецификации, разработка через тесты и кодинг-агенты под надзором по правилам репозитория и с проверками перед релизом. В Стройинтеллекте (strintel.ru) — системе ИИ-проверки сметной документации — код проверяют около 2 000 автотестов. В AgenticCRM (aigentos.tech), агентной CRM с чатом в центре, отдельный шаг автоматической проверки (CI) пропускает новые тесты только после подтверждения человеком, поэтому набор тестов остаётся решением человека. Агент пишет код, тесты и проверки решают, правильный ли он. Так «усилитель» из отчёта DORA выглядит в ежедневной работе.
08 · Какую цифру нести руководству
Когда вам называют цифру, спросите, что именно мерили:
- «ИИ ускоряет разработчиков на 55%». Одна задача с нуля, 95 разработчиков, 2022 год. Годится для нового кода, слабо говорит о зрелом проекте.
- «Команды завершают на 26% больше задач». Полевые эксперименты почти на 5 000 разработчиков. Сильная схема, большая неопределённость, задачи разного размера: уточните, учитывали ли время ревью и переделок.
- «У начавших пользоваться инструментом на 24% больше принятых пул-реквестов». Наблюдение. Уточните, как сравнивали тех, кто начал, с теми, кто нет.
- «ИИ замедляет экспертов на 19%». Сильная схема, узкая ситуация, инструменты начала 2025 года. Второй эксперимент показывает, что ситуация уже другая.
- «В отдельных спринтах скорость выросла в 3,3 раза». Точечный результат команды. Уточните, какие задачи и с каким периодом сравнивали.
- «Активные пользователи пишут в 4–10 раз больше кода». Сравнение людей между собой, а не эффект инструмента.
- «80% разработчиков чувствуют себя продуктивнее». Ощущения. Участники измеренного эксперимента ошиблись примерно на 40 пунктов.
Формулировка для презентации руководству в 2026 году, которую можно защитить: опубликованные исследования дают разброс от работы на 19% дольше до ускорения на 56% в зависимости от задачи и метрики; наш собственный замер с базой и группой сравнения за квартал покажет, где находится наша команда. Та же дисциплина для агентов, которых вы выпускаете в продукт, — в статье о проверке ИИ-агентов.
Что сейчас считает ваша команда разработки: пул-реквесты, время цикла или что-то ближе к ценности для бизнеса?