Как проверить ИИ-агента до запуска: 75% успеха на запуск — это 42% на трёх запусках подряд
Оценка ИИ-агентов (эвалы) на практике: почему успешное демо ничего не гарантирует, что такое pass^k, как проверять результат вместо ответа, как настроить LLM-судью и что спросить у подрядчика.
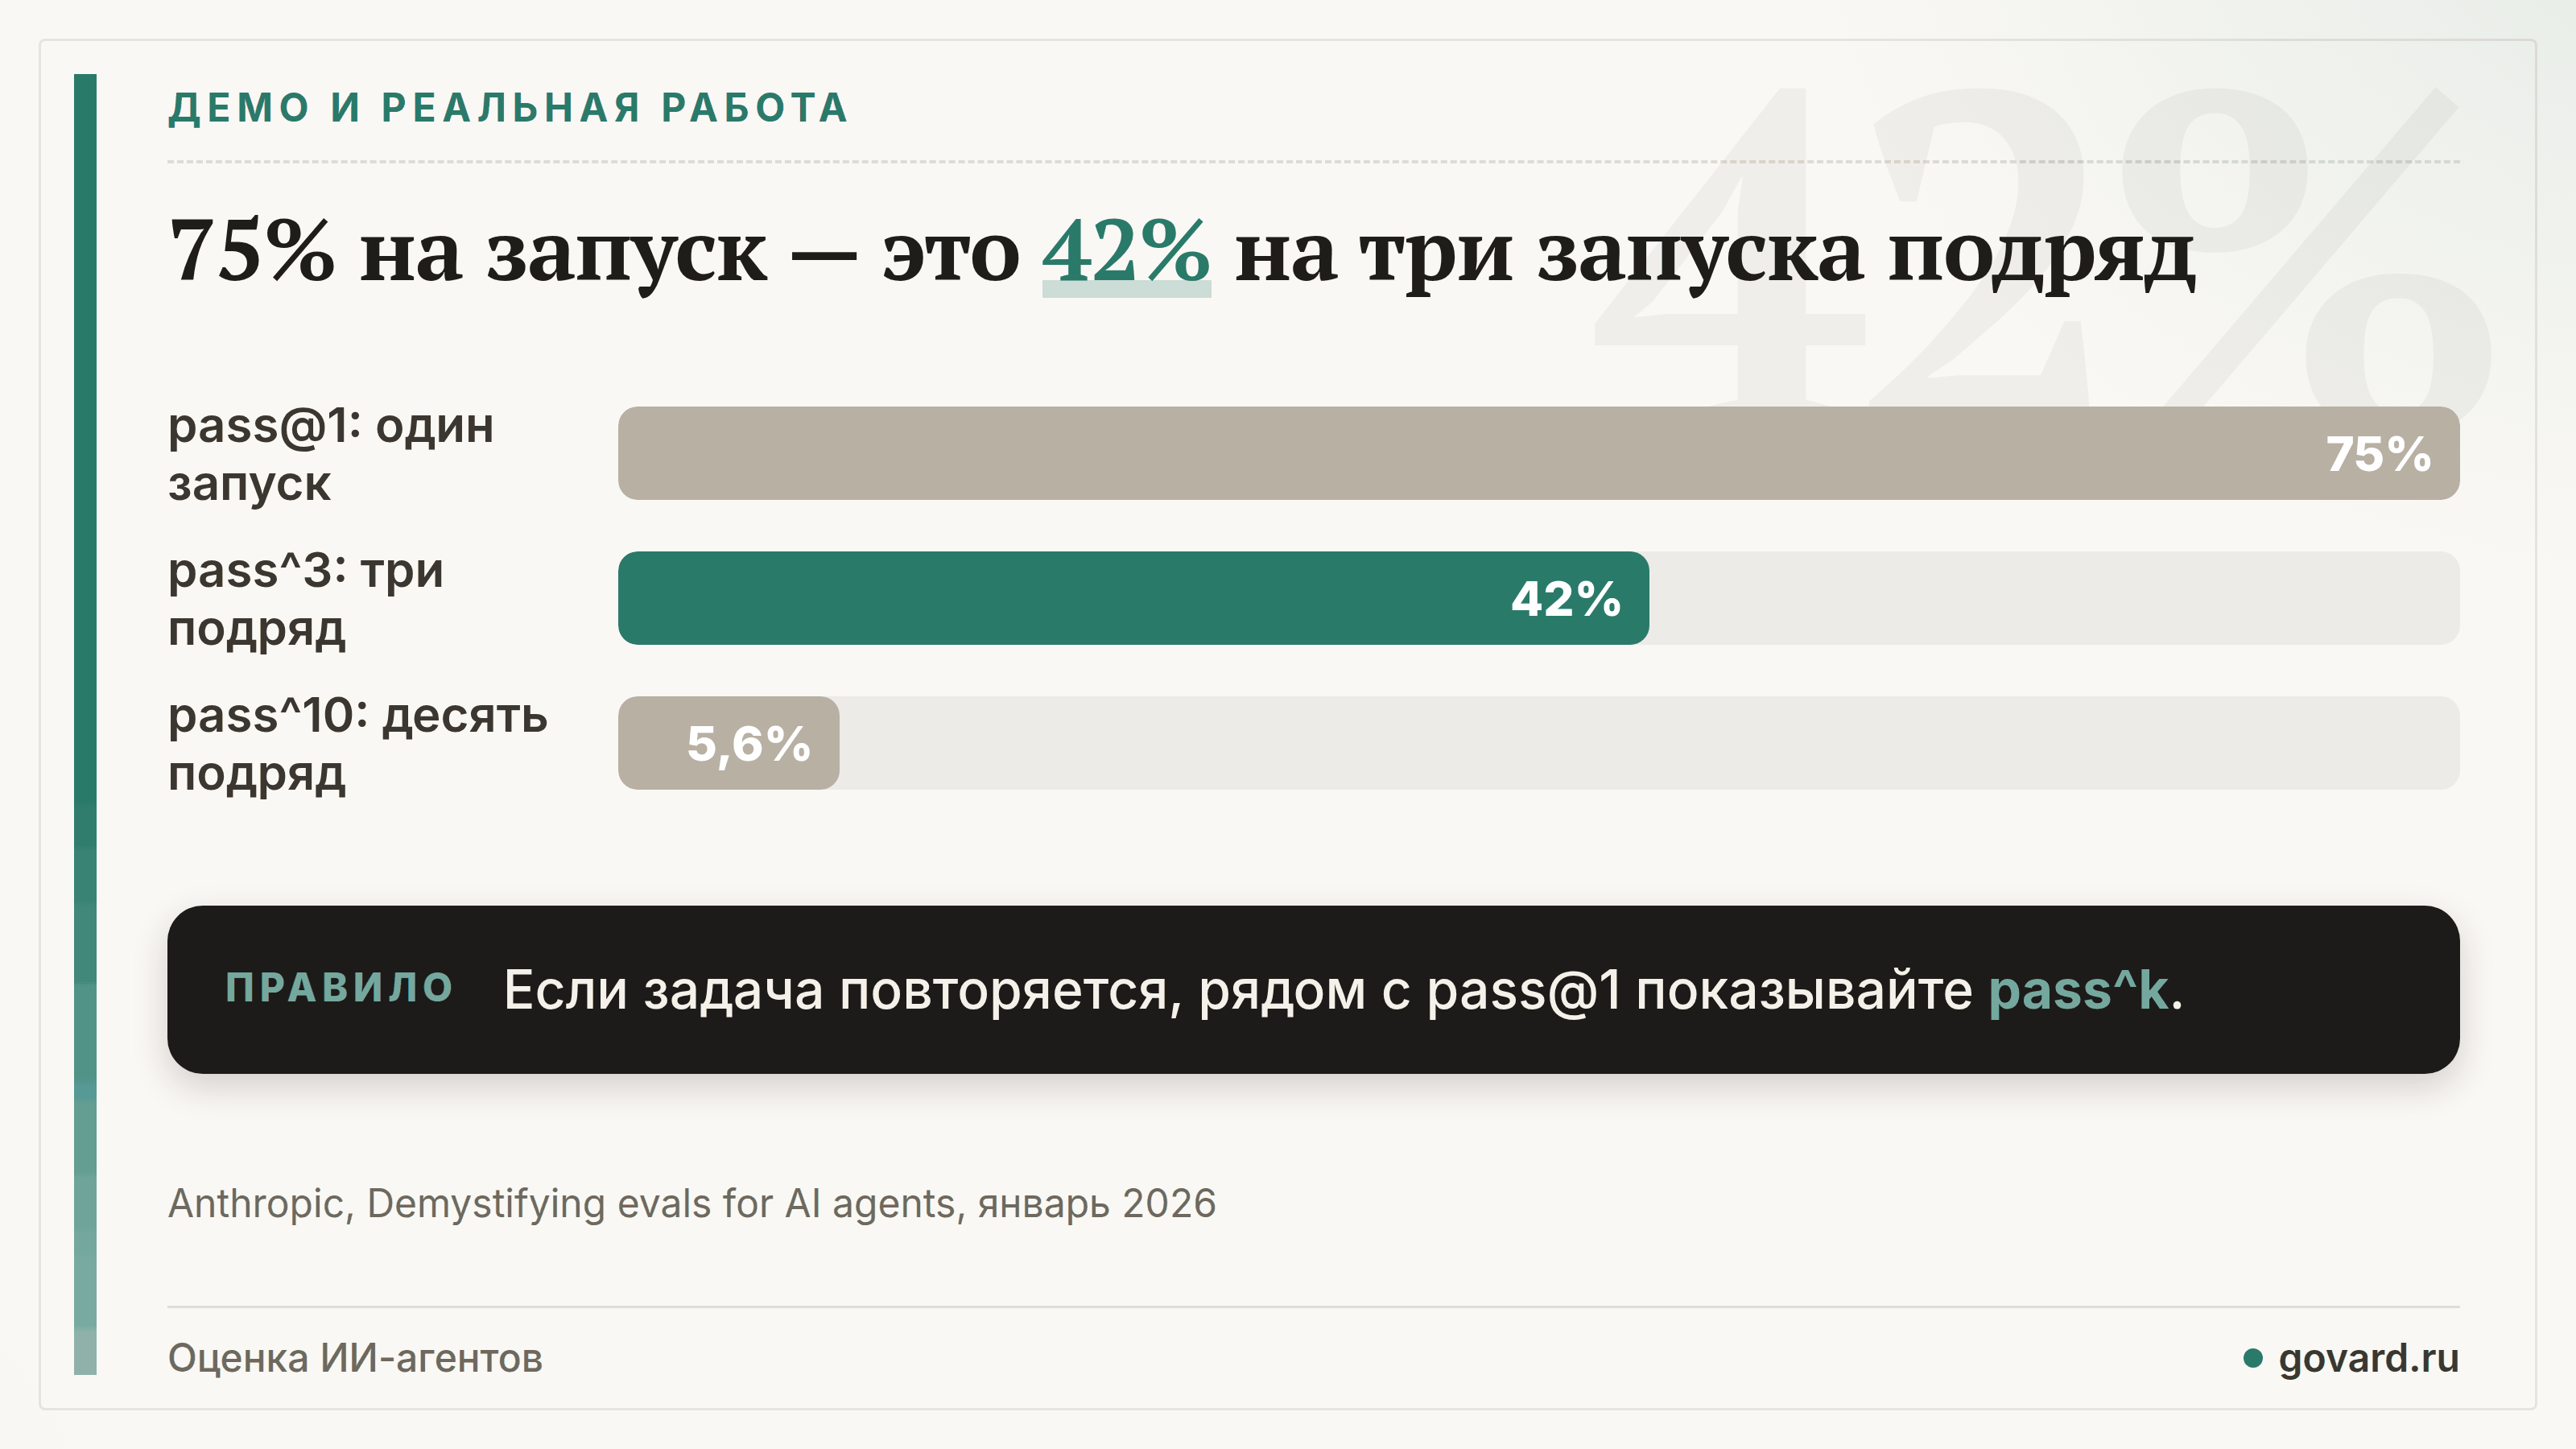
Если ИИ-агент справляется с задачей в 75% запусков, три запуска подряд он пройдёт примерно в 42% случаев. Anthropic приводит этот расчёт для агентов, которые работают с клиентами: пользователь ждёт одинакового результата каждый раз. Тот же расчёт объясняет, почему удачное демо почти ничего не говорит об агенте в работе: демо показывает один успех, а бизнес запускает ту же задачу сотни раз.
Для оценки ИИ-агента до запуска нужны четыре вещи: 20–50 настоящих задач, несколько запусков каждой, проверка того, что агент изменил в системе, и LLM-судья, сверенный с человеком. Ниже — как устроена каждая часть, где у неё границы и какие вопросы задать подрядчику до подписания акта.
01 · Демо показывает удачный запуск
Демо у вендора, скриншот пилота и большинство цифр в рейтингах моделей отвечают на один вопрос: решил ли агент задачу хотя бы раз. В терминах оценки это pass@1, а если показывают лучший из нескольких вариантов — pass@k.
В работе вопрос другой. Ответы клиентам, проверка документов, обновление сделок в CRM повторяются каждый день, и каждая ошибка — это инцидент. Для этого нужна метрика pass^k: вероятность, что успешны все k попыток. Её ввели в 2024 году авторы бенчмарка τ-bench для агентов, которые общаются с клиентами и меняют данные.
Две метрики быстро расходятся. Если доля успешных запусков равна p, то pass^k = p^k:
- 75% на запуск → 42% на три запуска подряд → меньше 6% на десять;
- pass@k ведёт себя наоборот и с ростом k приближается к 100%.
Свежие данные показывают этот разрыв на рабочих сценариях. В исследовании Thinkingbox (arXiv, август 2026) каждую из 507 задач с регламентами запускали 20 раз. Лучшая модель, Claude Opus 5, решила 66,5% задач с первой попытки и 47,5% — во всех двадцати. У Qwen3.8-27B разрыв больше: 51,7% с первой попытки, 89,4% — хотя бы в одной из двадцати и 10,9% — во всех двадцати. Авторы пишут прямо: повторные попытки находят удачные траектории, но надёжной работы не дают.
Правило: если задача повторяется, рядом с pass@1 показывайте pass^k. Если подрядчик показывает только лучший из N вариантов, просите процент успеха одного запуска.
02 · Из чего состоит проверка агента
Чтобы pass^k стал частью процесса, нужны несколько частей с понятными названиями. Инженеры Anthropic называют их так:
- Задача: входные данные, среда и критерий успеха.
- Попытка: один запуск задачи. Агент каждый раз действует немного по-разному, поэтому попыток несколько.
- Проверка (грейдер): код (тесты, точное совпадение, итоговое состояние), модель (рубрика, сравнение вариантов) или человек.
- Журнал шагов (транскрипт): все шаги, вызовы инструментов и промежуточные результаты. По нему видно, ошибся агент или проверка отклонила верное решение.
- Обвязка (харнесс): код, который запускает задачи, хранит журналы и считает метрики.
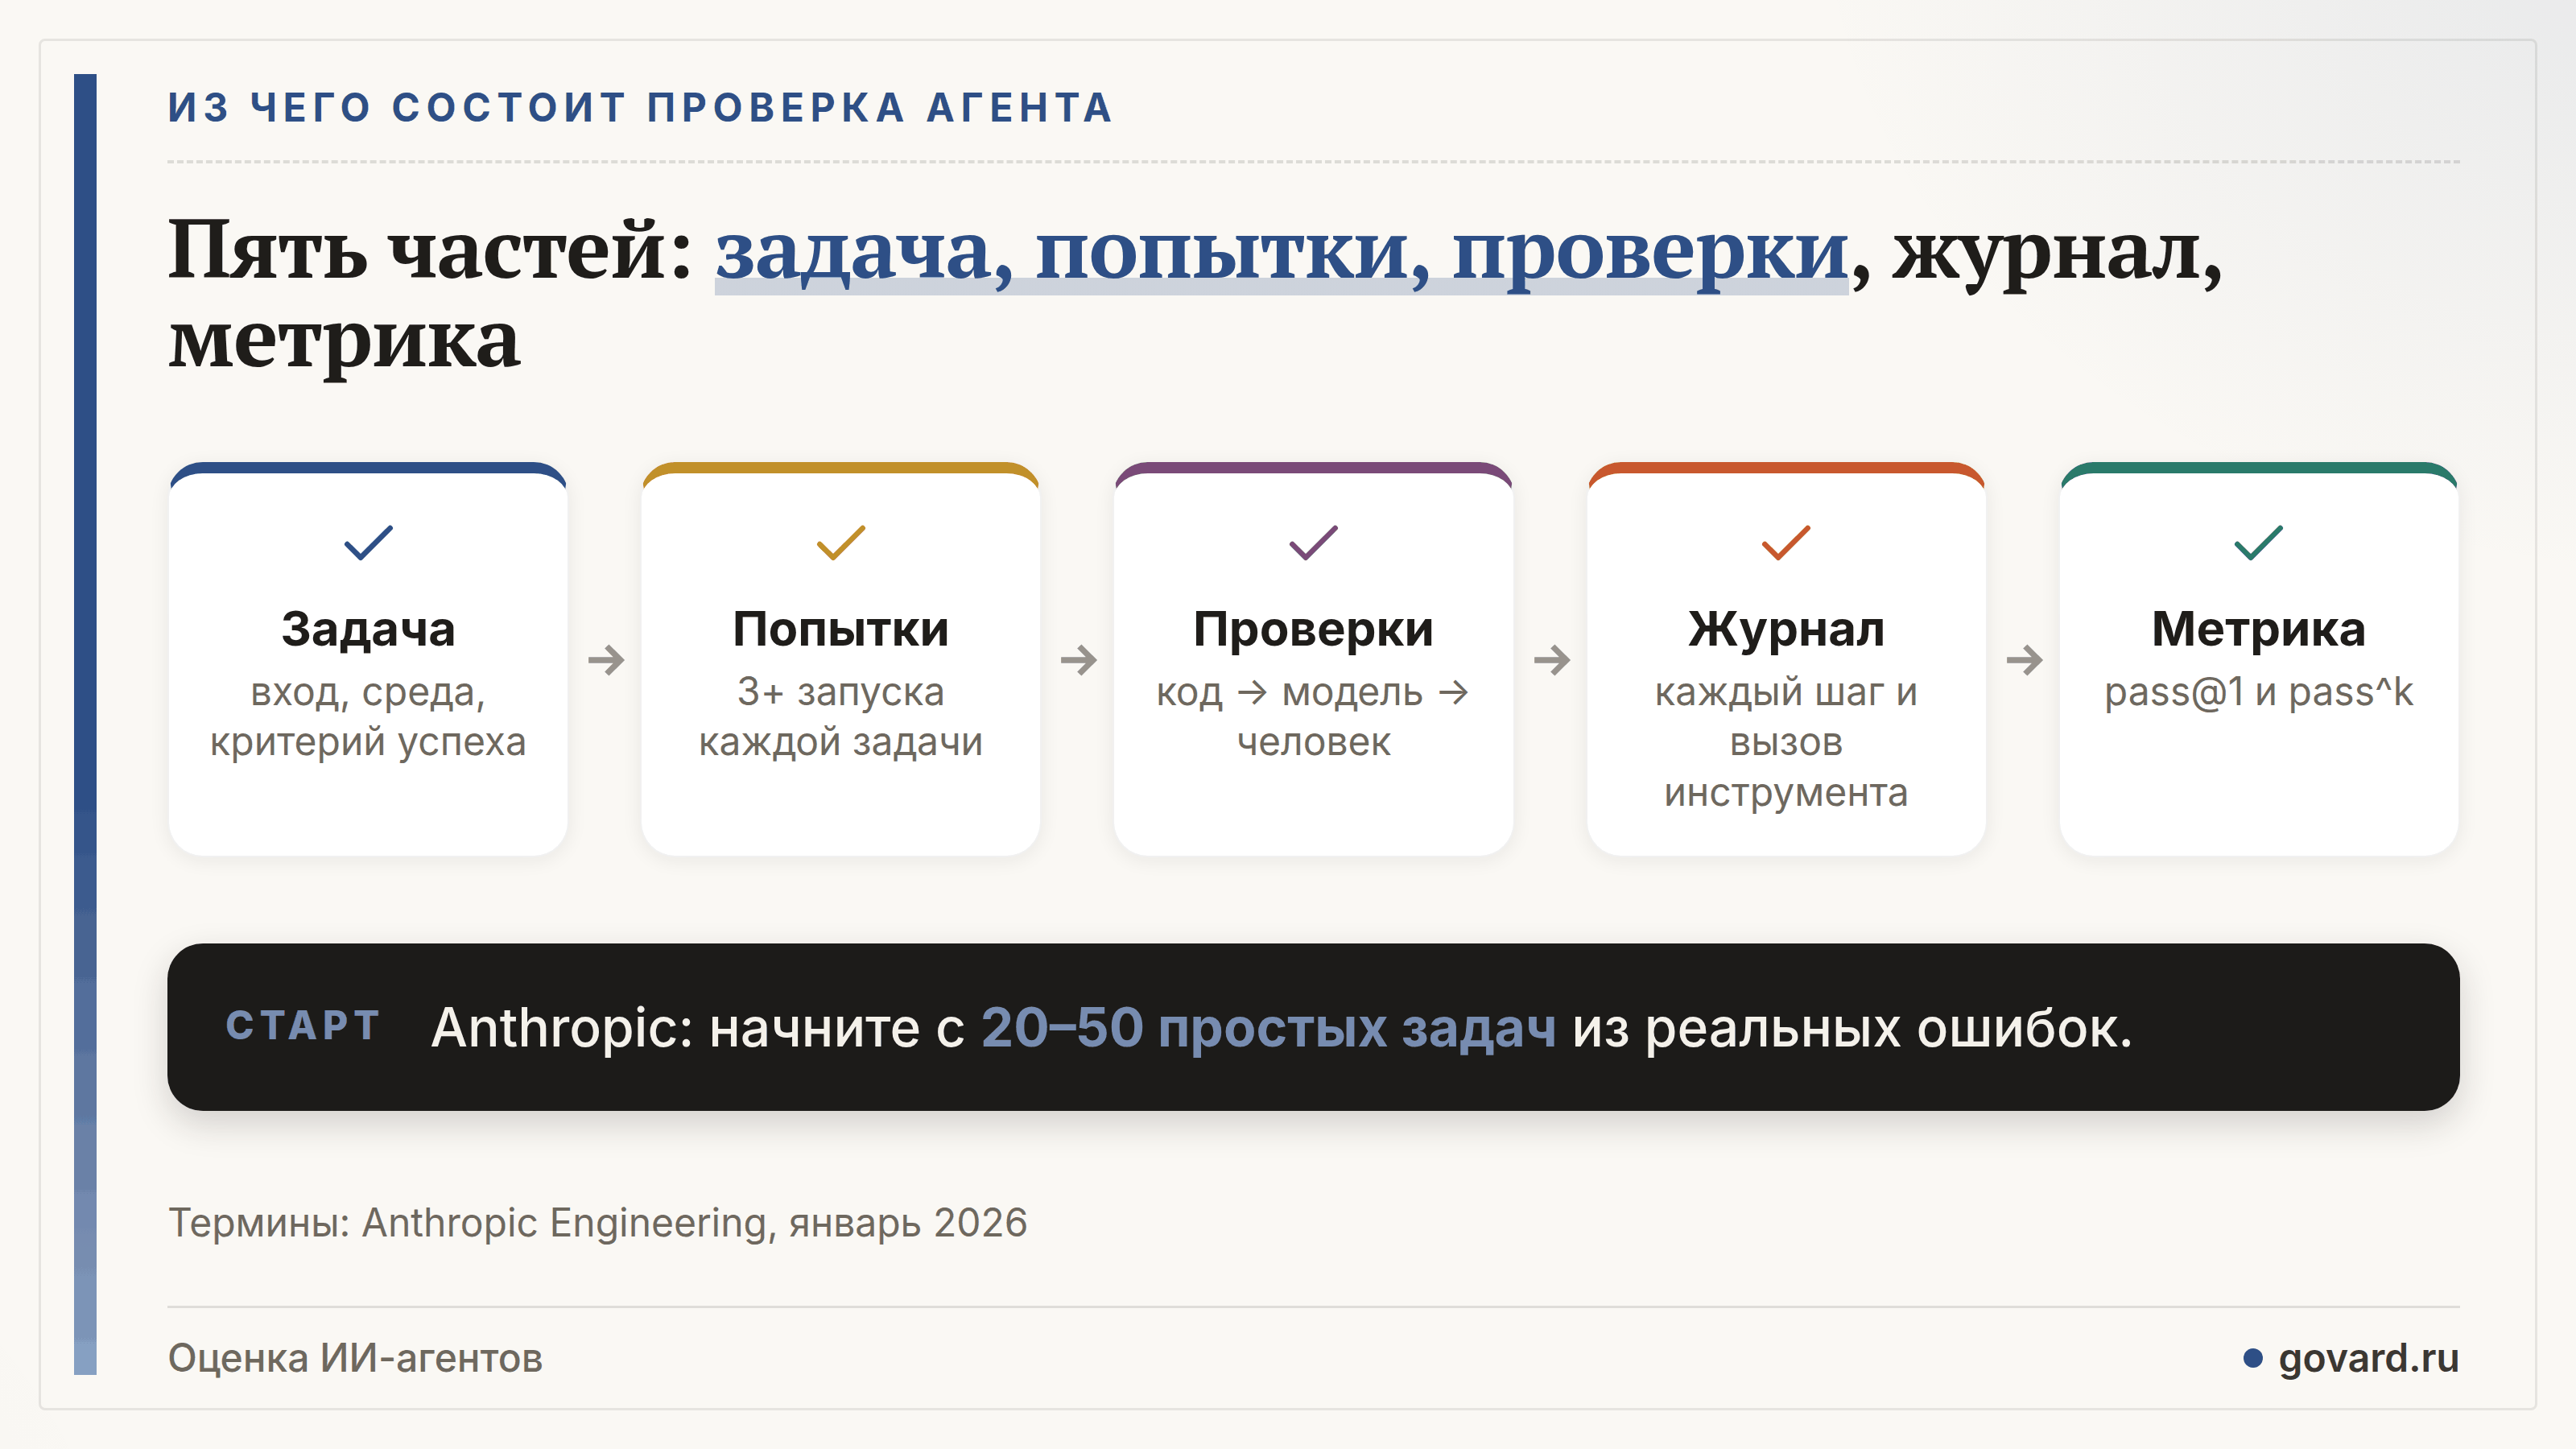
Для старта хватит первых трёх частей. Журналы и обвязка становятся главной работой, когда задач больше нескольких десятков.
03 · Откуда брать задачи
Следующий вопрос — что положить в набор. Совет Anthropic: начать с 20–50 простых задач из реальных ошибок. Придуманные тесты обычно повторяют допущения разработчика.
Как только люди начинают оценивать ответы, проявляются два эффекта:
- Критерии меняются в процессе. Исследование EvalGen (UIST 2024) показало: критерии нужны, чтобы оценивать ответы, но именно оценка ответов помогает их сформулировать. Напишите черновик рубрики, оцените 20–50 настоящих ответов и перепишите рубрику по заметкам.
- Подгонка под тест. Если настраивать агента на тех же задачах, на которых его проверяют, оценка перестаёт показывать, как он справится с новыми. Черновик стандарта Evaluation Context Protocol (август 2026) требует строго разделять набор для доработки и отложенный набор для приёмки.
Эталонный набор превращает работу над качеством в цифры, которыми можно управлять. В Стройинтеллекте — мультиагентном продукте для проверки сметной документации, где я владелец продукта и основной разработчик, — мы собрали справочную базу из 103 тыс. позиций федеральных расценок и 150+ нормативов. На внутреннем эталонном наборе точность разбора документов выросла с 21% до 86%. Без набора осталось бы ощущение «разбор стал лучше». С набором появилась цифра, под которую можно планировать работу. У каждого из десяти агентов-специалистов в этой системе есть и свой чек-лист приёмки, чтобы падение качества можно было отследить до конкретного агента.
04 · Проверяйте, что агент изменил в системе
Хороший список задач не спасёт, если проверка читает только ответ агента. Thinkingbox показывает почему: 80,9% неудачных запусков завершаются без сбоя и при этом вызывают инструмент, который меняет данные, а 67,2% ещё и заканчиваются без явной ошибки в последнем ответе инструмента. По ответу и последнему вызову такой провал не виден.
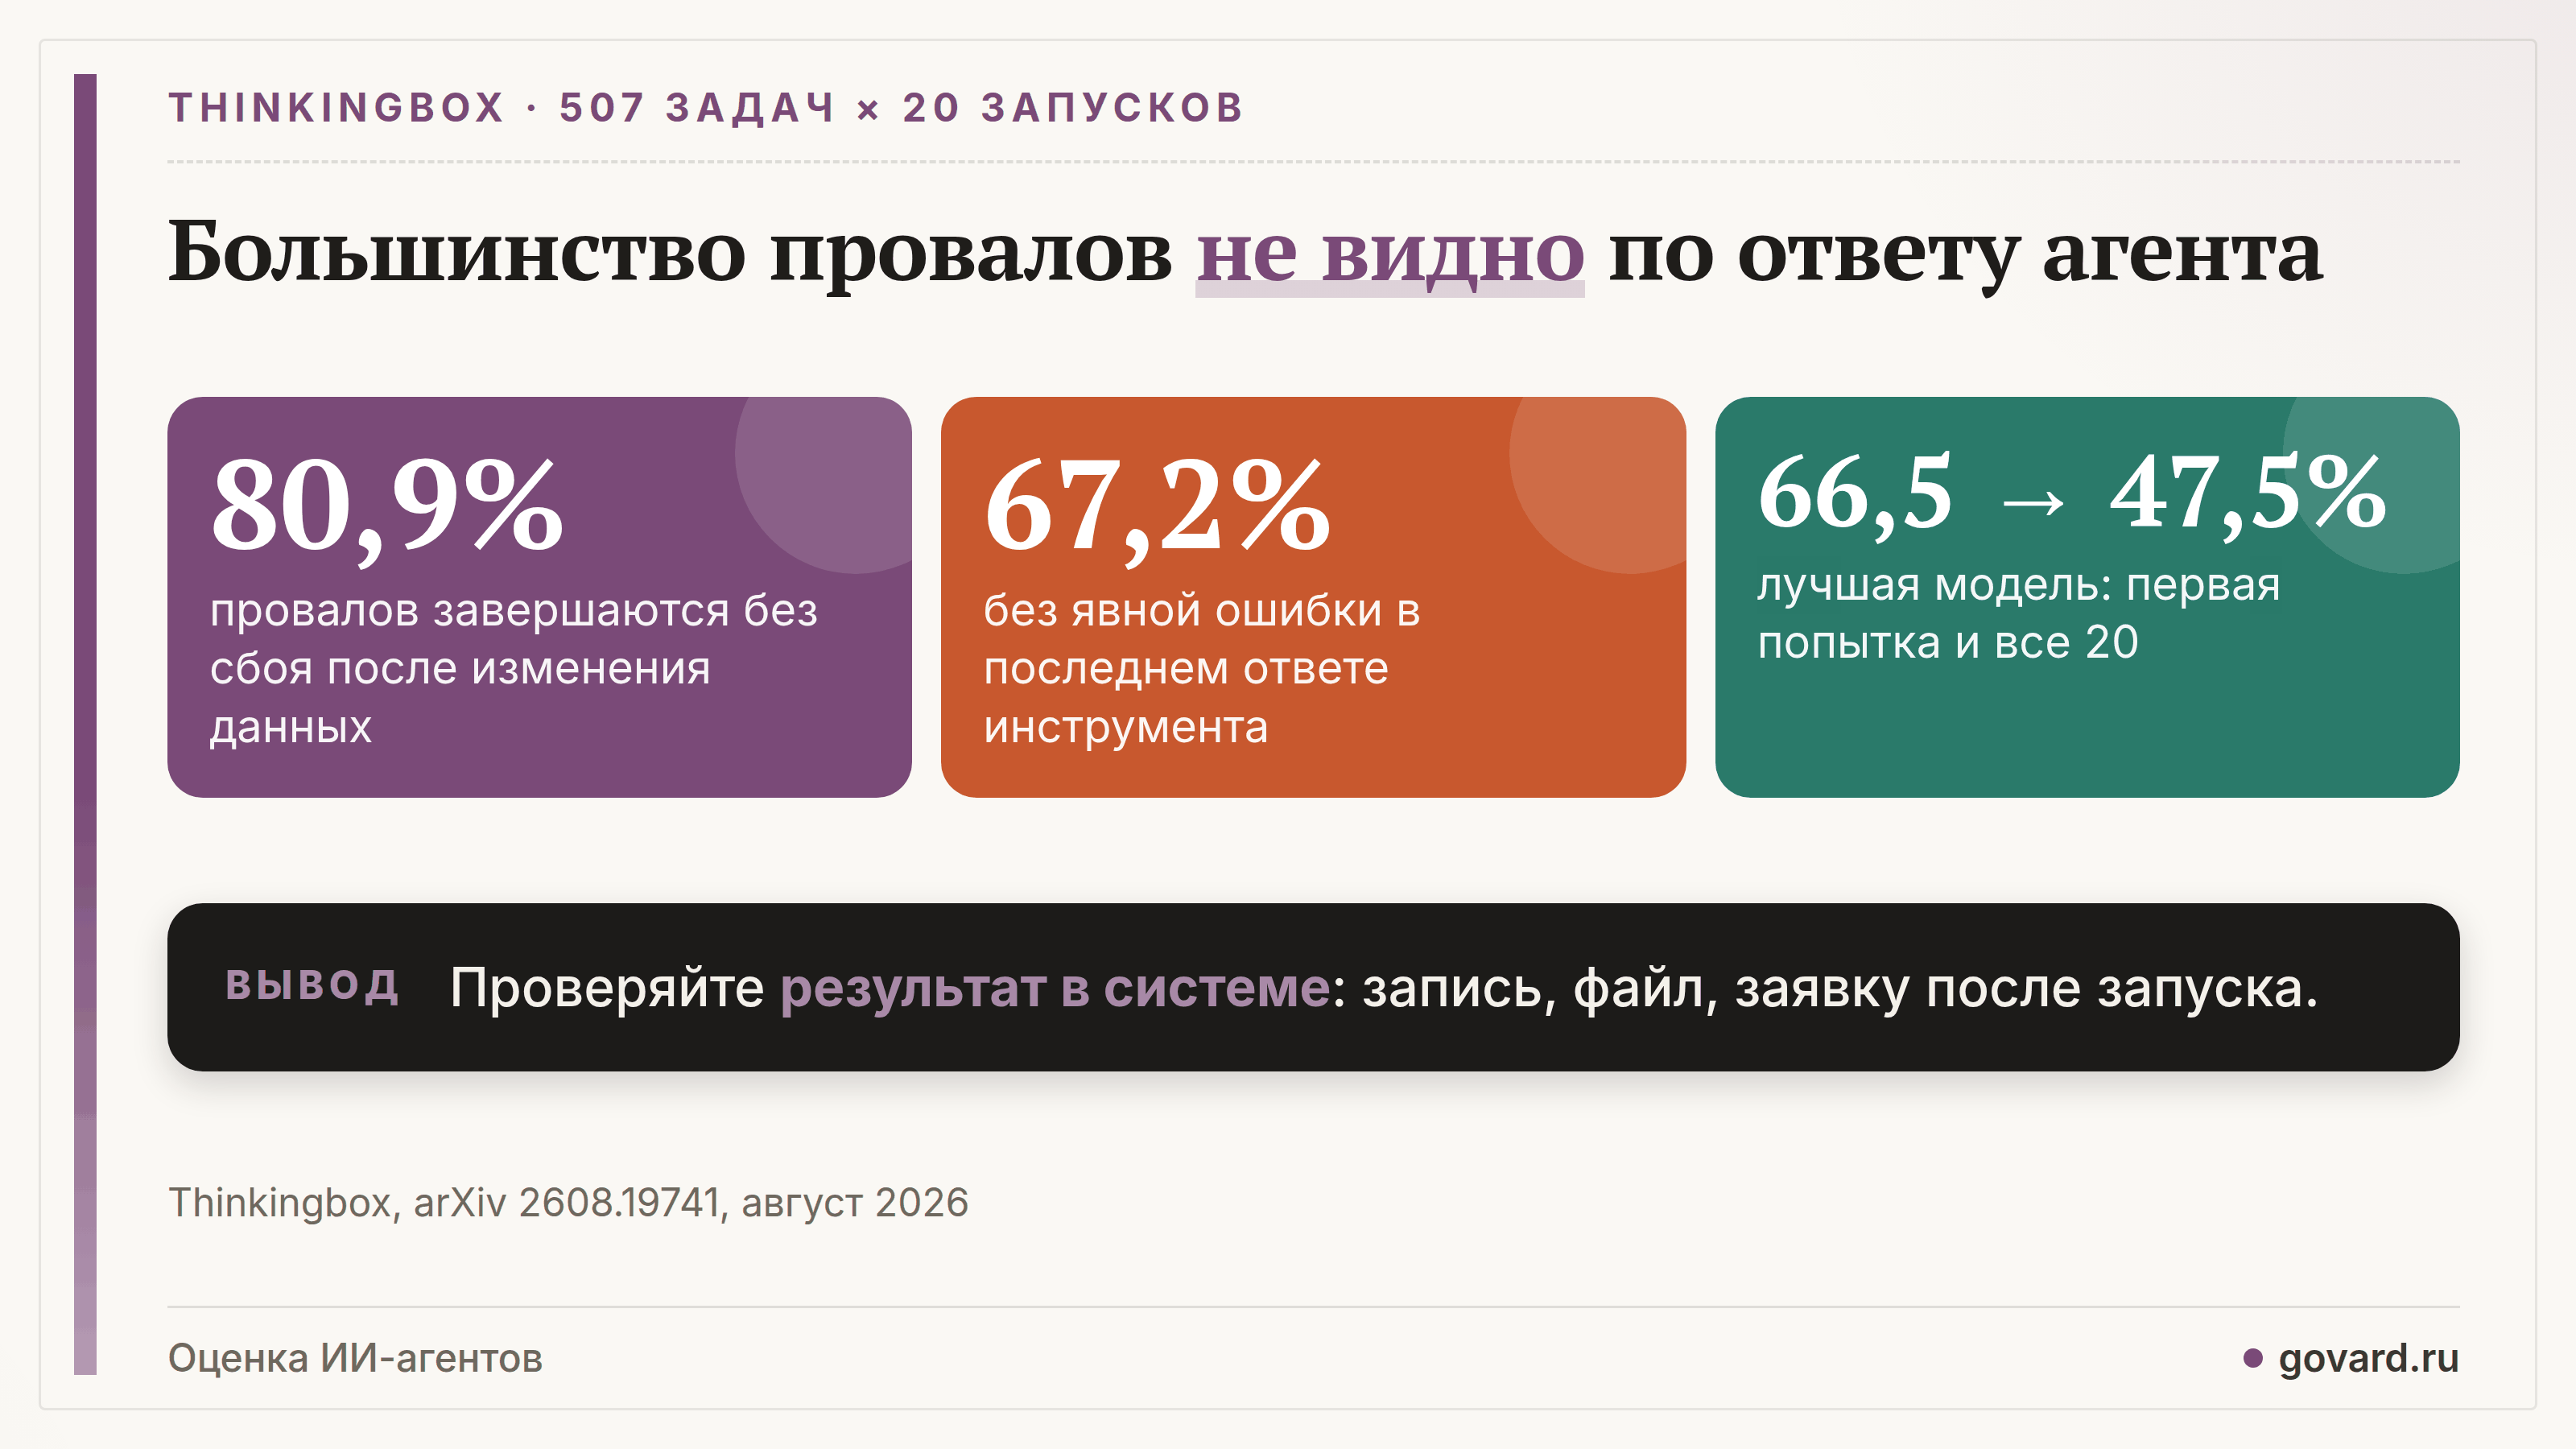
В τ-bench это решили ещё в 2024 году: итоговое состояние базы данных сравнивают с эталоном. В продукте работает тот же приём:
- запись в CRM, файл или заявку после запуска сравнивают с ожидаемыми;
- запрещённые действия (отправка писем, удаление строк, платежи) проверяют отдельно, по принципу «да / нет»;
- формат ответа проверяет код, и ответ не по схеме считается провалом.
В Стройинтеллекте мы держимся более строгого правила: код считает, модель объясняет. Деньги и арифметика считаются обычным кодом, каждая цифра в отчёте ссылается на файл, лист и строку сметы, а ответ модели не по схеме отклоняется. При таком разделении большая часть проверки получается дешёвой: суммы и ссылки можно сверить кодом, а модель или человек нужны только для пояснений.
Авторы ECP приходят к тому же: для детерминированных результатов проверка кодом — лучший вариант по умолчанию.
05 · LLM-судью (LLM-as-a-judge) тоже надо проверять
Часть результатов кодом не проверить: качество пояснения, тон ответа клиенту, обоснованность замечания. Здесь оценку поручают другой модели — LLM-судье. В опросе LangChain (1 340 ответов, конец 2025 года; вендор опрашивал свою аудиторию) LLM-судью используют 53,3% организаций, проверку человеком — 59,8%.
У судьи есть известные перекосы. Ещё в 2023 году авторы MT-Bench описали зависимость оценки от порядка вариантов, от длины ответа и симпатию к собственной модели. На сложных задачах хуже: в исследовании REFLECT (май 2026) ни один из 14 судей, включая 8 коммерческих, не набрал 55% общей точности при проверке доказательств в работе исследовательских агентов.
Поэтому судью настраивают как любой другой компонент:
- Один главный эксперт предметной области размечает 30–100+ ответов: «прошёл / не прошёл» и письменный комментарий.
- Комментарии становятся примерами в промпте судьи.
- Судья размечает тот же набор. Считают совпадение, каппу Коэна и отдельно долю ложных «прошёл» — самую дорогую ошибку.
- Промпт дорабатывают до порога. ECP предлагает не меньше 100 примеров с разметкой человека и каппу от 0,6.
- Результат подтверждают на отложенном наборе, который промпт не видел.
- При сравнении двух вариантов запускают оба порядка, а судью берут из другого семейства моделей.
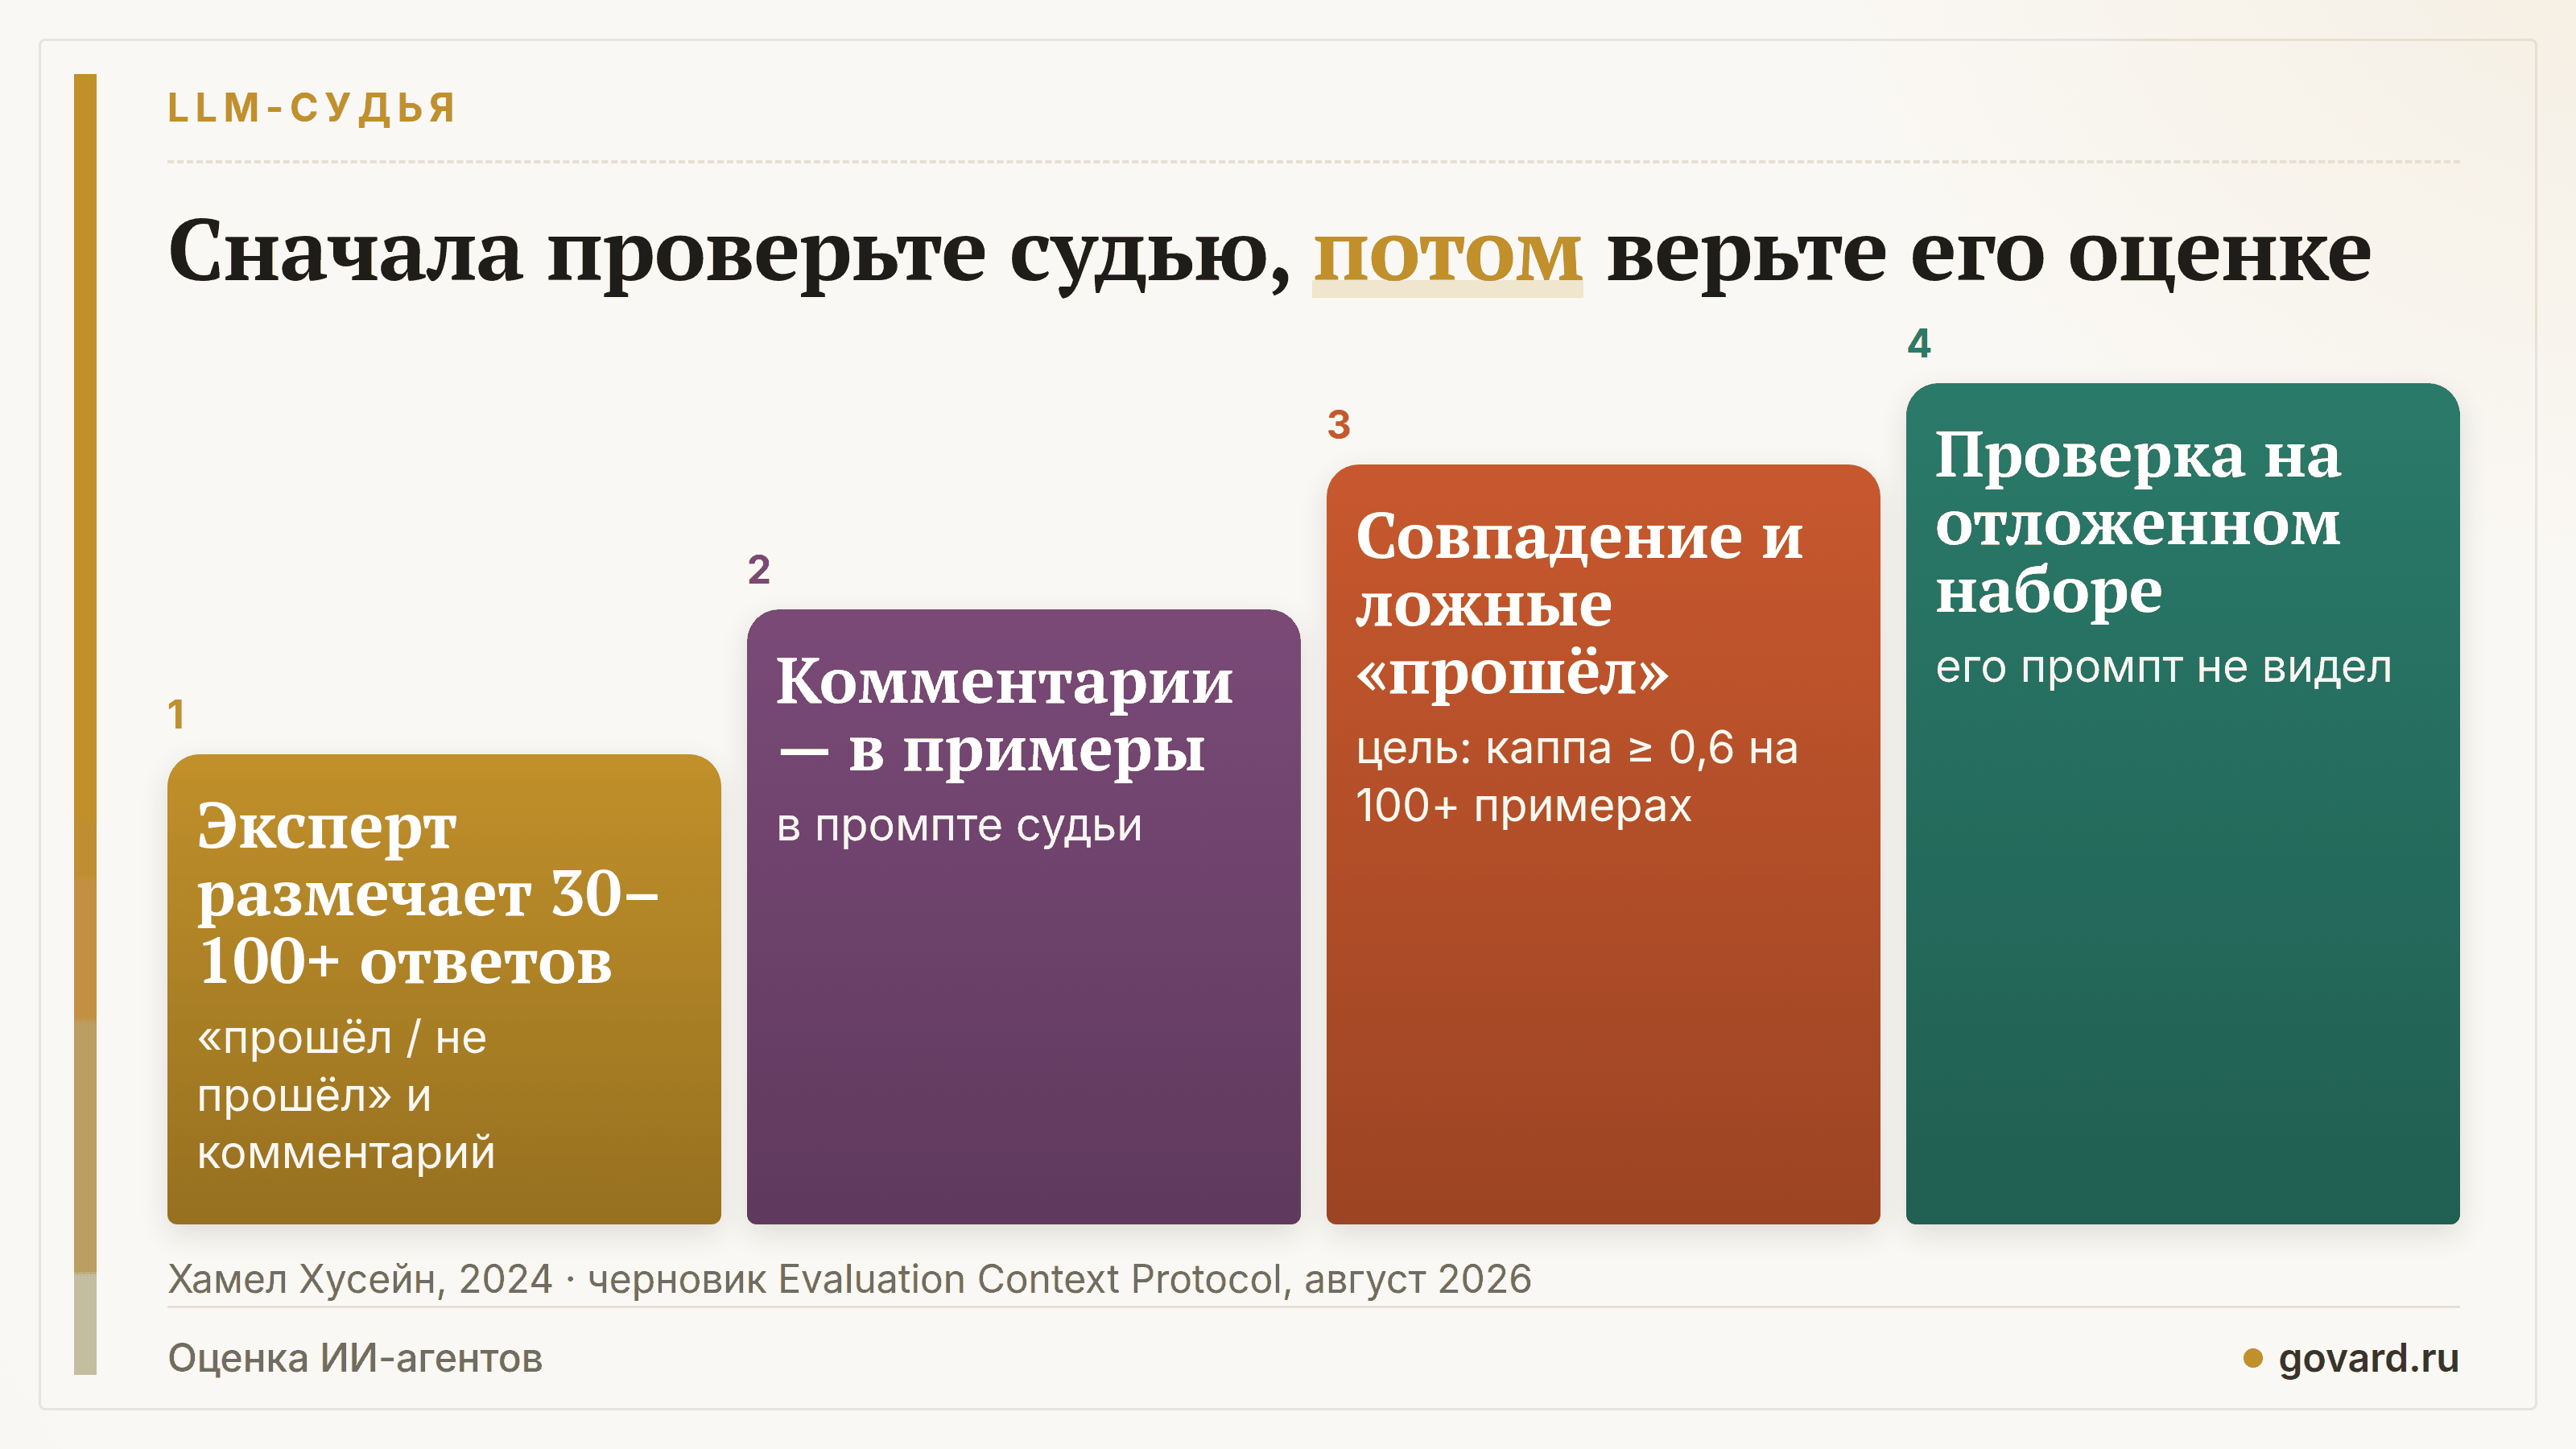
Практик Хамел Хусейн называет этот метод critique shadowing. В Honeycomb совпадение судьи с экспертом дошло до 90% за три итерации. 90% получены на их продукте. Метод можно повторить у себя, цифру придётся мерить заново.
Оценки — только бинарные. ECP: судья ставит «прошёл / не прошёл» по конкретной однозначной рубрике, без абстрактной шкалы от 1 до 5.
06 · Переформулировка промпта сдвигает результат сильнее повторного запуска
Когда судья настроен, следующий источник ошибок — сам тест. Noise Floor Audit (август 2026) измерил оба эффекта на бенчмарке вызова функций BFCL при температуре 0: повторный запуск того же промпта почти не меняет результат (доля изменившихся ответов 0,7–2,7%), а переформулировки с тем же смыслом дают разброс в 11–58 раз больше.
Что из этого следует:
- промпты хранят версиями, как код, и сравнивают версии агента на одном и том же наборе формулировок;
- на каждую задачу берут две-три формулировки, иначе небольшой прирост между версиями может оказаться шумом.
То же исследование нашло, что ответы в неверном формате дали 30%, 7% и меньше 1% ошибок на трёх эндпоинтах двух провайдеров. Средний балл скрывал, что у каждого ошибки разные.
07 · Проверка должна решать, выпускать или нет
Замеры окупаются, когда по ним принимают решения. На мой взгляд, большинству агентных продуктов хватает трёх правил приёмки:
- Чек-лист приёмки на каждого агента. В мультиагентной системе у каждого агента-специалиста свой чек-лист, и падение качества указывает на конкретного агента.
- Эталонные сценарии при смене модели. В AgenticCRM, агентной CRM, которую я строю с командой из шести инженеров, модели проходят сертификацию на 30 сценариях: любая модель на замену сначала проходит те же 30 сценариев.
- Профиль с весами и минимумами. Результат оценивают по нескольким параметрам с весами и задают минимум для критичных, например общий балл от 82 и ни одного критичного параметра ниже 70. Одно среднее скрыло бы провал по отдельному параметру.
Большинство команд до этого ещё не дошли. В опросе LangChain проверку на тестовых наборах проводят 52,4% организаций, на живом трафике — 37,3%. Среди команд с агентами в эксплуатации мониторинг есть у 94%, а оценивают этот трафик 44,8%. Мониторинг без оценки — это журнал: он фиксирует, что произошло, и не говорит, было ли это правильно.
08 · Сколько стоит проверка и где она перестаёт работать
Проверка агентов — отдельная статья бюджета. Holistic Agent Leaderboard потратил около $40 тыс. на 21 730 запусков агентов, примерно $1,8 за запуск. pass^k умножает это на k, а LLM-судья добавляет свои токены. Бюджет на проверку стоит закладывать рядом с расходами на модель с самого начала.
Три границы метода:
- Публичные рейтинги не переносятся на ваш процесс. В феврале 2026 года OpenAI перестала публиковать результаты SWE-bench Verified: в 59,4% из 138 проверенных трудных задач тесты оказались дефектными, а модели проявляли признаки знания ответов. Рейтинги помогают составить короткий список моделей, решение принимают на своих задачах.
- Набор стареет. Меняются клиенты, продукт и критерии. Каждый инцидент из эксплуатации добавляйте новой задачей, эталонный набор пересматривайте по графику.
- Один эксперт — один вкус. Судья подстраивается под одного человека. Если у продукта очень разные группы пользователей, настраивайте судью под каждую или оставляйте пограничные случаи человеку.
09 · Что спросить у подрядчика до подписания акта
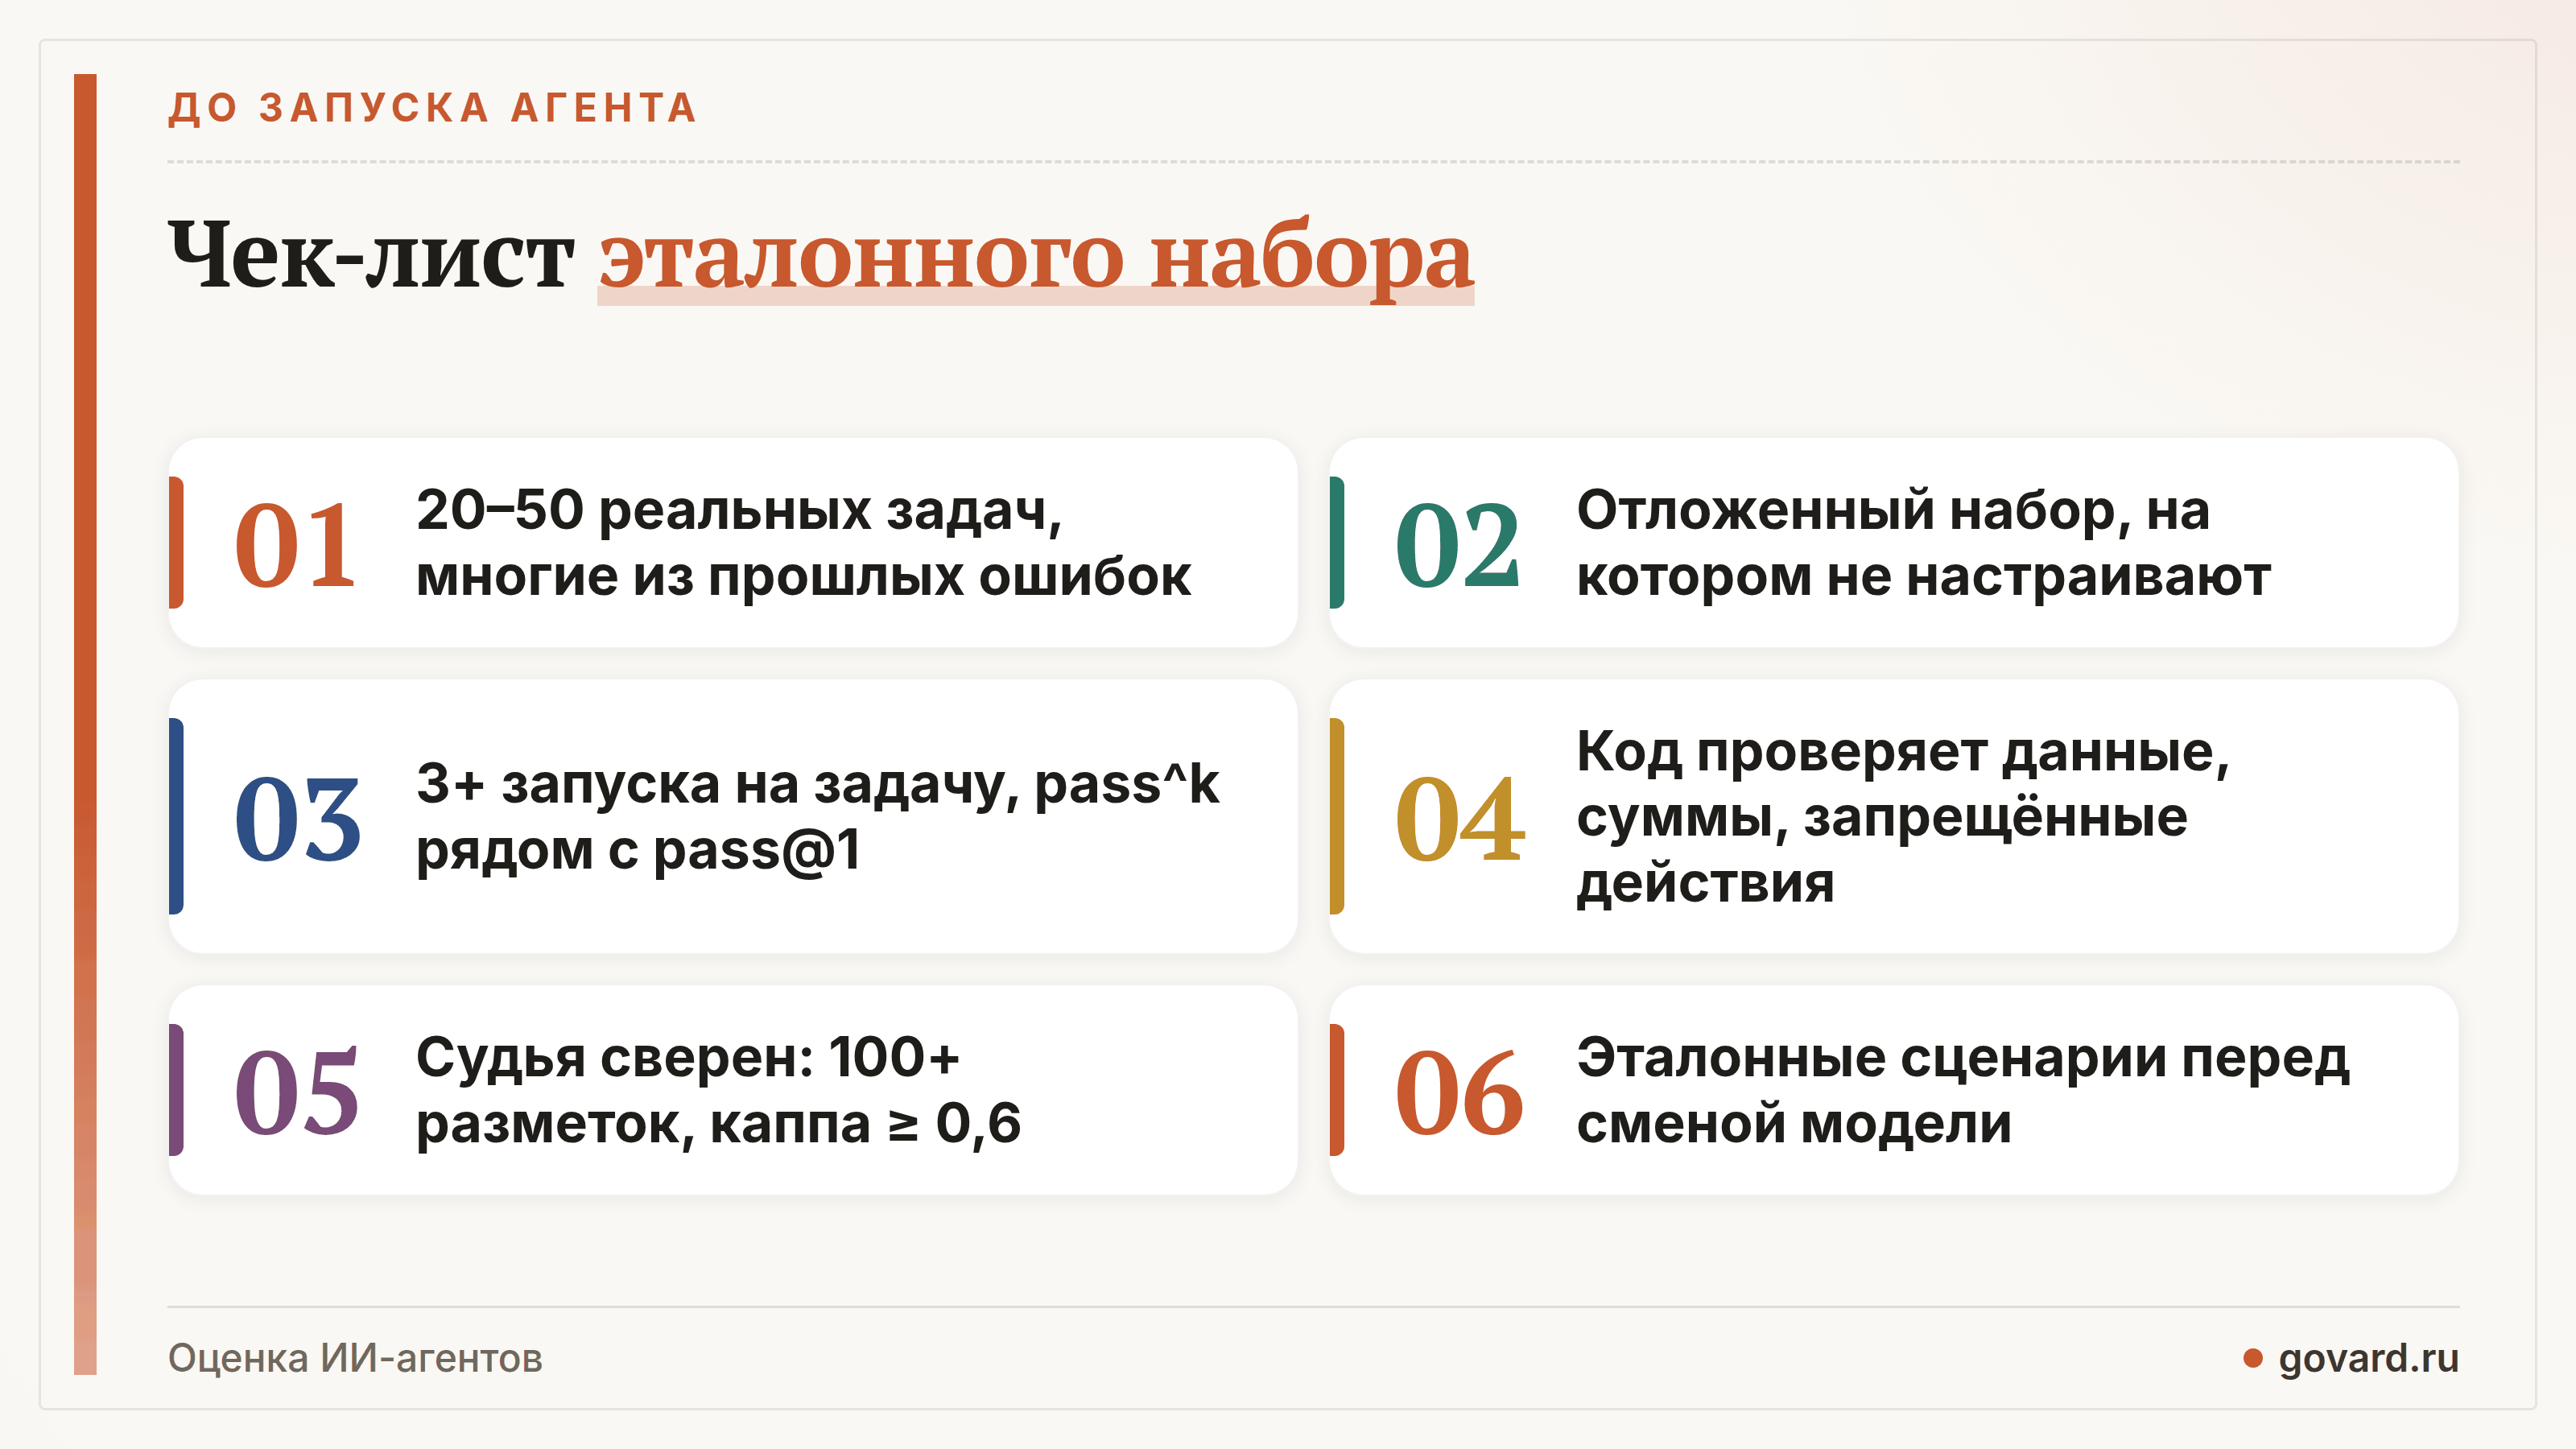
Если агента делает подрядчик, эталонный набор — главное, что стоит получить вместе с кодом. Не отдаёт набор — не подписывайте приёмку. Модели меняются раз в несколько месяцев, и набор за полдня покажет, можно ли переходить на новую.
Вопросы подрядчику:
- На каком наборе задач измерено качество? Можно ли получить этот набор и запустить его самим?
- Сколько раз запускалась каждая задача? Какой pass^k на задачах с высокой ценой ошибки?
- Что проверяется: текст ответа или результат в CRM и учётных системах (запись, документ, письмо)?
- Как проверен LLM-судья: сколько примеров разметил человек, какое совпадение, сколько ложных «прошёл»?
- Какие действия агент не выполняет без подтверждения человека?
- Что будет при смене модели или версии промпта: какие сценарии прогоняются до выпуска?
Остановить приёмку и вернуть на доработку стоит, если:
- pass^3 на важных задачах ниже вашего порога, даже при хорошем pass@1;
- хоть один критичный критерий ниже минимума;
- смена модели или промпта не прошла эталонные сценарии.
О безопасности той же системы — в реестре случаев prompt injection: там вопросы о правах агента и о том, какой чужой текст он читает. Как компании переходят от ответов агента к его действиям — в статье «ИИ-агенты в продукте».
Какую цифру ваша команда смотрит перед запуском агента: pass@1, pass^k или что-то своё?