Один и тот же уровень качества ИИ дешевеет на 47% в квартал. Почему счёт за ИИ-агента не падает
Epoch AI насчитал удешевление фиксированного уровня ИИ в 13 раз в год, MIT FutureTech — рост стоимости фронтира в 3–18 раз в год. Три причины, почему счёт за агента не идёт за ценой токена, и как считать стоимость задачи. С примером тарифов GigaChat.
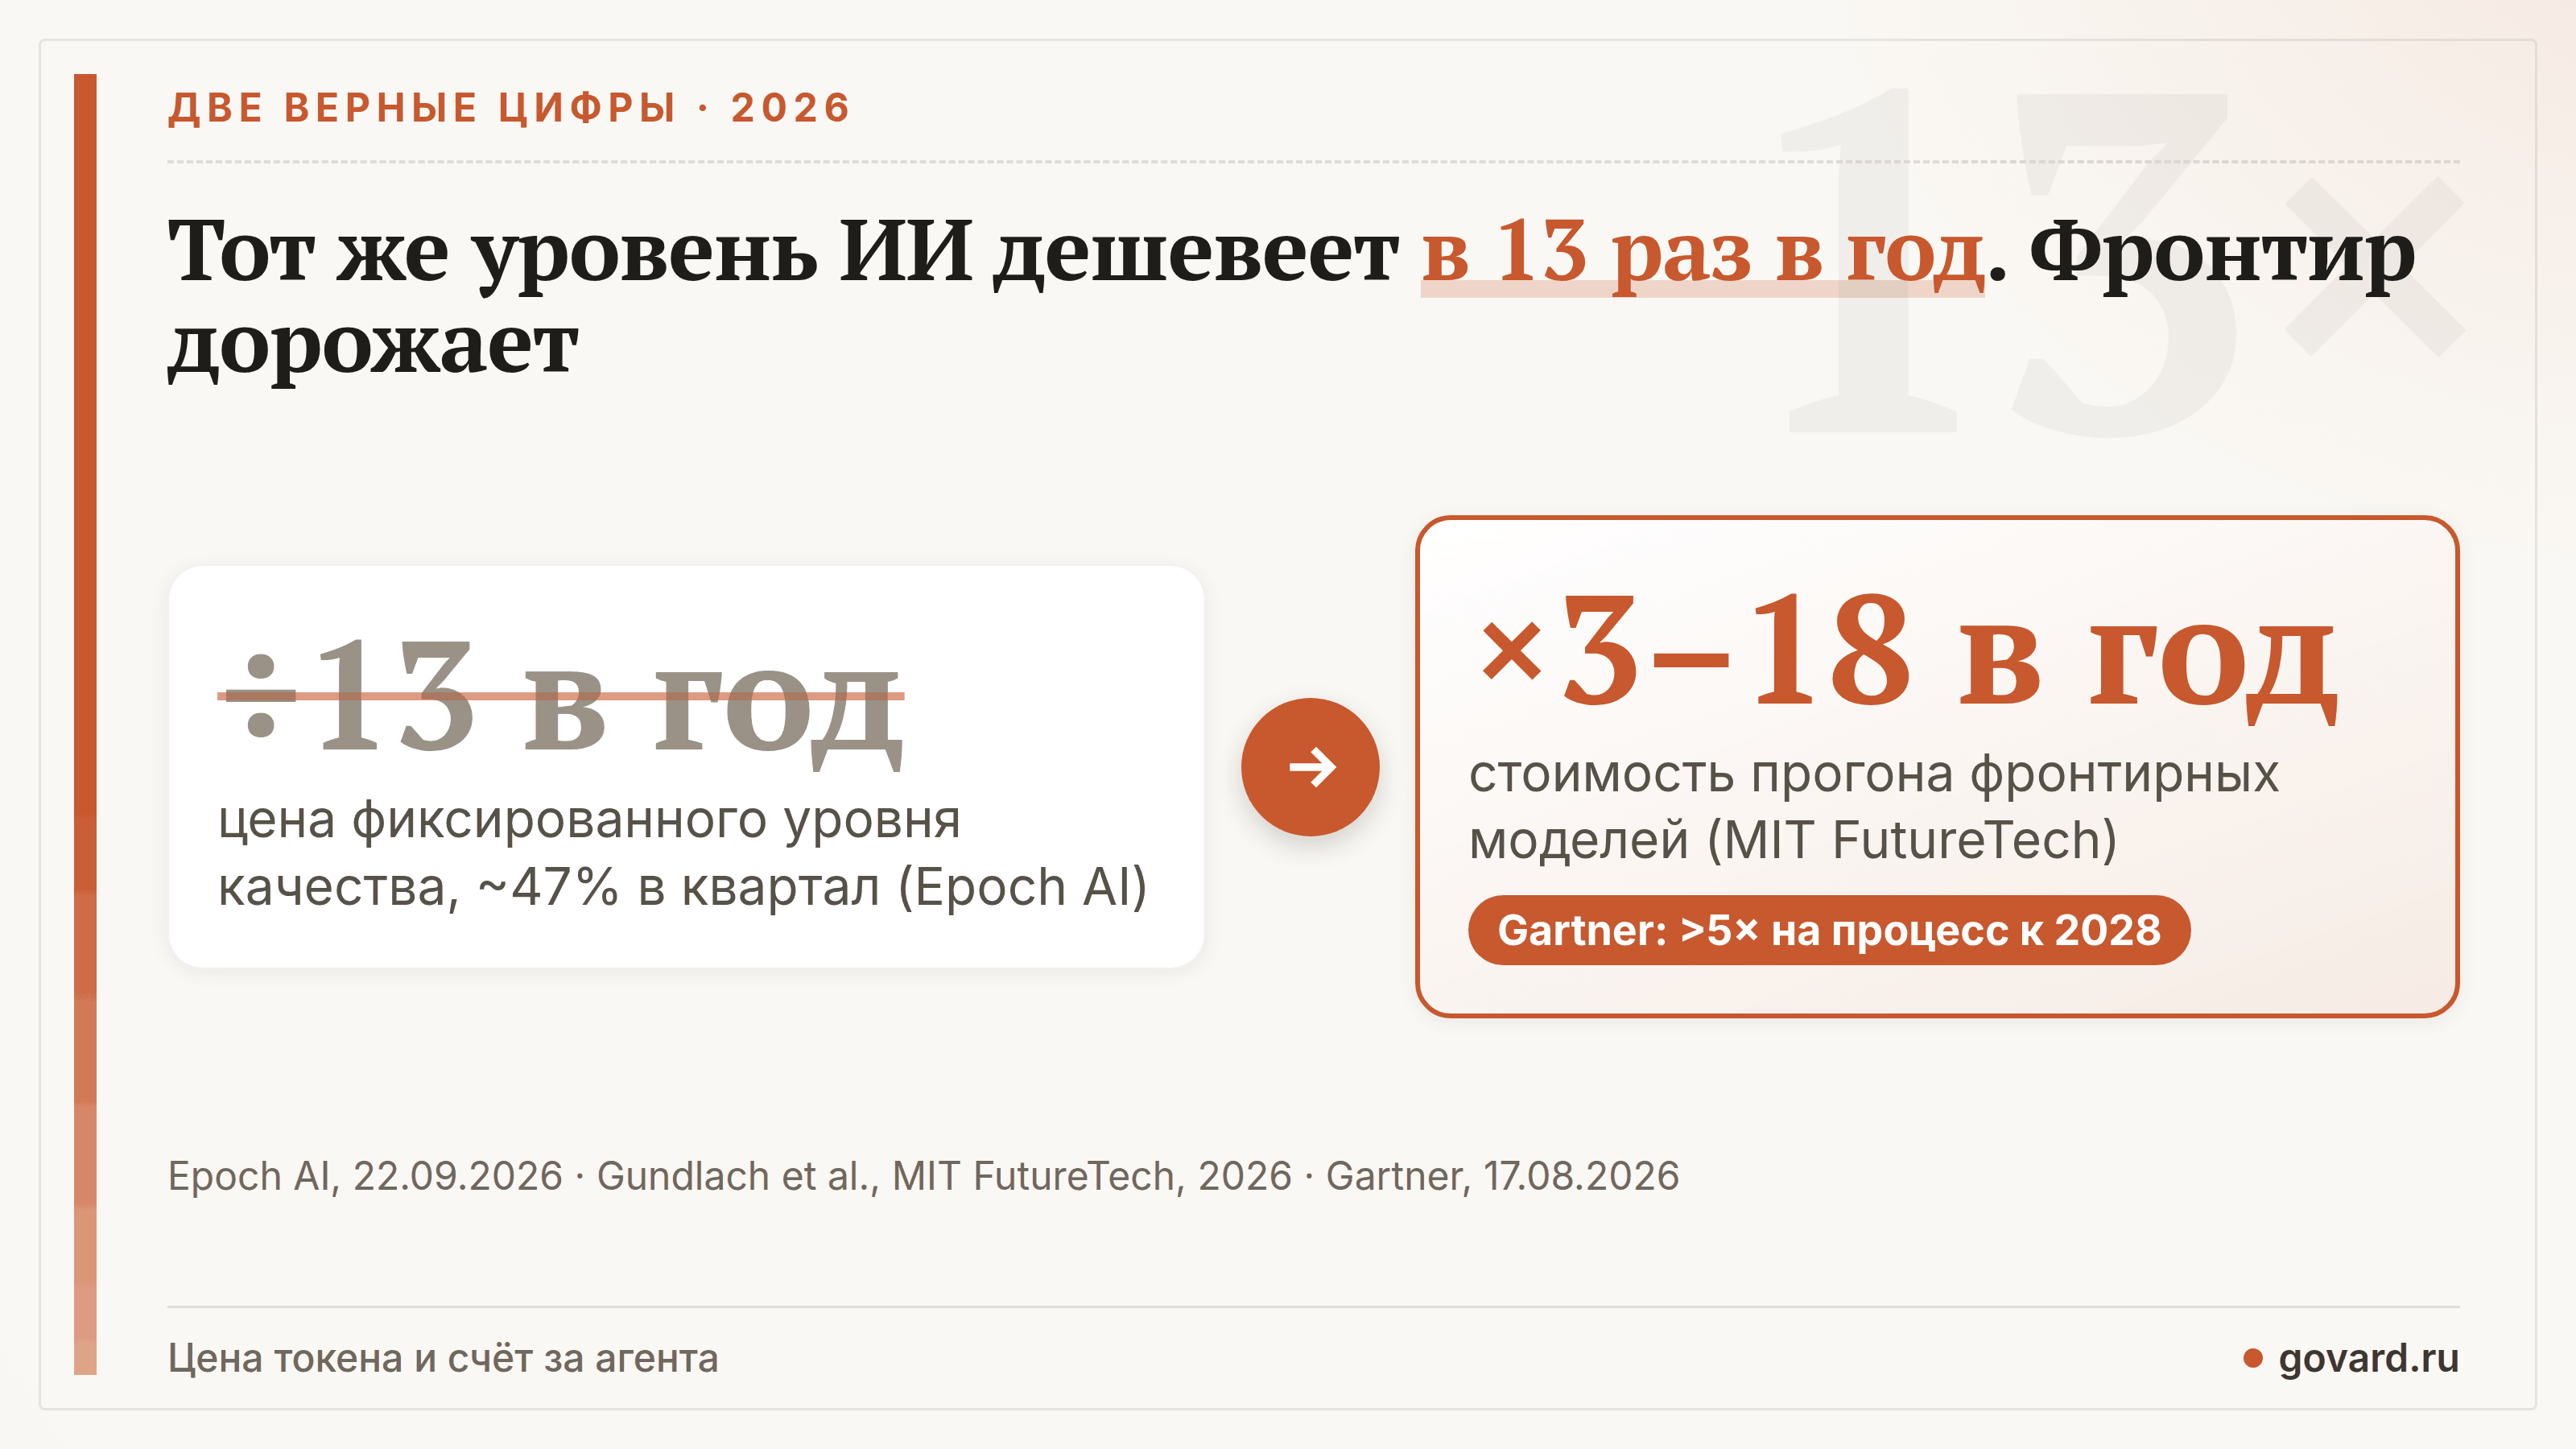
В 2026 году вышли две цифры, которые на первый взгляд спорят друг с другом. Epoch AI посчитал, что стоимость фиксированного уровня качества ИИ с 2023 года падает примерно на 47% в квартал, то есть в 13 раз в год. Gartner прогнозирует, что расходы на инференс в расчёте на один агентный процесс до 2028 года вырастут больше чем в пять раз.
Верны обе. Первая цифра — цена вчерашнего качества. Вторая — цена работы, которую агент делает сегодня. Дальше — три причины, почему счёт за агента не идёт за ценой токена, и формула стоимости задачи с расчётом, в том числе на тарифах GigaChat. Цены зарубежных моделей взяты из прайсов вендоров на 28.09.2026, тарифы Сбера — на 29.09.2026.
01 · Две верные цифры
Начнём с оптимистичной. В январе 2025 года модель OpenAI o3 отвечала на вопрос теста GPQA Diamond с точностью 75%, и один ответ стоил около 30 центов. В 2026 году GPT-5.6 Luna показала тот же результат за $0,0004 за вопрос. Это замер из работы Epoch AI «The plunging price of thought» (22.09.2026).
«Меньше чем за 18 месяцев цена мышления упала в 725 раз». — Epoch AI
Общий темп по Epoch — 13 раз в год. Это вчетверо быстрее, чем дешевело секвенирование ДНК, и вшестеро быстрее, чем дешевели вычисления.
Теперь вторая сторона. Исследователи MIT FutureTech (Гундлах и соавторы) по данным Artificial Analysis и Epoch получили две кривые. Цена фиксированного уровня качества падает в 5–10 раз в год. Стоимость прогона фронтирных, то есть самых сильных на момент замера, моделей растёт в 3–18 раз в год: модели становятся больше и дольше рассуждают. Прогноз Gartner для агентных процессов (август 2026 года) указывает в ту же сторону.
02 · «Дешевле» зависит от способа измерения
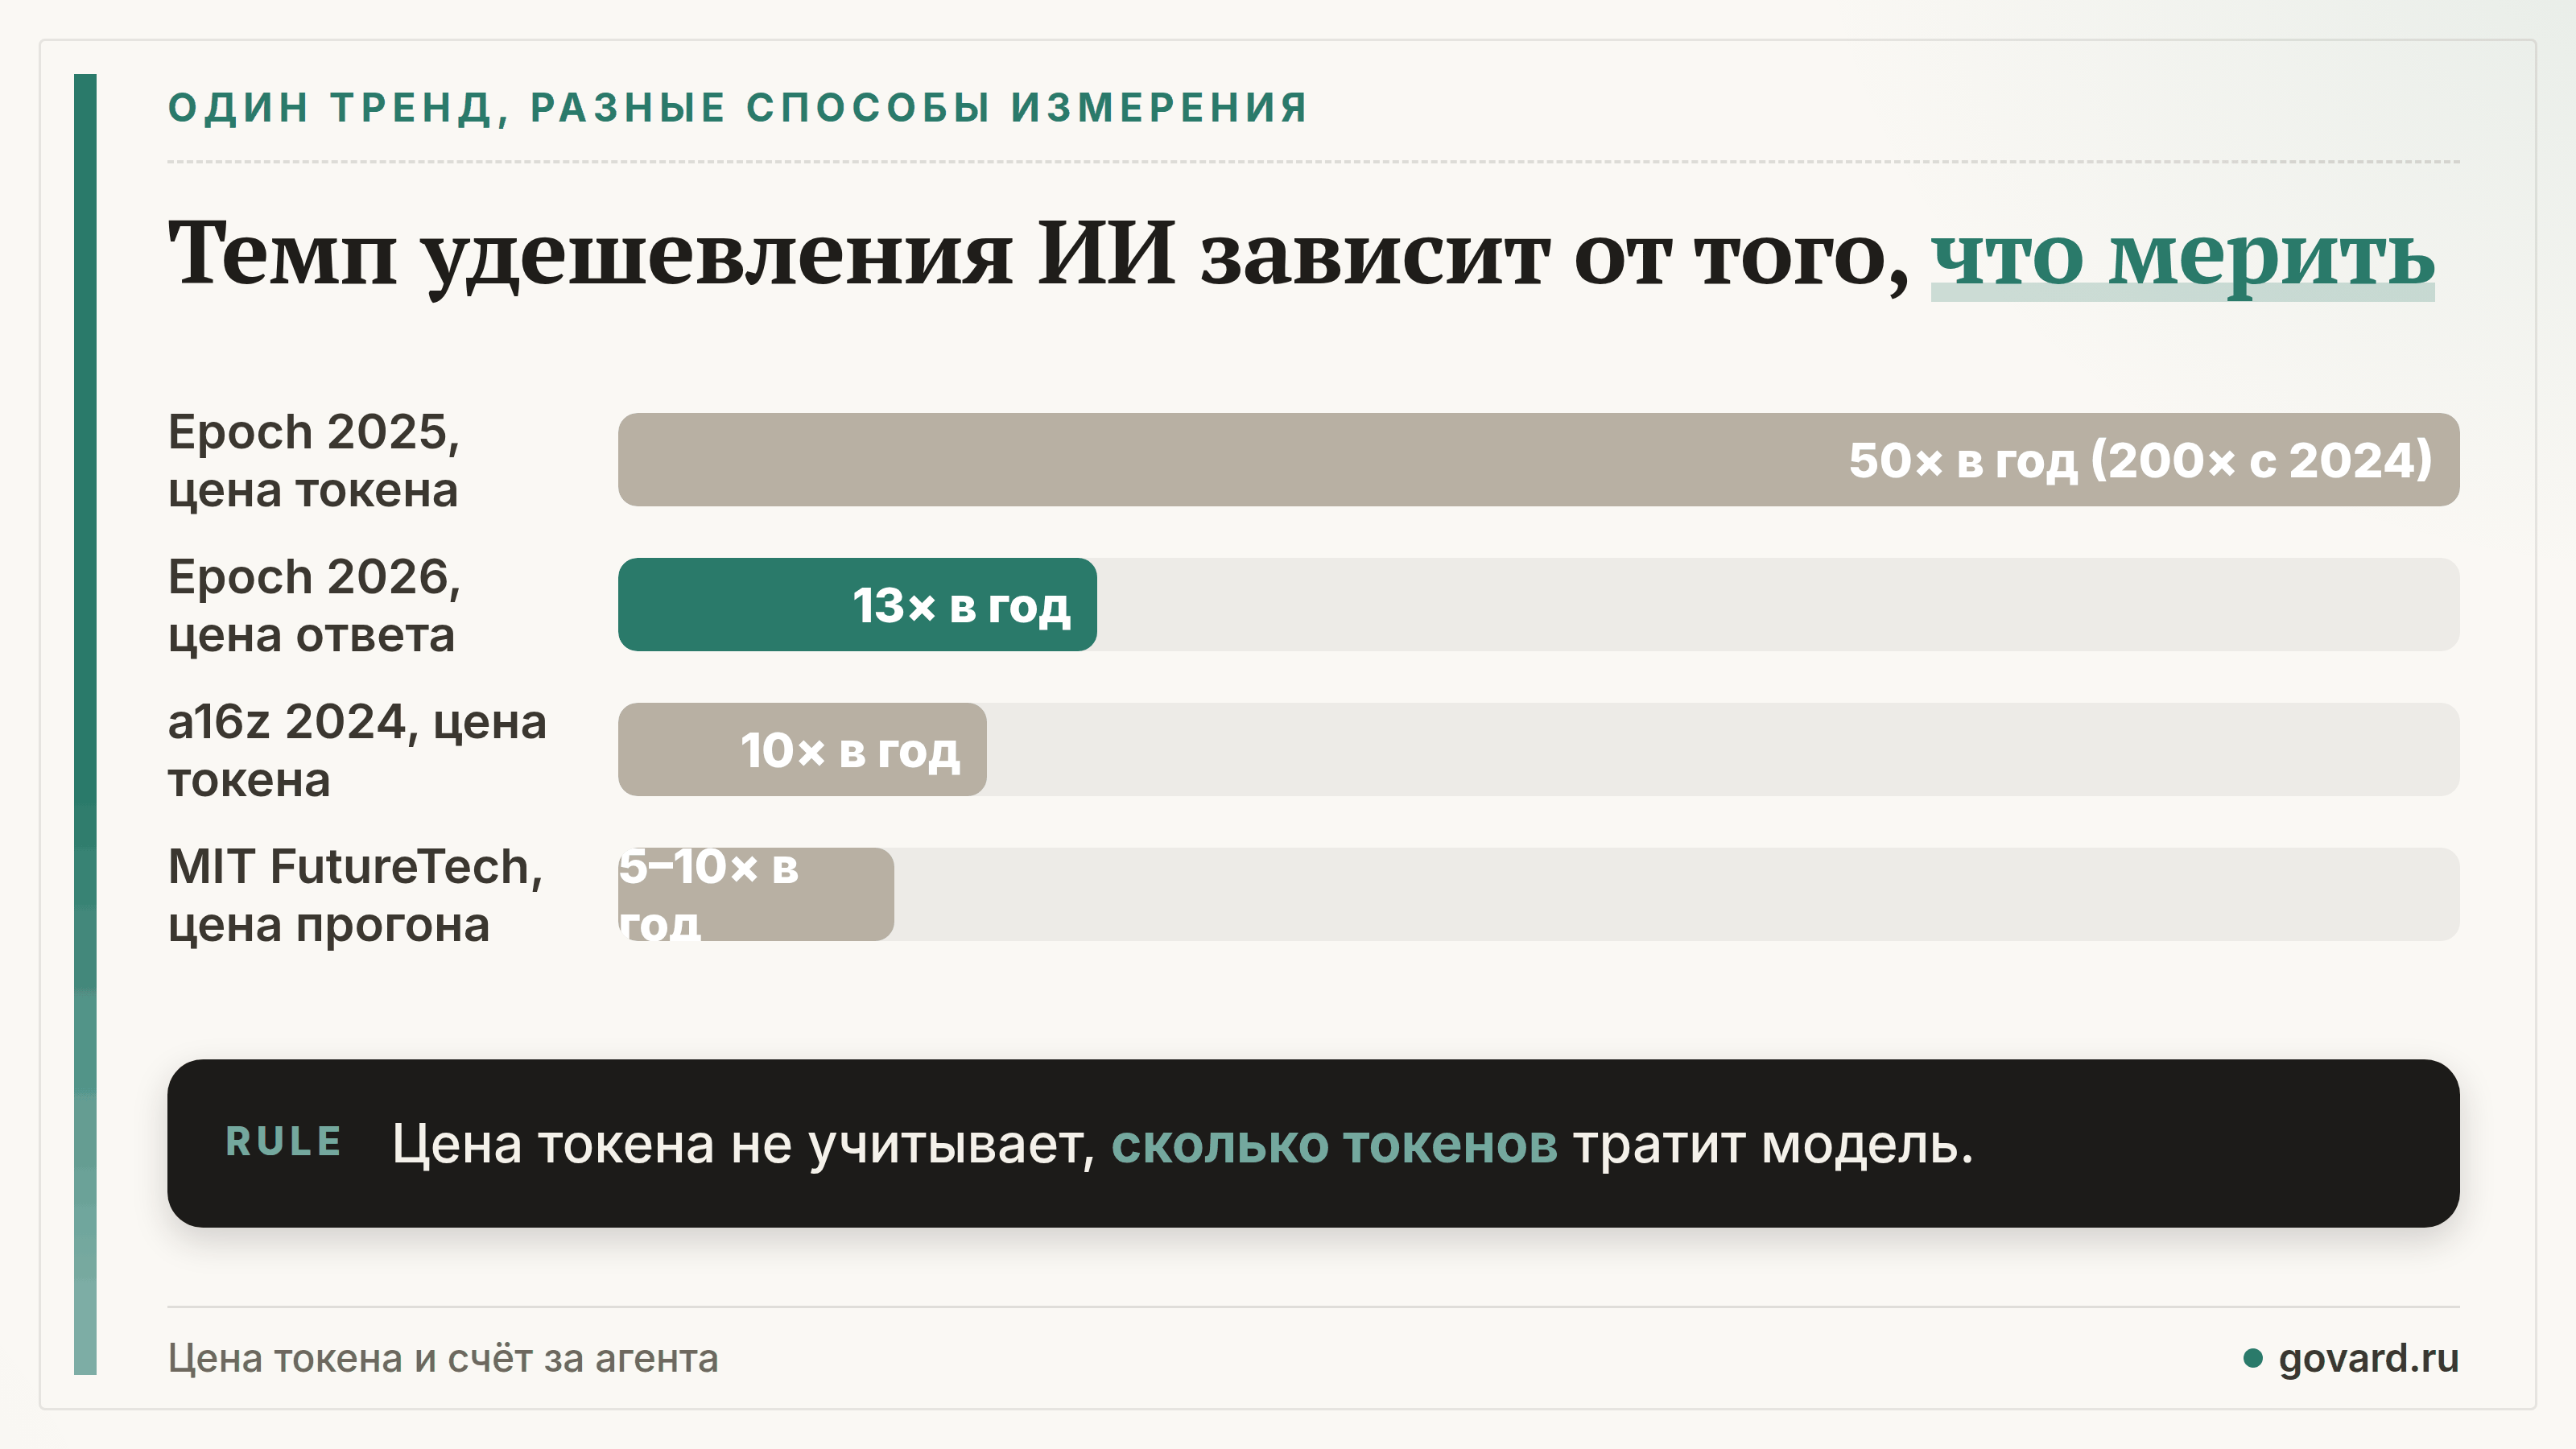
Кривые расходятся, потому что их считают по-разному. Способов минимум три, и громкие цифры получены разными.
- Цена токена самой дешёвой модели, которая прошла порог теста. a16z в 2024 году насчитал 10 раз в год. GPT-3 в ноябре 2021 года стоил $60 за миллион токенов, а через три года Llama 3.2 3B дала тот же результат на тесте MMLU за $0,06. Epoch в 2025 году получил медиану 50 раз в год, а по данным с января 2024 года — 200 раз. Этот способ не учитывает, сколько токенов модель тратит на ответ.
- Фактическая стоимость ответа на вопрос. Epoch в 2026 году и MIT FutureTech считают токены, которые модель реально потратила, вместе с рассуждениями. Темп падает до 5–13 раз в год.
- Стоимость лучшей модели на дату замера. Эта растёт.
Поэтому «10×», «13×», «50×» и «200×» описывают разные вещи. Презентация вендора с цифрой 200 и финансовый директор с растущим счётом могут быть правы одновременно. Когда видите цифру удешевления, проверяйте, чей это замер и что именно мерили.
03 · Причина первая: вы покупаете сегодняшнее качество
Первая причина, почему счёт не уменьшается: дешевеет качество, которое уже было, а компании покупают новое.
Внутри одного уровня цена действительно падает. Уровень Opus у Anthropic стоил $15 / $75 за миллион входных / выходных токенов у Opus 4.1 в 2025 году, $5 / $25 у Opus 4.5–5 и $4 / $20 у Opus 5.5. Но над ним появился новый уровень: Claude Fable 5.1 за $10 / $50. Верхний уровень OpenAI, GPT-6 Astra, стоит столько же. Так было и раньше: в 2024 году a16z заметил, что o1 стоит за выходной токен столько же, сколько GPT-3 на старте, $60 за миллион.
У Сбера похожая лестница внутри одной линейки. GigaChat Lite стоит 0,065 ₽ за 1000 токенов, Pro — 0,5 ₽, Max — 0,65 ₽. Max дороже Lite в 10 раз, но дороже Pro всего в 1,3 раза. Цены с НДС, за 1 млн токенов это 65, 500 и 650 ₽.
Ещё одно наблюдение по тарифам Сбера: пакеты стоят ровно столько же, сколько оплата по факту. 300 млн токенов Lite за 19 500 ₽, 50 млн токенов Pro за 25 000 ₽ и 30 млн токенов Max за 19 500 ₽ дают те же 0,065, 0,5 и 0,65 ₽ за 1000 токенов. Скидки за объём нет, вдвое дешевле только асинхронный режим (о нём ниже). При использовании спишут не меньше 600 ₽, а новые клиенты с 1 сентября 2026 года могут оплачивать через cloud.ru.
Epoch показывает, когда приходит скидка. Цена уровня, который только что стал лучшим, падает на 66% в квартал, а через два года — на 32%. Epoch сам называет границу метода: он берёт самую дешёвую модель для каждого уровня, а реальные пользователи так часто модели не меняют. Команда, которая каждый раз переходит на новый флагман, каждый год платит цену флагмана.
04 · Причина вторая: агент тратит токены, которых вы не видите
Цена токена — это только один множитель счёта. Второй — сколько токенов ушло, и агент увеличивает это число тремя способами.
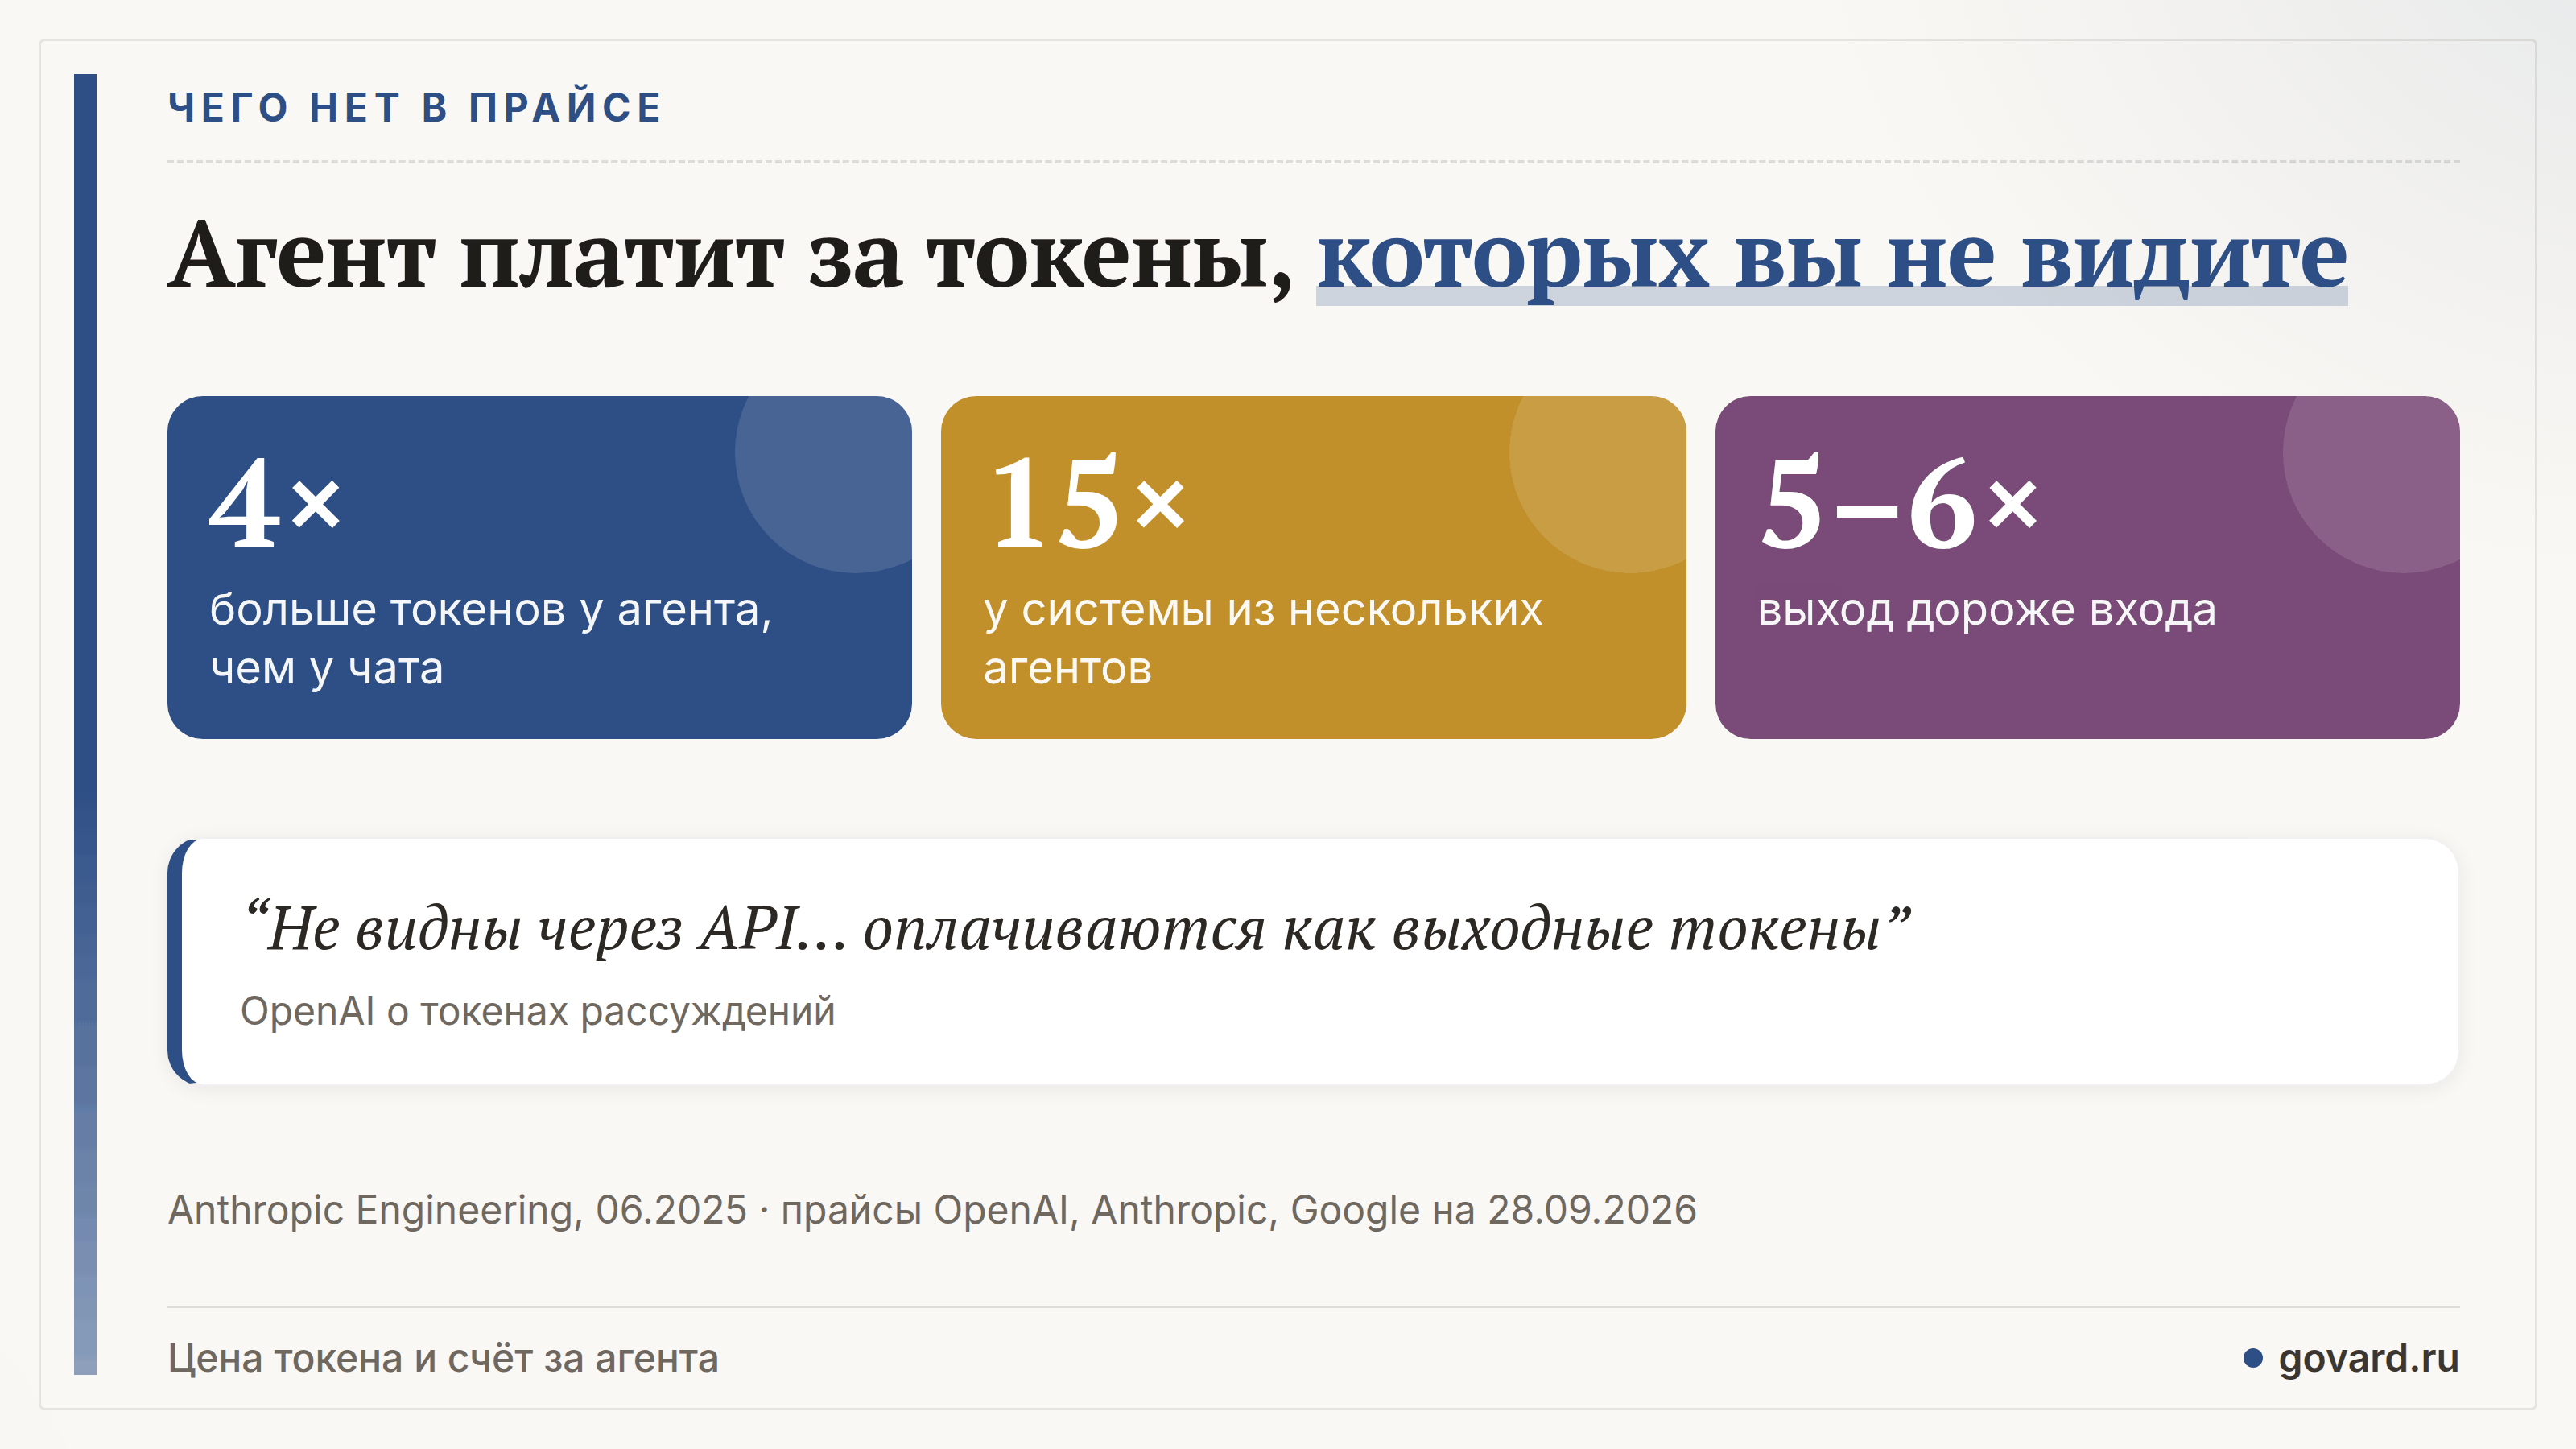
Агент тратит больше токенов, чем чат. Инженеры Anthropic замерили: агенты расходуют примерно в 4 раза больше токенов, чем чат, а системы из нескольких агентов — примерно в 15 раз. В их исследовательской системе объём токенов сам по себе объяснял 80% разброса результатов на тесте BrowseComp.
Рассуждения оплачиваются по цене выходных токенов. OpenAI пишет, что токены рассуждений не видны через API, но оплачиваются как выходные. Anthropic показывает в отчёте об использовании поле thinking_tokens: сколько оплаченных выходных токенов ушло на рассуждения. Google указывает цену выхода Gemini «с учётом токенов рассуждений». У всех трёх вендоров выход в 5–6 раз дороже входа.
Средняя цена это скрывает. Artificial Analysis считает среднюю цену в пропорции 7:2:1: чтение из кэша, вход, выход. У агента, который долго рассуждает, доля выхода больше, и реальная цена миллиона токенов выше средней.
Число токенов может и падать, и именно отсюда приходит настоящая экономия. На тесте FrontierMath для точности около 27% модели o4-mini в апреле 2025 года требовалось примерно 43 млн выходных токенов, а GPT-5.2 в декабре 2025 года — около 5 млн. Токенов стало меньше почти в 9 раз. С учётом разницы в цене моделей Epoch оценивает удешевление результата примерно в 3 раза за восемь месяцев.
05 · Причина третья: в прайсе есть множители
Третья причина — в примечаниях к прайсу. Цена за миллион токенов из заголовка действует только в обычном режиме.
- Длинный контекст. GPT-6 Astra стоит $10 / $50 на коротком контексте и $20 / $75 на длинном. Gemini 3.1 Pro — $2 / $12 и $4 / $18 для запросов длиннее 200 тыс. токенов. Исключение — Anthropic: начиная с Claude 4.6 запрос на 900 тыс. токенов оплачивается по той же ставке, что запрос на 9 тыс. Но не везде: у Claude Haiku 5.5 вход длиннее 100 тыс. токенов стоит в 5 раз дороже.
- Скорость. Быстрый режим Claude Opus 5.5 стоит $8 / $40 против $4 / $20 в обычном, вдвое дороже.
- Промо-цены со сроком. Gemini 3.8 Flash стоит $0,75 / $3,75 до 31.12.2026 и $1,50 / $7,50 с 01.01.2027. Бюджет, посчитанный по промо, в январе удвоится.
- Скидки. DeepSeek вне пиковых часов берёт половину цены. У Сбера асинхронный режим GigaChat вдвое дешевле синхронного: 0,325 ₽ за 1000 токенов у Max вместо 0,65 ₽. Batch API у Anthropic даёт −50% на вход и выход, чтение из кэша обычно стоит 0,1 от цены входа (у Fable 5.1 — 0,025).
Для задач, где ответ не нужен сразу (разбор обращений за ночь, обогащение карточек в CRM, отчёты), асинхронный или пакетный режим — самый простой способ срезать счёт вдвое.
06 · Считайте стоимость выполненной задачи
Все три причины сводятся к одной формуле. Единица, которая имеет значение, — стоимость выполненной задачи:
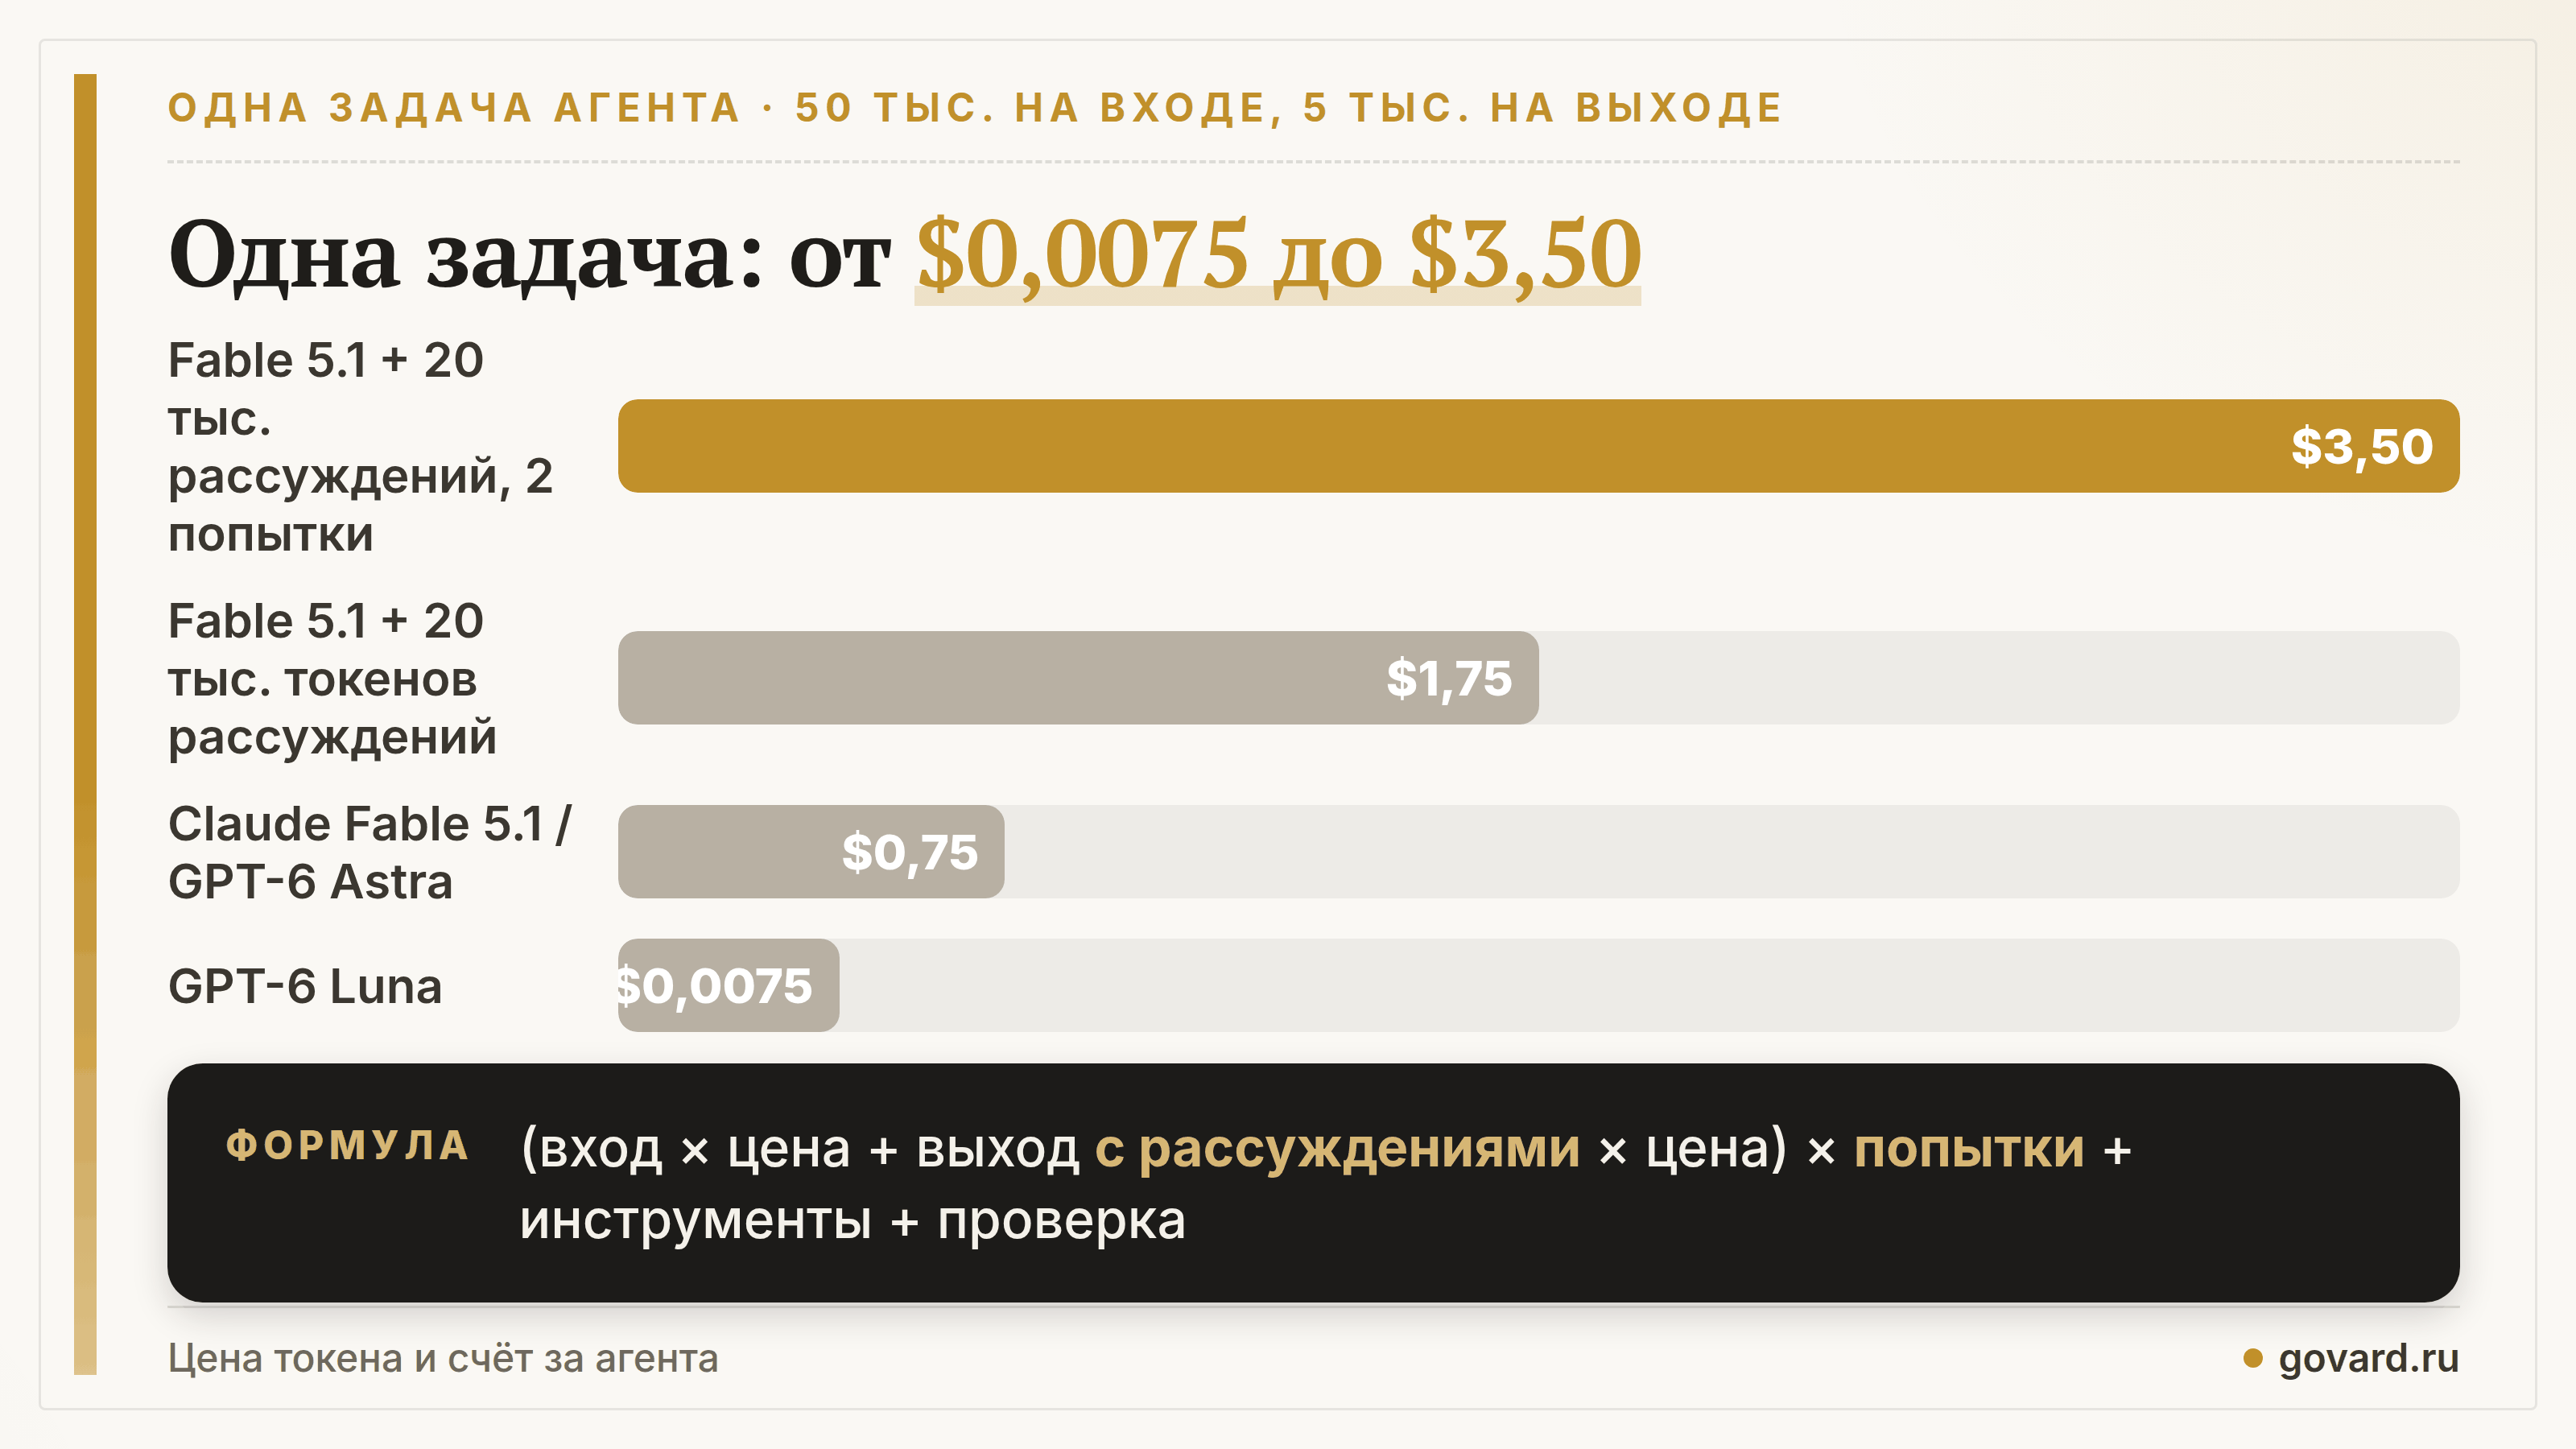
стоимость задачи = (входные токены × цена входа + выходные токены с рассуждениями × цена выхода) × число попыток на один успех + инструменты + проверка человеком
Попытки стоит считать отдельной строкой. Тест Thinkingbox (август 2026 года) собран из 507 бизнес-процессов в пяти отраслях. Самая сильная из проверенных моделей, Claude Opus 5, выполняет 66,5% задач с первого прогона. Во всех 20 прогонах из 20 — только 47,5%. В первой версии статьи GPT-5.4 находила хотя бы один успешный прогон из 20 в 91,1% случаев. Вывод авторов: повторные запуски часто находят одно успешное решение, но надёжным агента не делают. Каждый неудачный прогон оплачивается полностью.
07 · Пример расчёта
Возьмём одну попытку эталонной агентной задачи: 50 тыс. входных и 5 тыс. выходных токенов, без кэша. Цифры посчитаны по прайсам, замера за ними нет.
| Модель | Цена за 1 млн токенов (вход / выход) | Одна попытка |
|---|---|---|
| Claude Opus 4.1 (цена 2025 года) | $15 / $75 | $1,125 |
| Claude Fable 5.1 | $10 / $50 | $0,75 |
| GPT-6 Astra | $10 / $50 | $0,75 |
| Claude Opus 4.5–5 | $5 / $25 | $0,375 |
| Gemini 3.8 Flash, промо → 2027 | $0,75 / $3,75 → $1,50 / $7,50 | $0,056 → $0,113 |
| DeepSeek V4.1 Flash, пик | $0,30 / $1,20 | $0,021 |
| GPT-6 Luna | $0,10 / $0,50 | $0,0075 |
У OpenAI попытка на GPT-6 Luna в 100 раз дешевле, чем на GPT-6 Astra. Luna решит не всё, что решает Astra, но многим шагам агента (маршрутизация, извлечение полей, оформление ответа) верхний уровень не нужен. Больше всего можно сэкономить, если выбирать модель под каждый шаг.
Та же задача на GigaChat, если считать все 55 тыс. токенов по ставке за 1000 токенов из тарифа: Lite — около 3,6 ₽, Pro — 27,5 ₽, Max — около 35,8 ₽ в синхронном режиме. В асинхронном вдвое меньше.
Теперь добавим множители. Допустим, модель ещё потратила 20 тыс. невидимых токенов на рассуждения (это допущение для примера). На Fable 5.1 они стоят $1, и попытка дорожает с $0,75 до $1,75. Если задаче в среднем нужны две попытки, она обходится в $3,50. А с промптом на 300 тыс. токенов Gemini 3.1 Pro берёт за попытку $1,29 вместо $0,66 по ставке короткого контекста.
08 · Что дешевеет, а что нет
Расчёт показывает, какие расходы идут за ценой токена. Полный список:
| Дешевеет | Не дешевеет или дорожает |
|---|---|
| Фиксированный уровень качества: ~13 раз в год (Epoch) | Фронтир: стоимость прогона +3–18 раз в год (MIT FutureTech) |
| Уровень внутри одной линейки: Opus $15/$75 → $5/$25 | Новые верхние уровни: $10/$50 у Anthropic и OpenAI |
| Токены на результат, когда модель рассуждает экономнее: 43 млн → 5 млн | Невидимые токены рассуждений по цене выхода |
| Пакетный режим (−50%), кэш (0,1 от входа), асинхронный GigaChat и DeepSeek вне пика (−50%) | Длинный контекст (до 2 раз), быстрый режим (2 раза), конец промо (2 раза) |
| Повторные попытки, инструменты, проверка человеком |
Gartner приходит к тому же выводу с другой стороны. Аналитик Уилл Соммер: руководители продуктов не могут оправдывать расходы на ИИ тем, что токены дешевеют. Совет Gartner — разделять запросы по уровням моделей, маршрутизировать их и собирать систему из нескольких моделей. Одна универсальная модель на всех участках, по оценке Gartner, обходится на порядки дороже.
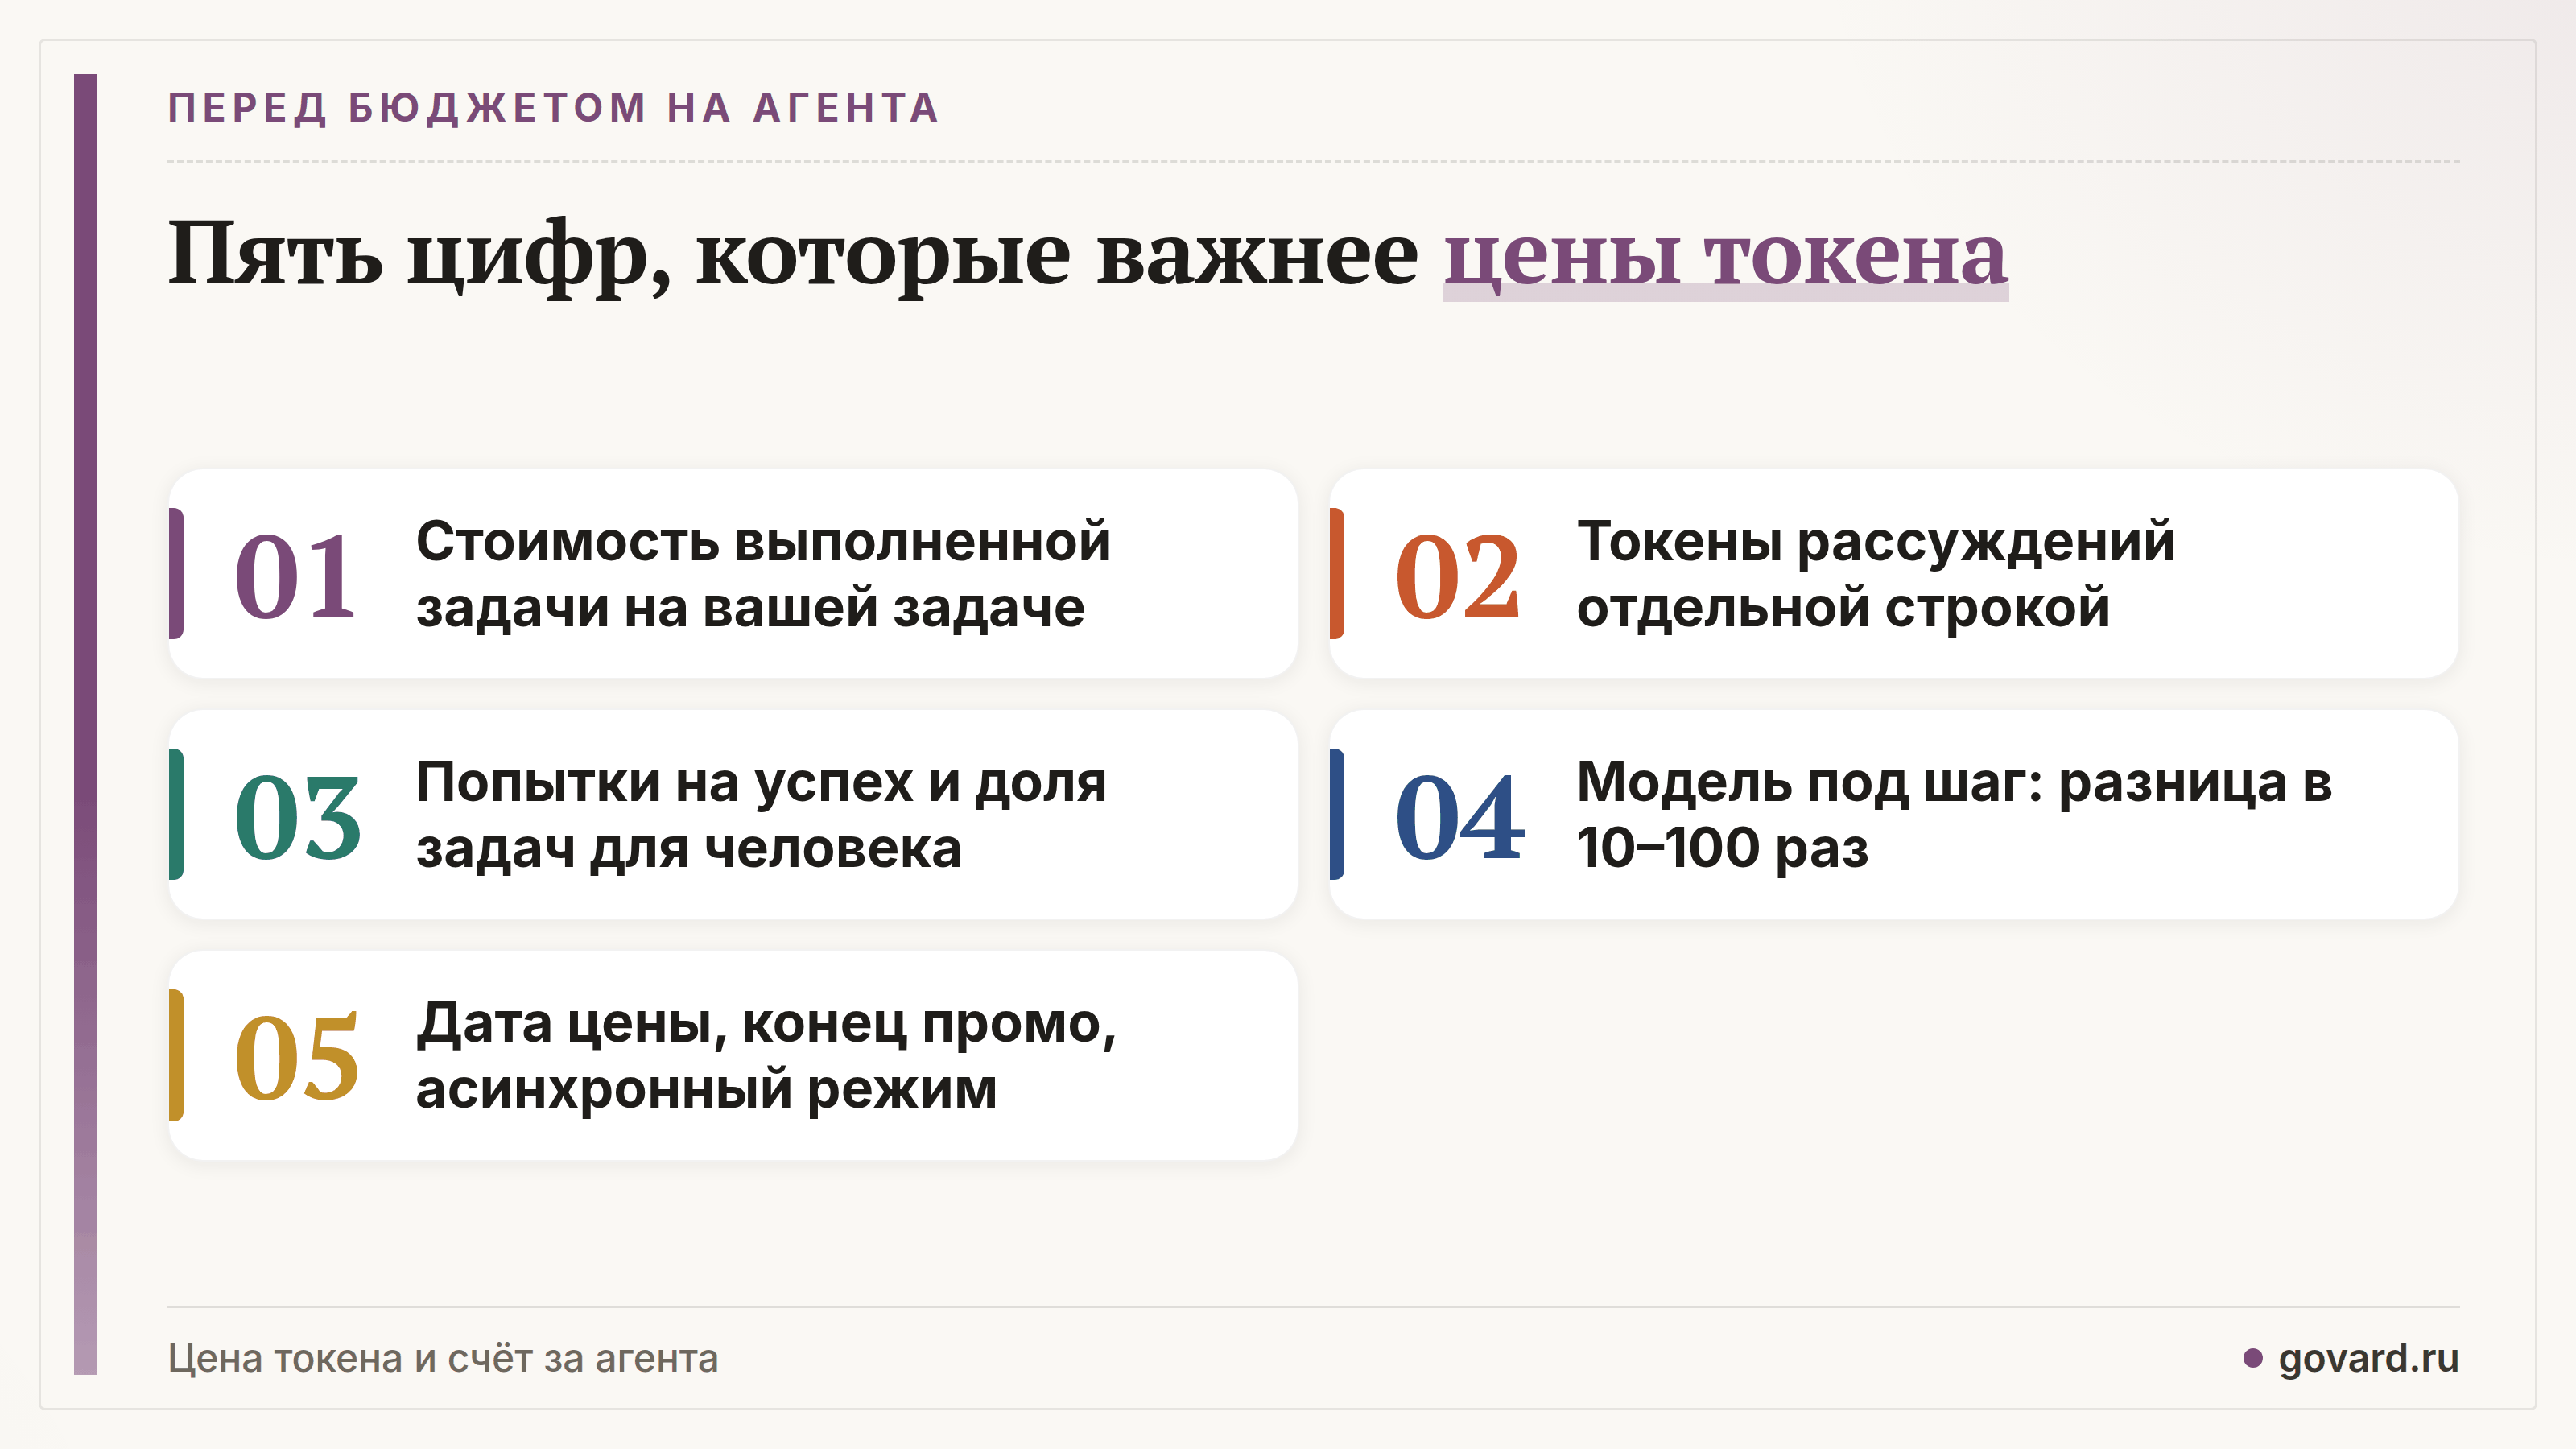
Перед тем как утвердить бюджет на агента, проверьте пять вещей:
- Стоимость выполненной задачи, замеренная на вашей задаче с реальным числом токенов.
- Токены рассуждений отдельной строкой. Сам текст рассуждений не виден, но Anthropic показывает их число в поле
thinking_tokens. - Число попыток на один успех и долю задач, которые доходят до человека.
- Уровень модели под шаг: какие шаги правда требуют верхней модели, а какие можно отдать модели в 10–100 раз дешевле.
- Дату цены: когда проверяли прайс, есть ли промо, порог длинного контекста или асинхронный режим.
09 · Где эти цифры перестают работать
Чек-лист опирается на открытые данные, и у них есть границы.
- Тесты могут завышать удешевление. Epoch предупреждает, что модели могут подгонять под тесты и что пользователи не переходят каждый месяц на самую дешёвую модель. Жан-Станислас Денен из Epoch добавляет, что дистиллированные модели хрупче и непропорционально хорошо проходят тесты.
- Прайсы меняются каждый месяц. Между двумя проверками 27 и 28 сентября верхние уровни на страницах цен Anthropic и OpenAI сменились (Fable 5.1, GPT-6). У каждой цены пишите дату.
- Thinkingbox меряет надёжность на своём наборе процессов. Число попыток на успех нужно брать из своих логов.
- Пятикратный рост у Gartner — прогноз.
- Российские модели. Открытых рядов цен GigaChat и YandexGPT за несколько лет мы не нашли, поэтому темп их удешевления с зарубежным не сравниваем.
Сколько стоит одна выполненная задача у вашего агента и какой шаг съедает больше всего? Если считали — напишите в комментариях в Telegram-канале «ИИ для бизнеса», сравним.