Один ИИ-агент или мультиагентная система: когда в 3–10 раз больше токенов оправданы
Когда нужна мультиагентная система, а когда хватит одного ИИ-агента: что выяснили Anthropic, Cognition, Google Research и исследование MAST, что предлагает российский рынок, сколько стоит мультиагентность в рублях и чек-лист выбора архитектуры.
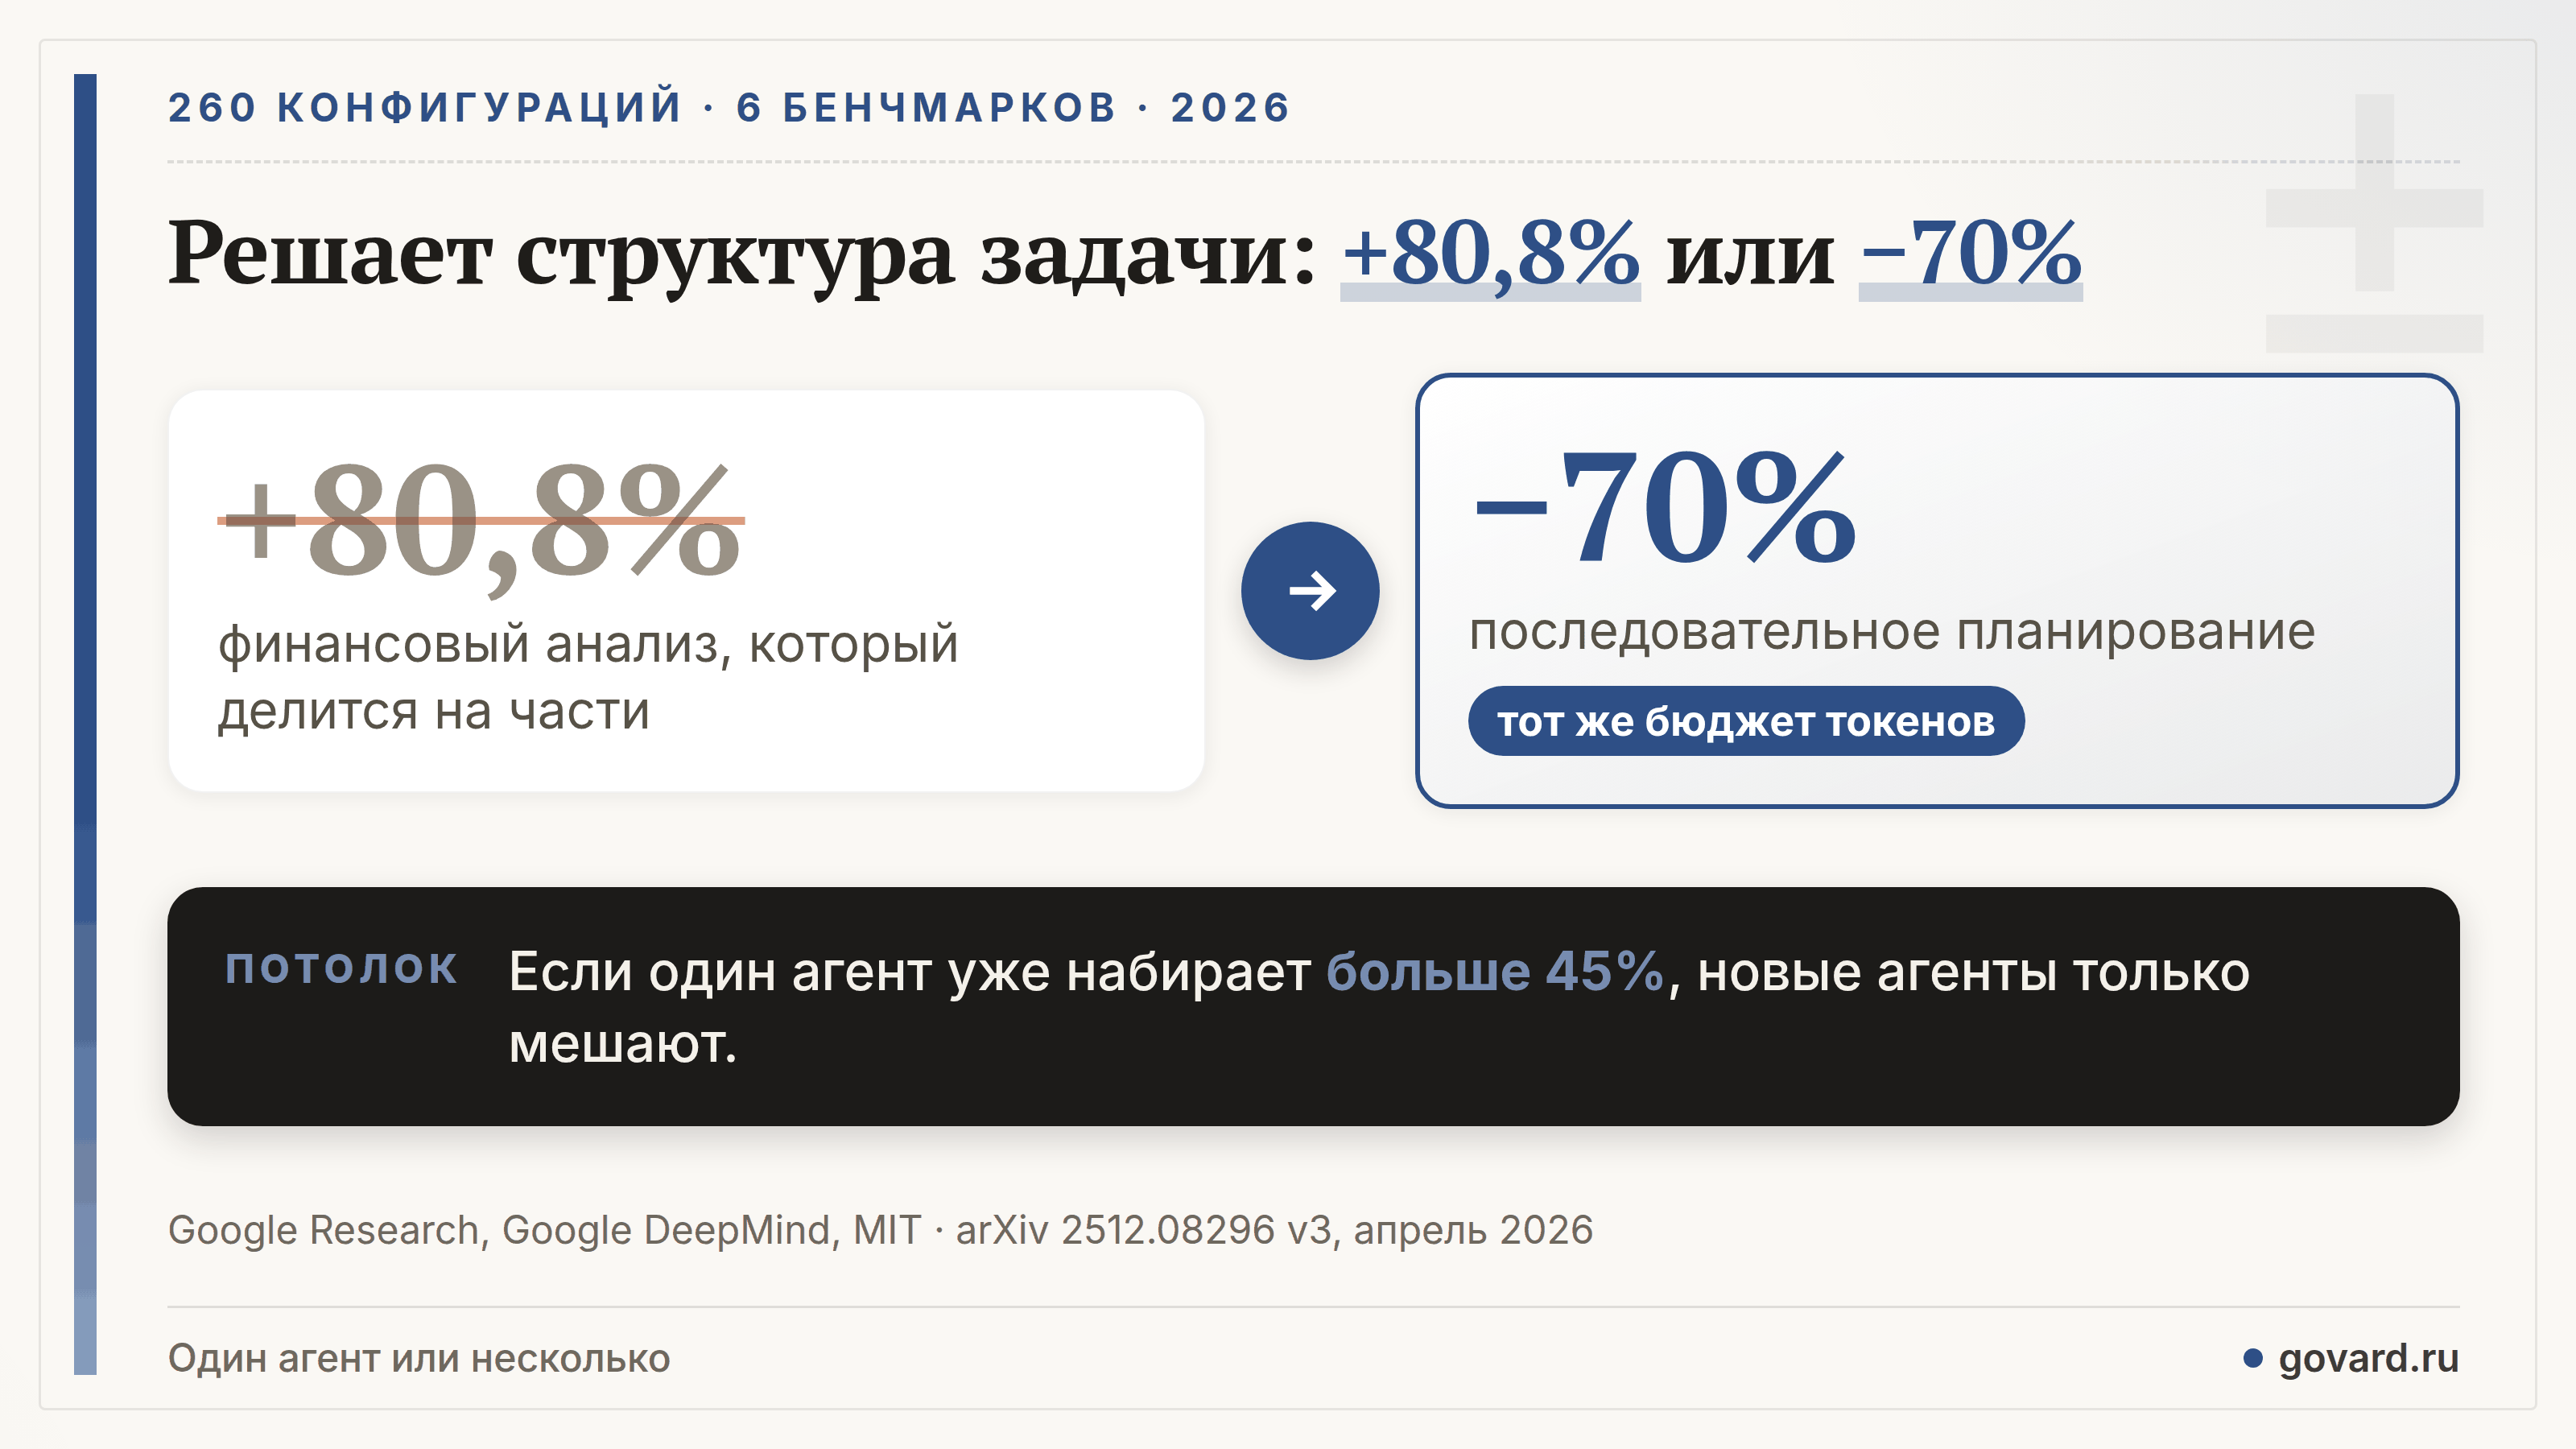
Мультиагентная система окупается, когда задача делится на независимые части, которые можно выполнять параллельно, каждой части нужен свой контекст, а результат достаточно ценен, чтобы оплатить в 3–10 раз больше токенов, чем потратил бы один агент. В остальных случаях обычно выигрывает один агент с хорошими инструментами. Исследование Google Research, Google DeepMind и MIT показывает, насколько велик разрыв: на финансовом анализе, который делится на части, координация агентов улучшила результат на 80,8%, на последовательном планировании — ухудшила до 70%.
Для российского бизнеса вопрос практический. Готовых агентов на рынке почти нет, платформы для сборки — есть, и решение «один агент или команда» приходится принимать заказчику и подрядчику.
01 · Спор 2025 года: две статьи с разницей в день
В июне 2025 года две команды с разницей в один день опубликовали противоположные выводы.
Первой, 12 июня, вышла статья Cognition, разработчика агента Devin, «Don’t Build Multi-Agents» («Не стройте мультиагентные системы»). Два её принципа: агентам нужен полный общий контекст, а любое действие несёт неявные решения, и противоречащие решения дают плохой результат. Два субагента, которые собирают части одного приложения и не видят работу друг друга, делают несовместимые куски.
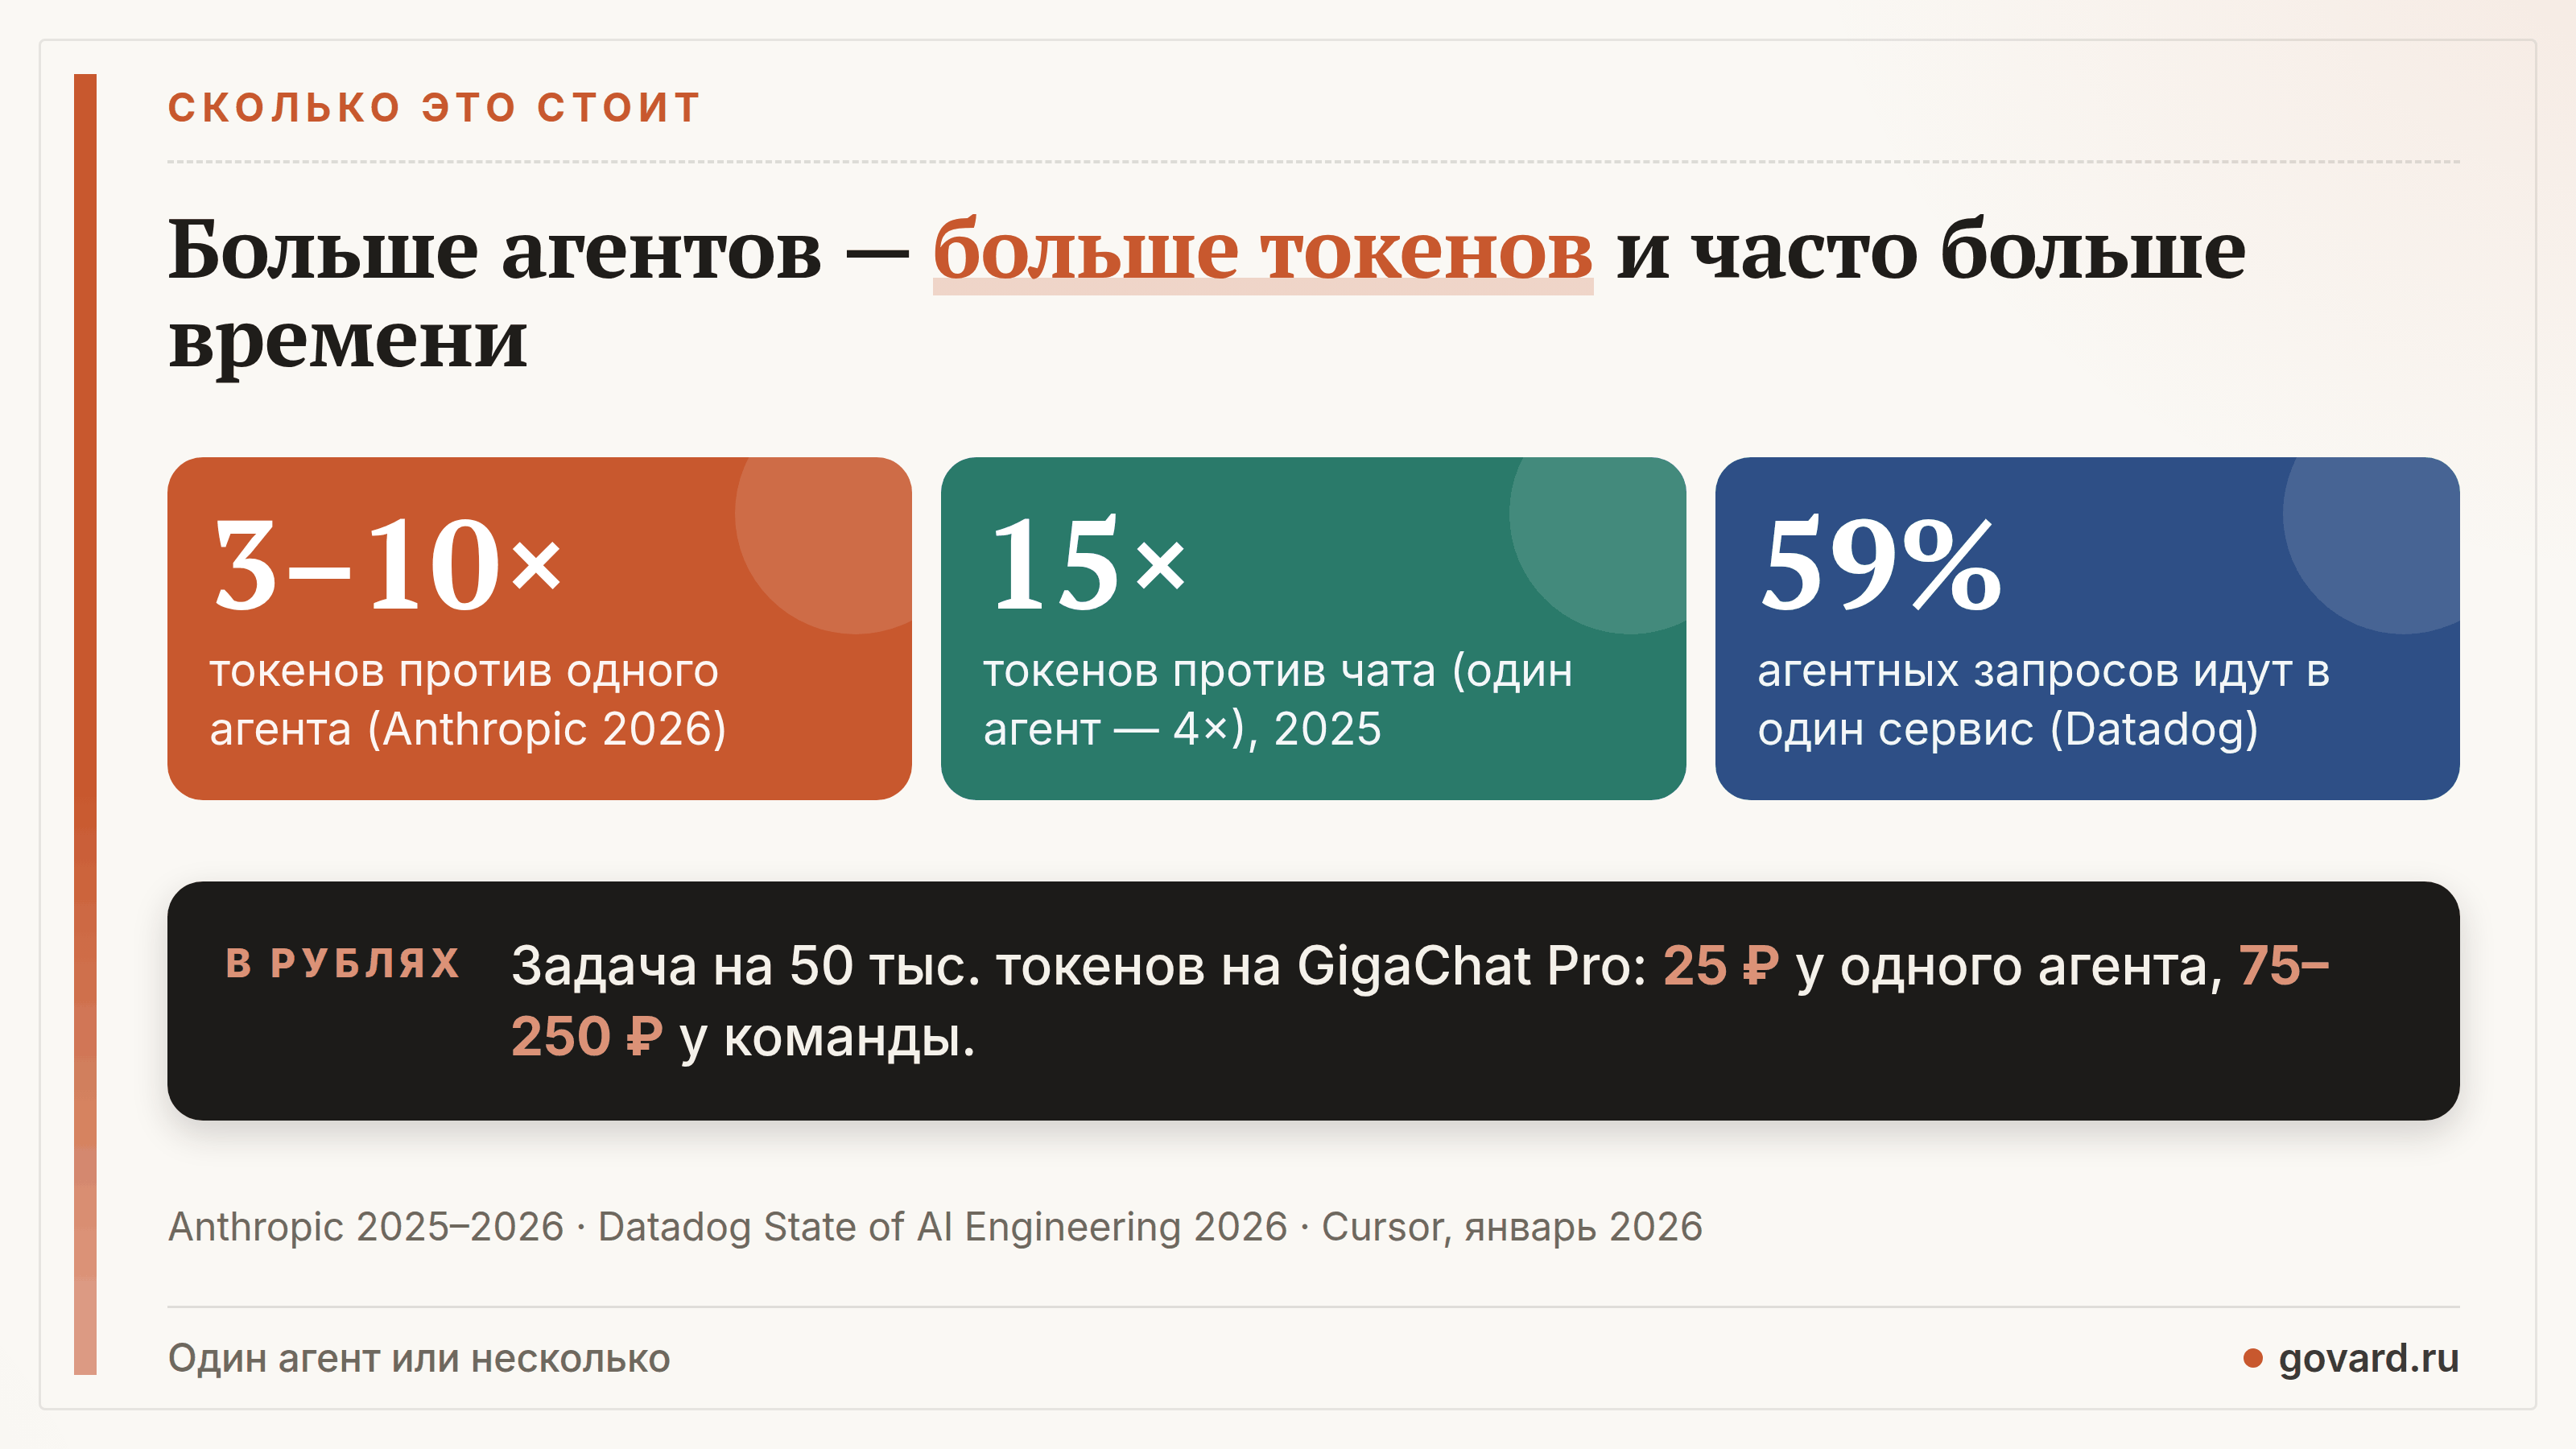
13 июня Anthropic рассказала о своей функции Research: ведущий агент на Claude Opus 4 с субагентами на Sonnet 4 на внутреннем тесте показал результат на 90,2% выше, чем одиночный Opus 4. Цена — токены: один агент тратил примерно в 4 раза больше токенов, чем чат, мультиагентная система — примерно в 15 раз больше, чем чат. На бенчмарке BrowseComp один только расход токенов объяснял 80% разброса результатов.
Каждая сторона была права для своей задачи. У Anthropic это широкий поиск информации, где субагенты параллельно читают разные источники. Сама Anthropic писала, что области, где агентам нужен общий контекст или много зависимостей между ними, пока плохо подходят для мультиагентных систем, и приводила в пример большинство задач программирования.
02 · Что измерили исследования
Вскоре у спора появились цифры. Google Research, Google DeepMind и MIT впервые опубликовали исследование в декабре 2025 года, третья версия (апрель 2026) охватывает 260 конфигураций: шесть бенчмарков для агентов, пять архитектур (один агент и четыре мультиагентные схемы) и три семейства моделей. Инструменты, промпты и общий бюджет токенов на рассуждения были одинаковыми, поэтому сравнение показывает эффект именно архитектуры.
Для проектирования важны четыре вывода:
- Знак эффекта определяет структура задачи. Разброс — от +80,8% на финансовом анализе до −70,0% на последовательном планировании. По сводке Google, на задаче планирования PlanCraft все проверенные мультиагентные варианты оказались хуже на 39–70%.
- Есть потолок. Если один агент уже набирает больше 45%, дополнительные агенты дают отрицательный эффект: затраты на координацию больше возможного прироста. На SWE-bench Verified все мультиагентные архитектуры были немного хуже одного агента.
- Ошибки умножаются. Независимые агенты без проверки усиливали ошибки в 17,2 раза относительно одного агента. Центральный оркестратор, который проверяет результаты, сдерживал усиление до 4,4 раза.
- Координация стоит токенов. Накладные расходы на общение агентов — от 58% у независимых до 515% у гибридных схем.
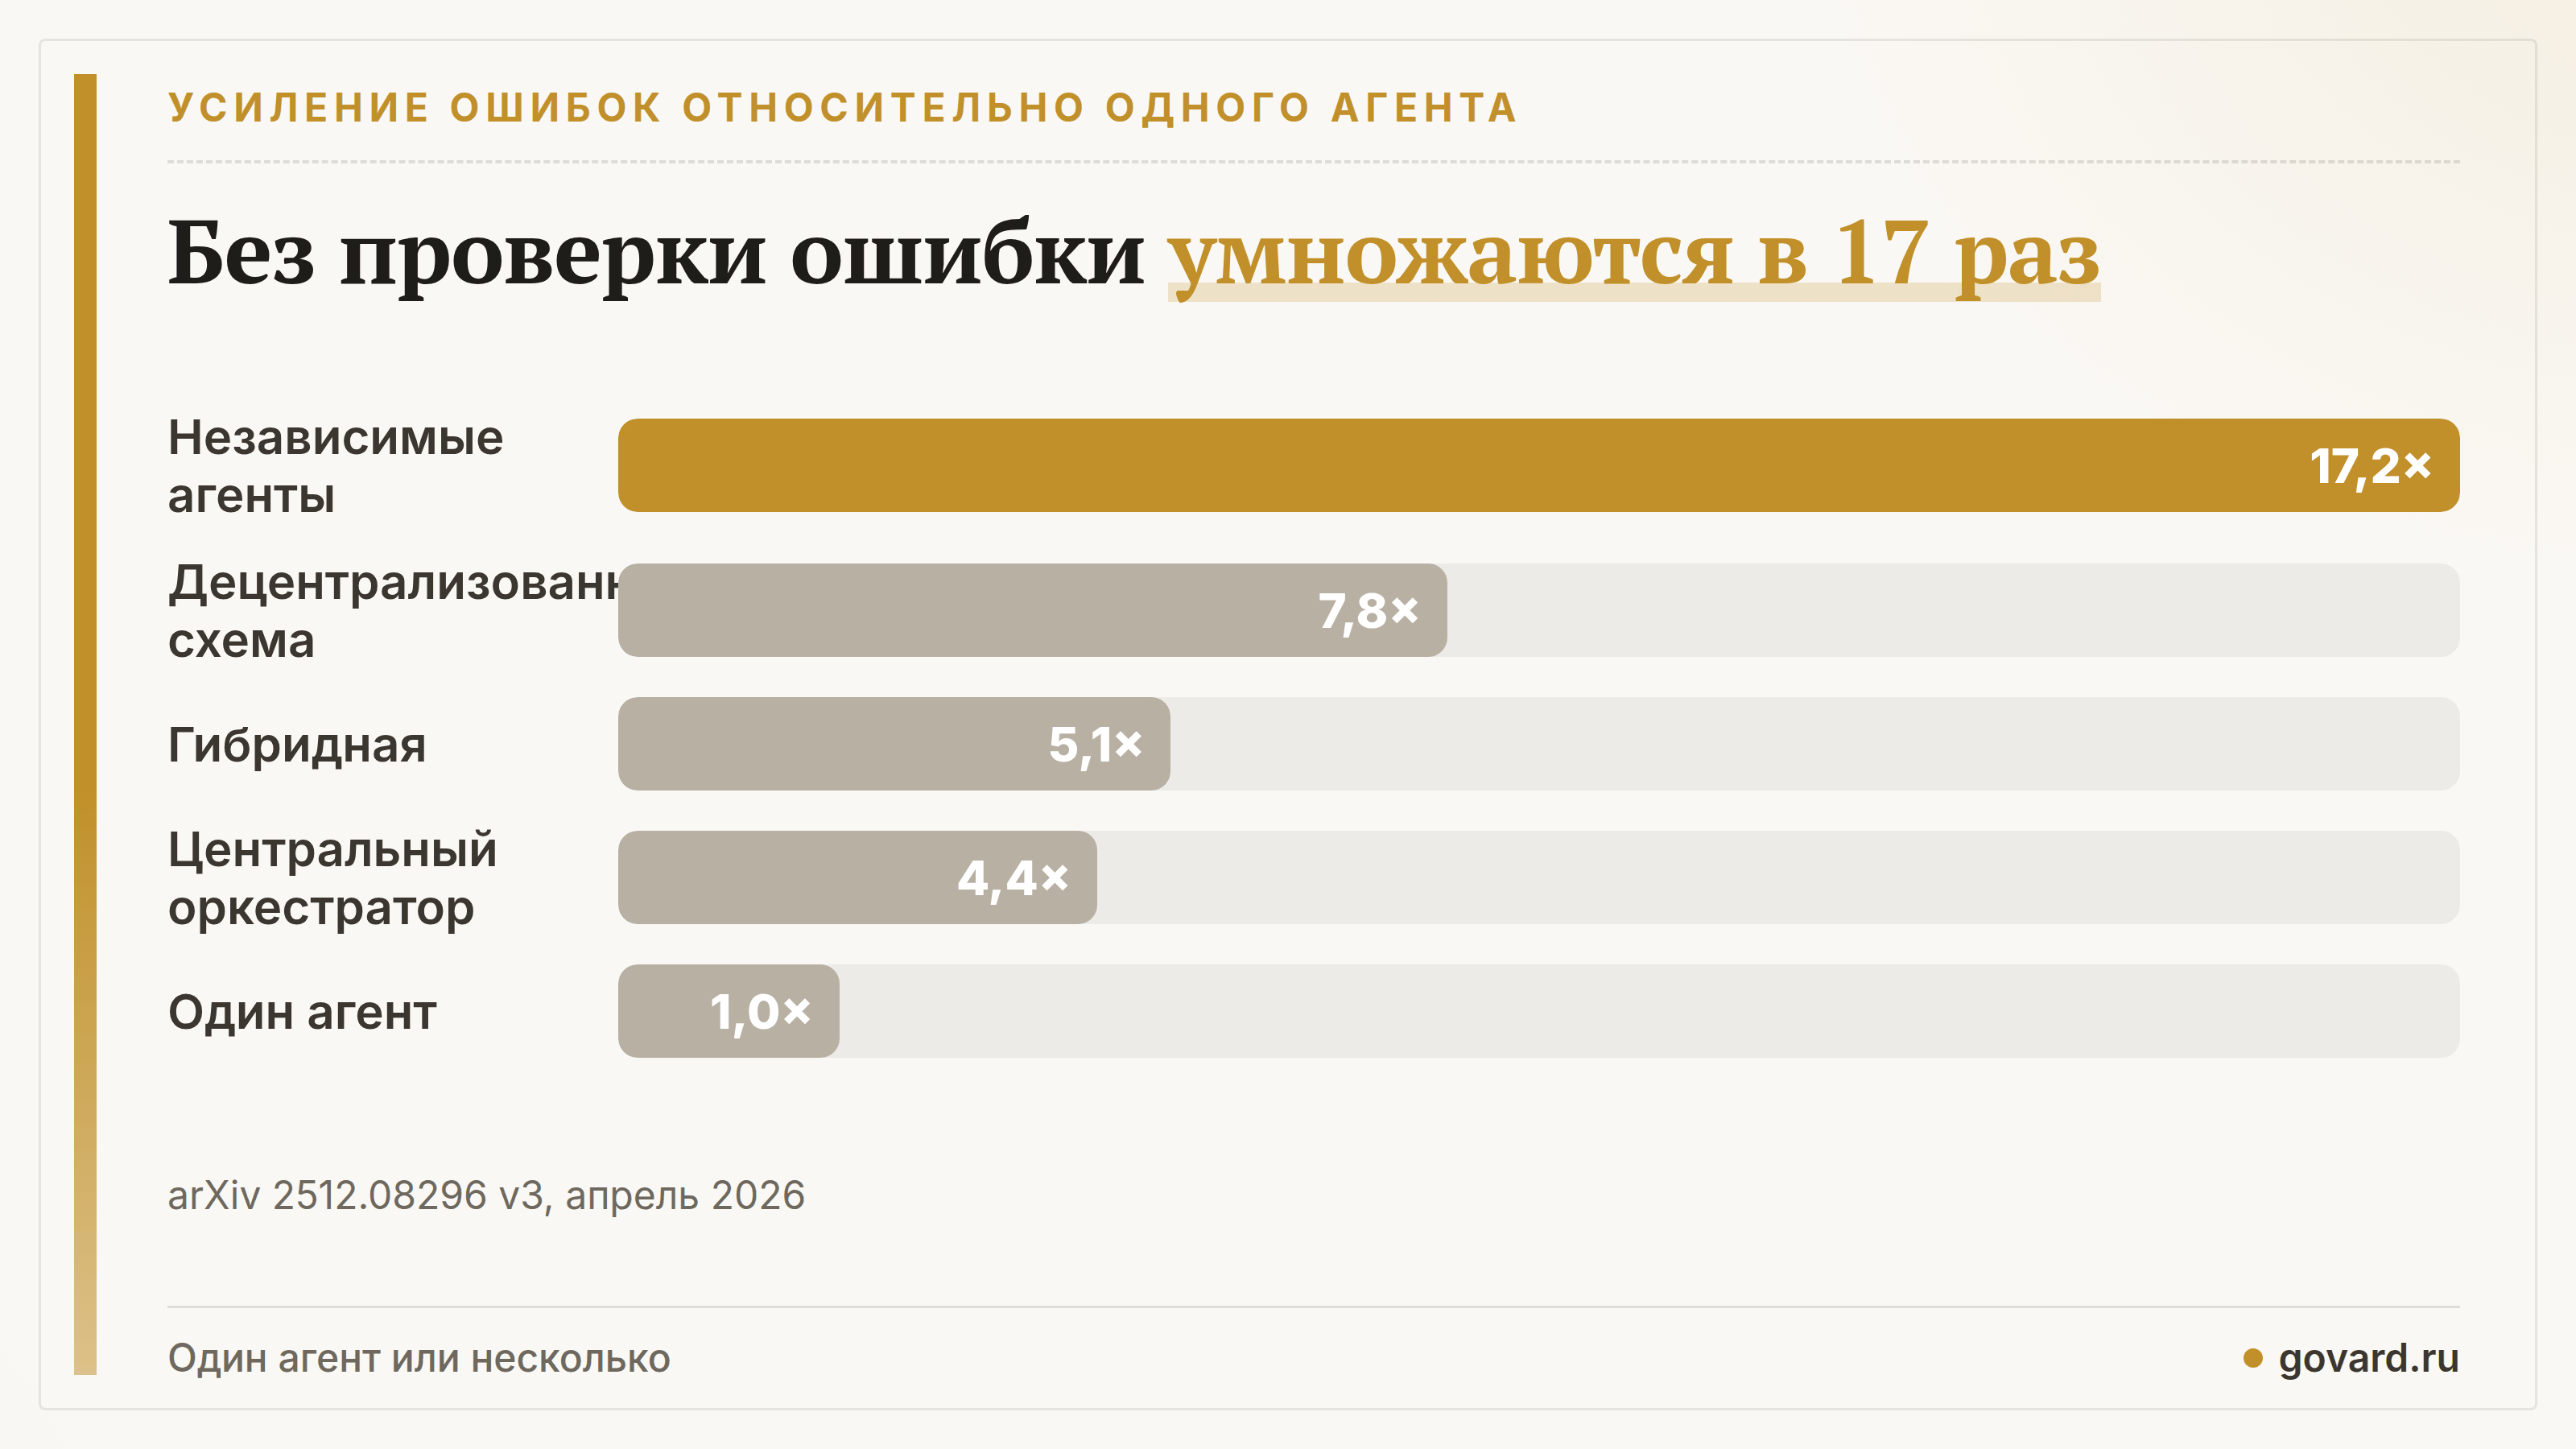
Работа Трана и Килы (апрель 2026) уточняет вывод: при одинаковом бюджете токенов на рассуждения один агент не уступал мультиагентной системе на задачах с цепочкой выводов, то есть на последовательной работе. Часть выигрыша, который приписывают архитектуре, даёт дополнительный объём вычислений. Их же модель предсказывает, где несколько агентов выигрывают: когда один агент плохо справляется со своим контекстом. Это тот самый случай «засорения контекста», о котором ниже.
03 · Где мультиагентные системы дают сбой
Цифры успеха не объясняют, почему мультиагентные схемы проваливаются. На этот вопрос отвечает исследование MAST из Калифорнийского университета в Беркли. Команда разметила больше 1 600 журналов работы семи популярных open-source фреймворков и нашла долю провалов от 41% до 86,7%.
Авторы выделили 14 типов сбоев в трёх группах: устройство системы, рассогласование агентов и проверка результата. Самые частые:
- агент повторяет уже сделанные шаги (15,7% журналов);
- агент рассуждает об одном, а делает другое (13,2%);
- агент не понимает, что задача решена (12,4%);
- требования задачи игнорируются (11,8%);
- проверка результата слабая или неверная (9,1%).
Часть сбоев можно убрать, изменив схему. В ChatDev доля успешных задач выросла на 9,4%, когда последнее слово оставили за агентом-«директором». Но, по словам авторов, надёжность часто требует большего, чем точечные исправления. Сбои координации возникали даже тогда, когда агенты одного фреймворка общались на обычном языке, поэтому протоколы вроде MCP или A2A их не снимают.
04 · К чему пришли обе стороны
К 2026 году позиции сблизились, и общее правило получилось практичным.
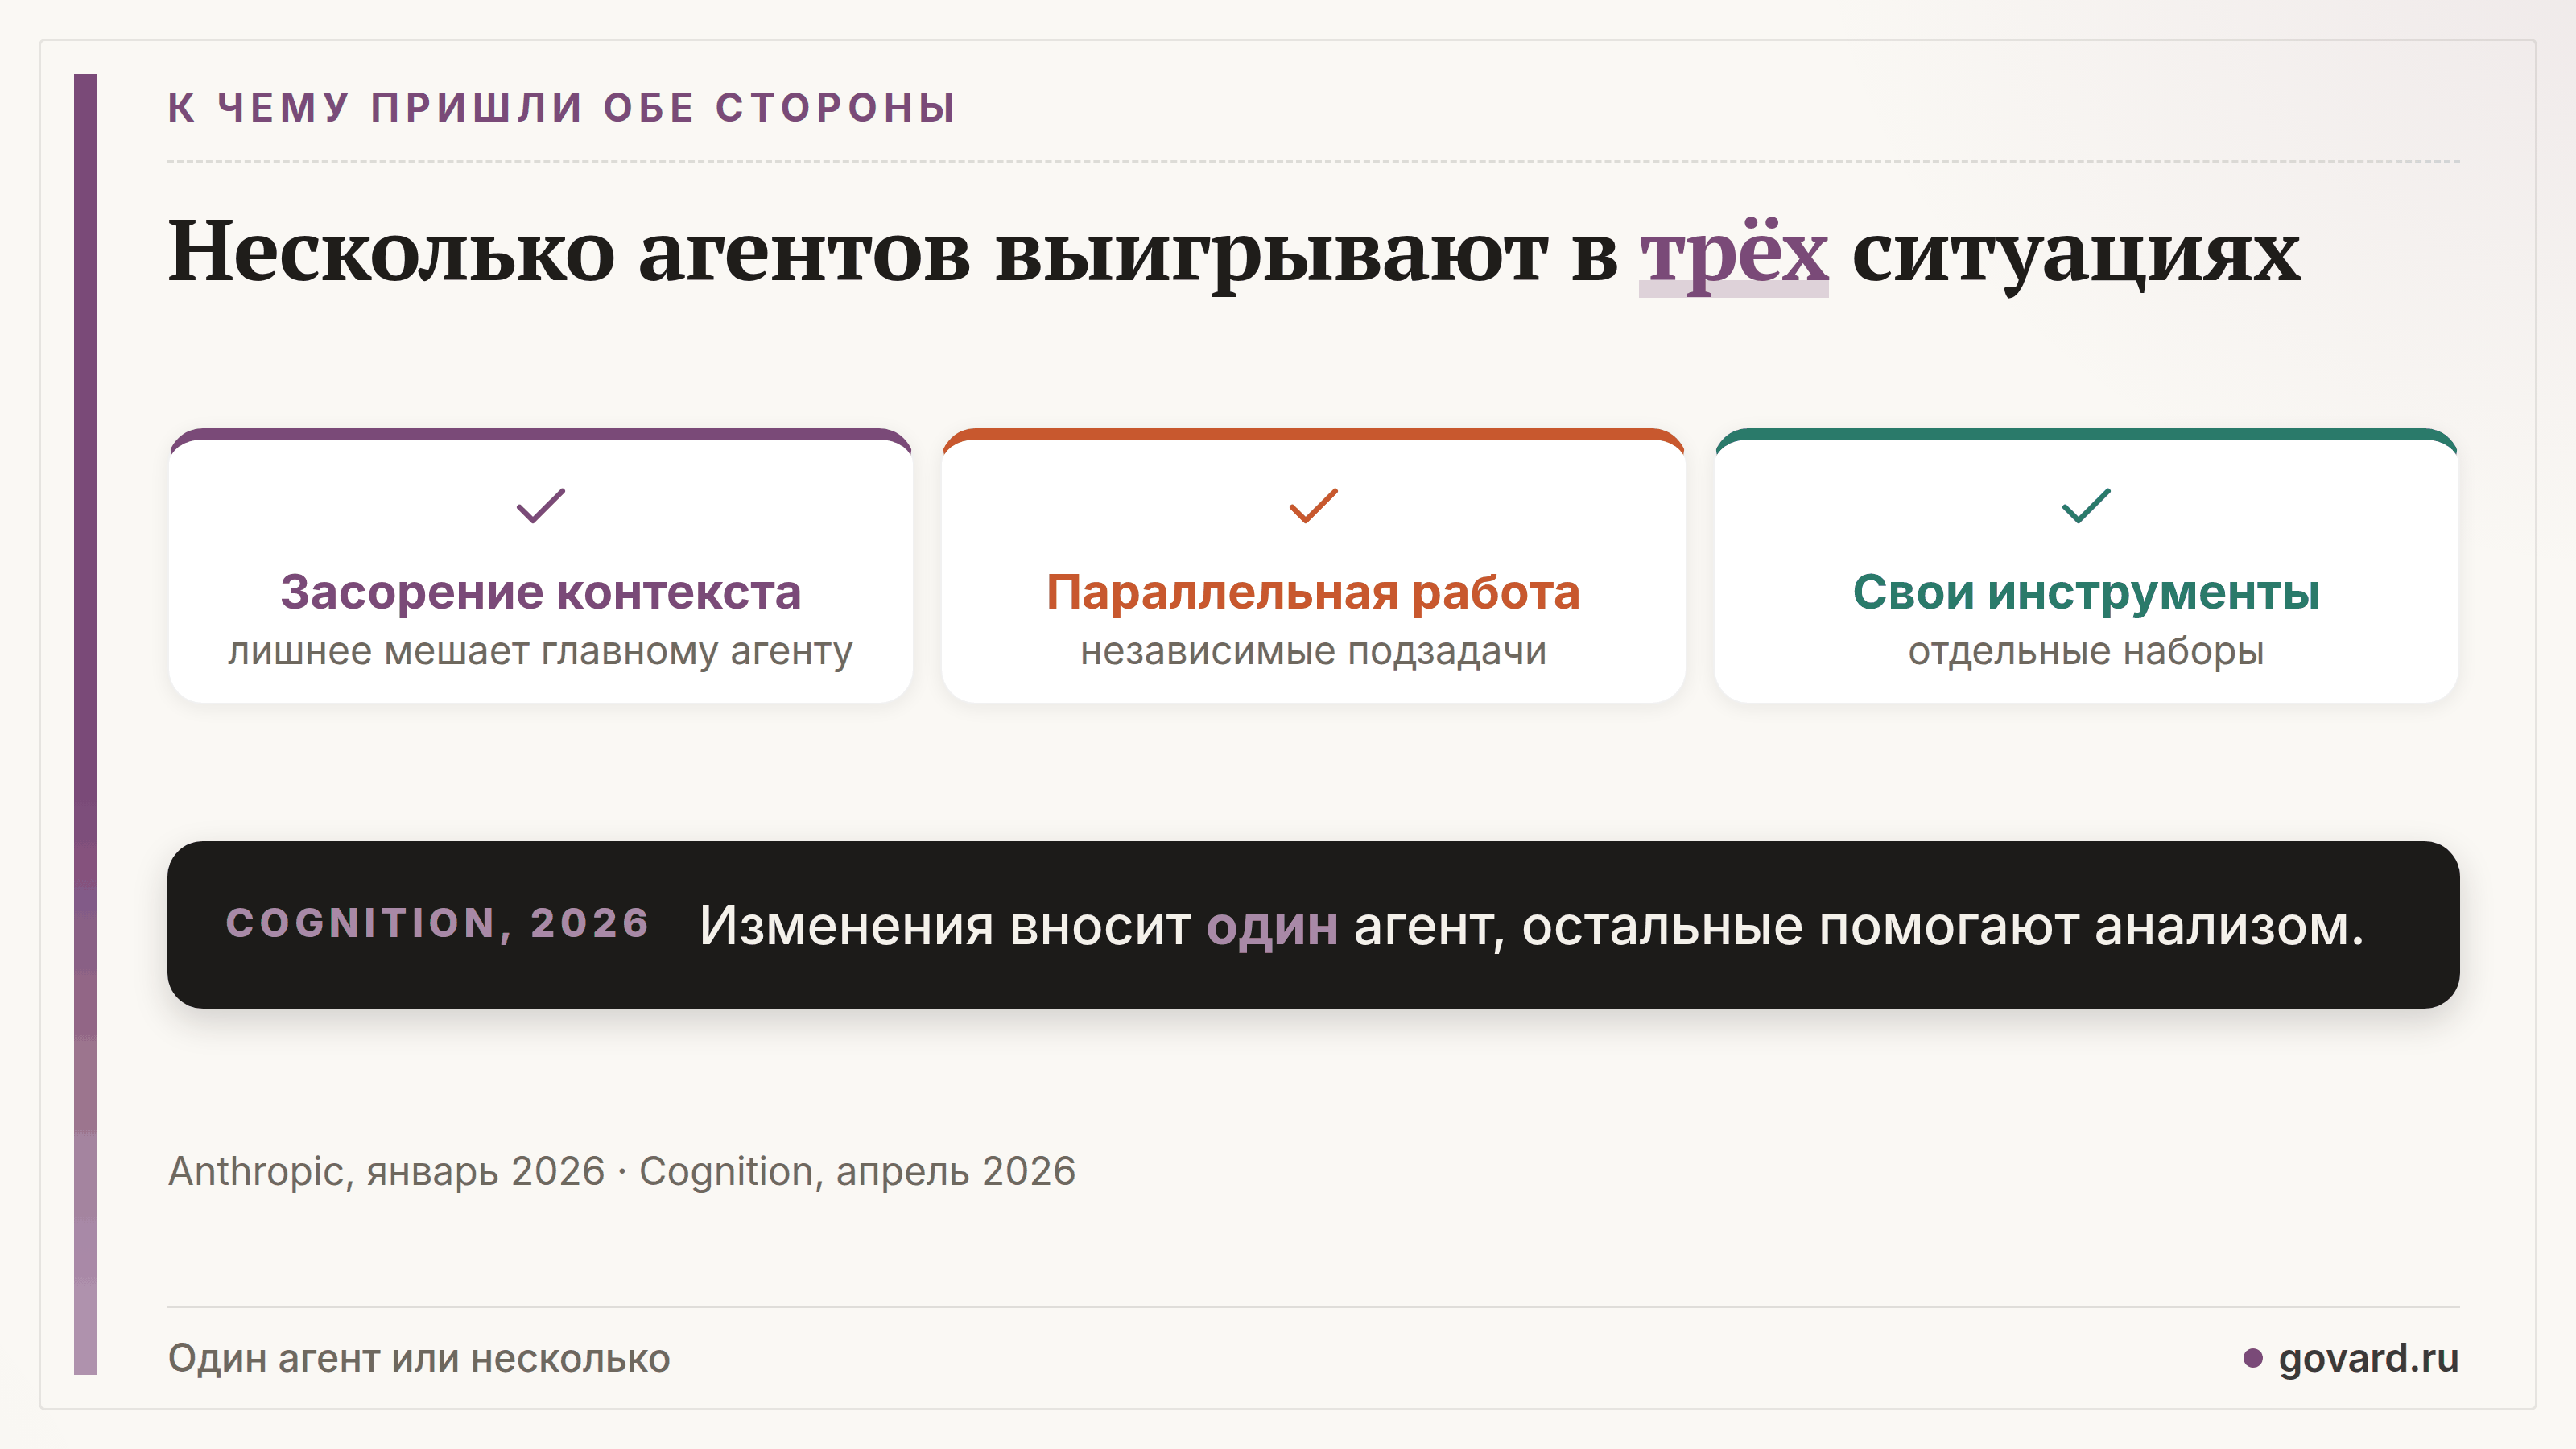
Cognition обновила взгляд в апреле 2026 года. Рой агентов, которые параллельно меняют один результат, по-прежнему не работает. Работает другой класс схем: изменения вносит один агент, остальные только помогают анализом. Примеры Cognition — ревьюер кода с чистым контекстом и дорогая модель, к которой дешёвая обращается как к инструменту.
Anthropic в январе 2026 года назвала три ситуации, в которых несколько агентов стабильно сильнее одного:
- засорение контекста, когда посторонний материал ухудшает работу главного агента;
- параллельная работа, когда подзадачи действительно независимы;
- специализация, когда отдельные наборы инструментов или фокус улучшают выбор действий.
Вне этих ситуаций, по оценке Anthropic, затраты на координацию обычно превышают пользу. Компания предупреждает: команды месяцами строили сложные мультиагентные архитектуры, а потом обнаруживали, что улучшенный промпт одного агента даёт тот же результат.
Ещё одна деталь меняет сам способ деления. Anthropic советует делить задачу по границам контекста. Деление «по должностям» в её же эксперименте не сработало: когда агентов разделили на планировщика, исполнителя, тестировщика и ревьюера, субагенты тратили на координацию больше токенов, чем на саму работу. Агент, который делает функцию, должен писать и тесты к ней: контекст у него уже есть.
05 · Что предлагает российский рынок
На российском рынке выбор архитектуры чаще всего остаётся за заказчиком. «Яков и Партнёры» в июле 2026 года проанализировали 30 ИИ-продуктов и 65 публичных внедрений: среди 12 публично доступных российских продуктов готовых ИИ-агентов не оказалось. Четыре лидера — платформы для сборки агентов, восемь — ассистенты и чат-боты.
Платформы предлагают готовые роли. В GigaCowork от Сбера есть витрина ролей для агентов и запуск по расписанию и событиям; по словам Андрея Белевцева, за четыре месяца платформой воспользовались несколько десятков тысяч пользователей. Витрина ролей удобна для старта, но правило Anthropic остаётся в силе: агентов «по должностям», которые делят одну задачу с общим контекстом, легко превратить в систему, где координация съедает работу.
Хороший пример правила «изменения вносит один» — Т-Инвестиции. Клиенты подключают внешних ИИ-агентов через MCP с тремя уровнями доступа: только просмотр, просмотр и поручения, просмотр, поручения и переводы между своими счетами. При этом, как сообщает CNews, агент не может выполнять операции без подтверждения человека. Агенты анализируют, а решение о действии остаётся одно и проходит через человека.
06 · Сколько агентов нужно
Если задача подходит под условия, следующий вопрос — сколько агентов. Исследовательская система Anthropic начала с неверного ответа: ранние версии запускали 50 субагентов на простой запрос и отвлекали друг друга сообщениями. Помогло правило масштабирования, записанное в промпт:
- простой поиск факта — один агент и 3–10 вызовов инструментов;
- прямое сравнение — 2–4 субагента по 10–15 вызовов;
- сложное исследование — больше 10 субагентов с чётко разделёнными зонами ответственности.
Десять агентов — это верх шкалы, для широких задач с множеством независимых частей.
07 · Сначала попробуйте дешёвые решения
У многих причин добавить агентов есть решения дешевле — внутри одного агента:
- Слишком много инструментов. Anthropic предлагает поиск по инструментам, когда их у агента 15–20 и больше, и сообщает о сокращении токенов до 85% при более точном выборе. Vercel убрал 80% инструментов у агента, который пишет SQL-запросы: успех вырос с 80% до 100% на пяти тестовых запросах, ответы стали в 3,5 раза быстрее.
- Сложная логика или похожие инструменты. Руководство OpenAI называет два повода делить агента: промпт, заполненный условиями «если — то — иначе», и инструменты, которые пересекаются по смыслу. У одних команд работают 15+ чётких инструментов, у других агент путается в 10 похожих. Совет OpenAI — сначала выжать максимум из одного агента.
- Засорённый контекст. Субагент, который в своём окне ищет информацию или читает логи и возвращает выжимку, изолирует контекст без полной мультиагентной схемы. Так устроен Claude Code.
- Повторяющиеся знания. Навыки агента (Agent Skills — папки с инструкциями и скриптами, которые подгружаются по необходимости) специализируют одного агента вместо отдельного агента под каждый сценарий.
Данные эксплуатации говорят о том же. По отчёту Datadog State of AI Engineering 2026, 59% запросов к агентным приложениям обращались к одному сервису и только 18% — к трём и более. Вывод Datadog: подавляющее большинство агентов пока монолиты. Datadog считает вызовы сервисов, а не агентов, поэтому это косвенный признак.
08 · Деньги и время
Счёт растёт вместе с числом агентов. По рекомендациям Anthropic 2026 года, мультиагентные реализации обычно тратят в 3–10 раз больше токенов, чем один агент на той же задаче, и часто работают дольше. Главный выигрыш — полнота результата, общее время при этом часто растёт. Субагенты, которые работают по очереди, дают мультиагентные расходы без выигрыша во времени.
В рублях это выглядит так (расчёт по тарифу GigaChat Pro для юрлиц, 0,5 ₽ за 1000 токенов в синхронном режиме, тариф проверен 10.10.2026): задача на 50 тыс. токенов у одного агента стоит около 25 ₽, у мультиагентной схемы — от 75 до 250 ₽. На тысяче таких задач в месяц разница — от 50 до 225 тыс. ₽. Подробнее о том, почему счёт за агента не падает вместе с ценой токена, — в разборе цен на токены.
У масштаба свои пределы. Cursor попробовал 20 агентов, которые координировались через общий файл с блокировками: они работали со скоростью двух-трёх, потому что ждали друг друга, и команда перешла на схему «планировщики и исполнители». Команда из 16 параллельных агентов Anthropic написала компилятор C примерно за 2 000 сессий и чуть меньше $20 тыс. на API. На ядре Linux, одной огромной задаче, все агенты упирались в одну и ту же ошибку и затирали исправления друг друга. Выйти из тупика помогла внешняя точка сверки — компилятор GCC. Cognition замечает, что у таких демонстраций есть простой проверяемый критерий успеха, которого у большинства реальных программ нет.
09 · Пример: десять агентов-специалистов для проверки сметной документации
Стройинтеллект — продукт для проверки сметной документации, где я владелец продукта и основной разработчик. Десять агентов-специалистов (сметчик, главный инженер, экономист, договорник и другие) и оркестратор проверяют полный пакет проекта — сметы, PDF-чертежи, договоры, — и система выдаёт один вердикт, замечания и пакет из десяти документов отчёта. Задача подходит под условия выше: проверка — это в основном чтение, а LangChain отмечает, что «читающими» мультиагентными системами управлять проще, чем «пишущими»; специалистам нужны разные компетенции, и у каждого агента свой чек-лист приёмки; результат — один вердикт. Деньги и арифметику считает обычный код, каждая цифра ссылается на файл, лист и строку сметы: агенты объясняют цифры, считает их код.
Одна и та же проверка может работать в четырёх режимах: параллельный конвейер со строгими JSON-схемами, быстрый режим с одним агентом, цикл агента с инструментами и команда агентов на OpenAI Codex SDK, которые передают работу друг другу. Самые заметные цифры продукта при этом связаны с данными и инженерией: справочная база из 103 тыс. позиций федеральных расценок и 150+ нормативов подняла точность разбора на внутреннем эталонном наборе с 21% до 86%, а прогон агента сократился с 11 минут до 67 секунд. На мой взгляд, данные и инженерия вокруг агентов важны не меньше, чем их число.
10 · Где эти выводы перестают работать
- Модели стареют. MAST изучал модели 2025 года (GPT-4o, Claude 3.7 Sonnet) на open-source фреймворках; на моделях 2026 года доли сбоев могут быть другими.
- Часть цифр — самоотчёты. 90,2% у Anthropic — внутренний неопубликованный тест. Данные Cursor, компилятора C и Cognition — отчёты самих компаний.
- У источников есть интересы. Anthropic продаёт управляемые мультиагентные системы, Cognition — Devin, LangChain — LangGraph, Сбер — GigaCowork.
- Один агент становится сильнее. Сжатие контекста и поиск по инструментам постепенно сужают случай «засорения контекста».
11 · Чек-лист: один агент или несколько
Перед тем как добавить агента — или согласиться на мультиагентную схему у подрядчика, — ответьте на пять вопросов:
- Делится ли задача на независимые части? Если второму шагу нужен результат первого — оставьте одного агента.
- Нужен ли каждой части свой контекст? Если агентам нужен общий полный контекст, деление добавит координацию без пользы.
- Кто вносит изменения? Итоговый результат пишет один агент или человек, остальные читают, проверяют и советуют.
- Окупает ли ценность задачи в 3–10 раз больше токенов и более долгую работу? Аналитический отчёт — возможно, рутинное обновление сделки в CRM — обычно нет.
- Попробованы ли дешёвые решения? Лучший промпт, меньше инструментов или поиск по ним, субагент для чтения, навыки.
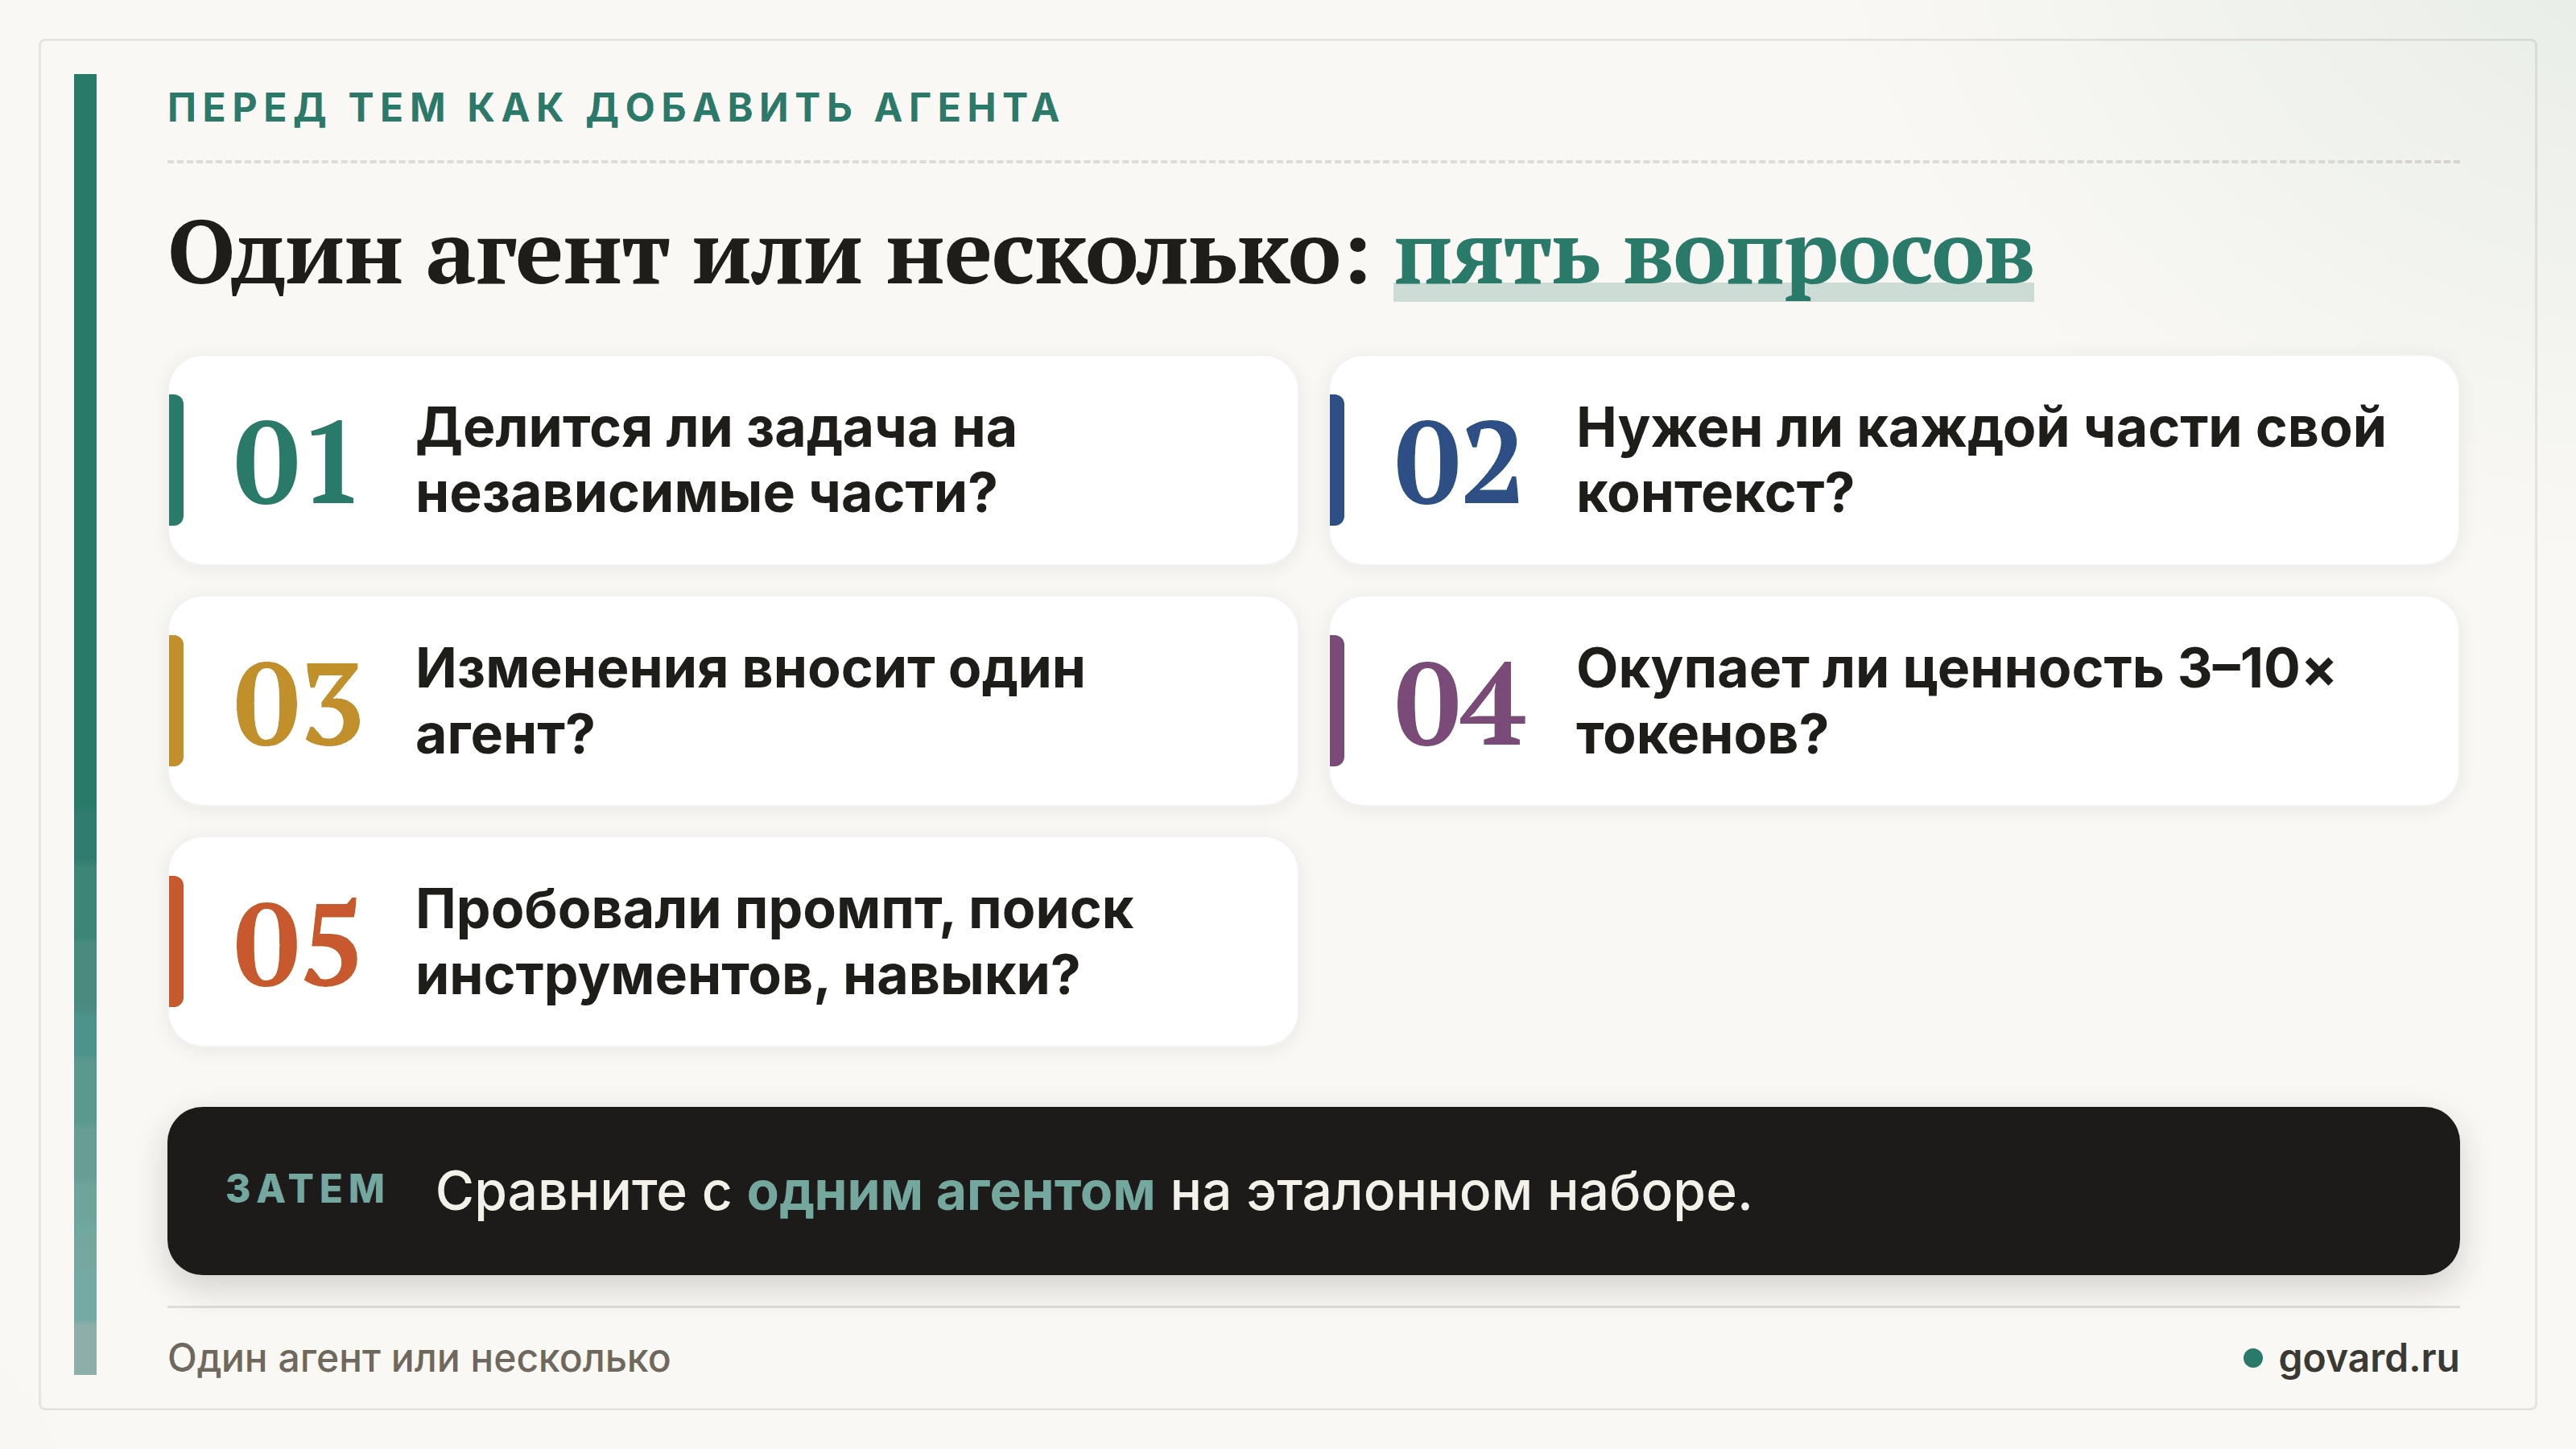
Затем сравните на своих задачах: прогоните один эталонный набор на одном агенте и на мультиагентной версии и запишите расход токенов. Как собрать такой набор и что спросить у подрядчика — в статье о проверке ИИ-агентов.
Сколько агентов работает в вашей системе и какой из них пишет итоговый результат?