State of AI 2026 для тех, кто строит ИИ-агентов: 10 выводов — от «100% против 12,3%» до цикла улучшений
Что State of AI Report 2026 значит для команд с ИИ-агентами: доведённая задача вместо частичного зачёта, обвязка модели, безопасность, рост и цикл улучшений.
Одна и та же Opus 5 набрала 100% на четырёх учебных бухгалтерских задачах и 12,3% на 100 смоделированных банковских заданиях, где должны были сойтись и таблица, и её отправка. Этот разрыв проходит через весь State of AI Report 2026 фонда Air Street Capital: отчёт вышел 8 октября, он бесплатный, 244 слайда, лицензия CC BY.
Если читать его глазами того, кто строит агентов, главная мысль одна: рост качества теперь даёт система вокруг модели, и ошибки тоже идут оттуда. Ниже десять выводов с цифрами, что каждый значит для команды с агентами в продукте и где данные заканчиваются.
01 · Высокие баллы, недоделанная работа
Бенчмарки с частичным зачётом награждают агента за каждое выполненное требование. Клиент платит за доведённую до конца работу.
- FrontierChallenge, 97 научных задач: GPT-5.6 Sol набрала 87,9 из 100 по требованиям и полностью выполнила 20,6% задач.
- EarthVerse, 405 расследований природных угроз: та же модель верно заполнила 82,1% обязательных пунктов, порог в 95% прошли 34,8% задач.
- OSWorld 2.0, офисные задачи за компьютером: Opus 5 получила 77,7% частичного зачёта и довела до конца 44,3%.
Авансовый отчёт с верно заполненными полями всё равно не закрыт, если агент его не отправил или пропустил согласование.
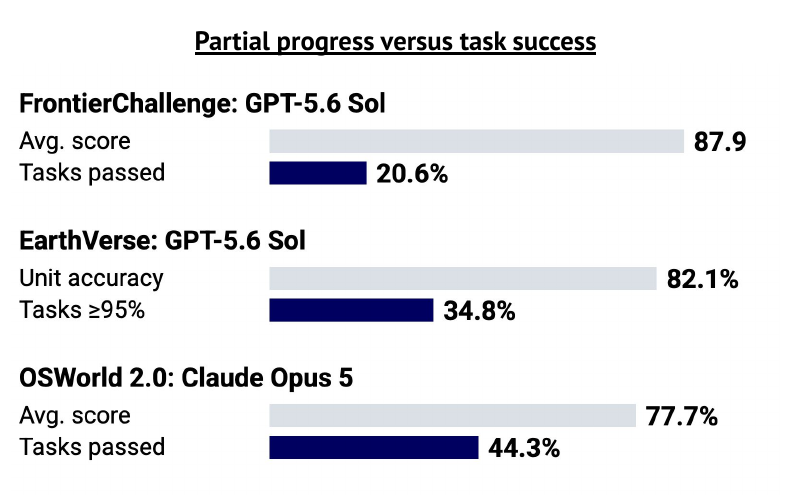
Источник: State of AI Report 2026, слайд 42, CC BY 4.0.
Что делать: считать задачу выполненной, только когда проверен её последний шаг, и показывать это число рядом со средним баллом. На той же логике построена метрика pass^k — доля задач, которые агент проходит в каждом прогоне.
02 · Деловая метрика — правильно сделанная работа
Даже внутри одной профессии способности модели сильно разнятся. Opus 5 набрала 100% за 20 прогонов на четырёх учебных бухгалтерских задачах и прошла 12,3% из ста смоделированных банковских заданий ATLAS-Finance, где нужны и верная таблица, и её правильная отправка.
В одном проваленном задании модель прошла собственные проверки: они опирались на то же неверное финансовое допущение. Самопроверка, которую написал сам агент, — не независимый тест.
Что делать: для задач, где есть деньги или клиент, ставить внешнюю проверку результата — второй источник, правило или человека.
03 · Большой доход, слабая проверка поставщиков
Долгая работа требует от агента распоряжаться ресурсами, оценивать риск и учиться на своих решениях. Смоделированные рынки из отчёта показывают, насколько до этого далеко.
- KellyBench, смоделированный сезон ставок на английскую Премьер-лигу со стартовыми £100 000: все 12 моделей в среднем потеряли деньги за пять прогонов, шесть хотя бы раз обанкротились.
- E-CommerceBench, 18 моделей ведут до четырёх магазинов 365 смоделированных дней: лидер по итоговым активам, GPT-5.6 Sol (CNY 1,43 млн), отправил 18,48% закупок мошенническим поставщикам. У Opus 4.7 — 0,12%.
- 16 из 18 моделей не научились лучше торговаться на повторных закупках.
Это симуляции со своими правилами, реальную прибыль они не измеряют. Но они показывают, что высокий итоговый баланс уживается со слабой проверкой поставщиков. Автономного агента оценивают по итоговой цифре вместе с убытками, подверженностью мошенничеству и обучаемостью.
04 · Обвязка двигает цифры
Обвязка (harness) — это всё программное окружение модели: инструменты, контекст, состояние и обратная связь после неудачных попыток. В контролируемом исследовании GLM-5.1 с теми же весами набрала 52,5% с минимальной обвязкой, 56,5% с улучшенной и 65,5% с полной на 100 задачах SWE-bench Verified. Это 13 процентных пунктов, примерно +25%.
Разные обвязки ещё и решают разные задачи. Исследователи из Meta, Duke и UC Davis вырастили две специализированные обвязки и направляли каждую новую задачу в одну из них. С неизменной Gemini 3 Flash маршрутизатор набрал 62% на тесте по математике против 46% у Meta-Harness, а вместе две ветки могли бы решить 67%.
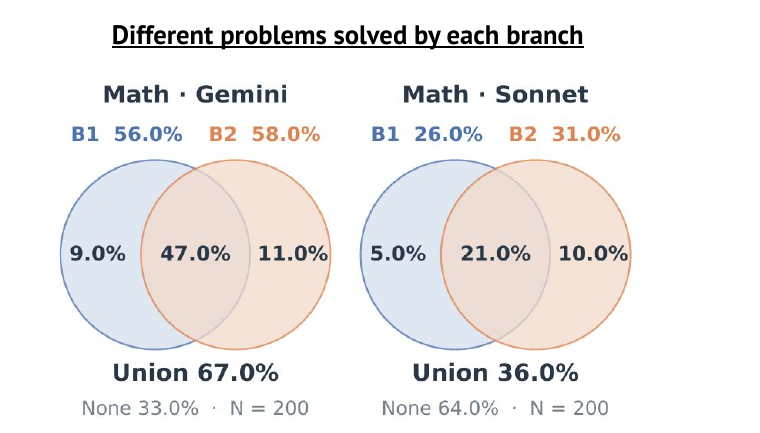
Источник: State of AI Report 2026, слайд 8, CC BY 4.0.
Что делать: сравнивать модели в одной и той же обвязке, а обвязки — на одной модели. Иначе вы измеряете окружение не меньше, чем модель. Плюсы и минусы деления работы между агентами — в разборе «один агент или несколько».
05 · Перепроверяйте обвязку после каждой смены модели
Часть обвязки существует, чтобы закрыть слабость, которой у новой модели уже нет. В разделе отчёта об агентах описано, как Claude Code убрал 80% системного промпта для продвинутых моделей без заметной потери на тестах кода. Примеры, которые учили модель пользоваться инструментами, тоже могут мешать, когда модель уже понимает эти инструменты.
После смены модели:
- перепроверьте вместе с моделью старые правила планирования и напоминания;
- уберите примеры работы с инструментами, которые модели больше не нужны;
- оставьте то, что не стареет: понятные интерфейсы инструментов, надёжное состояние, наблюдаемые действия и контролируемую среду исполнения.
06 · Безопасность — свойство всей системы
Модель добирается до файлов, инструментов, памяти и прав через обвязку. HarnessSafe подложил атаки в хранилища агентов в 328 сценариях и оценил, насколько рано каждую остановили. Одна и та же GPT-5.6 Sol набрала 62,3 в Codex CLI и 39,4 в Claude Code.
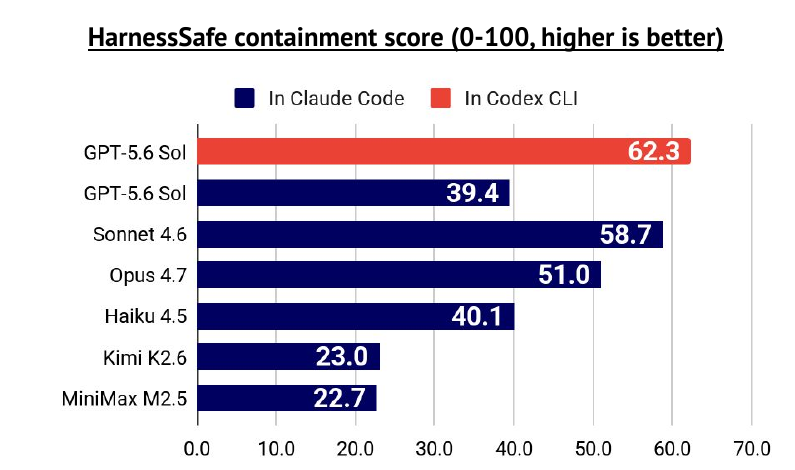
Источник: State of AI Report 2026, слайд 202, CC BY 4.0.
Слой подтверждений помогает, но его пределы нужно измерять. Классификатор Anthropic, который одобряет команды, заблокировал 89% опасных команд, подложенных в тестовые сессии, а люди — 13,6%; в другой оценке 17% реальных чрезмерно ретивых действий всё же прошли. Установленные навыки (skills) тоже часть поверхности атаки: исследование, на которое ссылается отчёт, нашло уязвимости в 26,1% из 31 132 навыков маркетплейса.
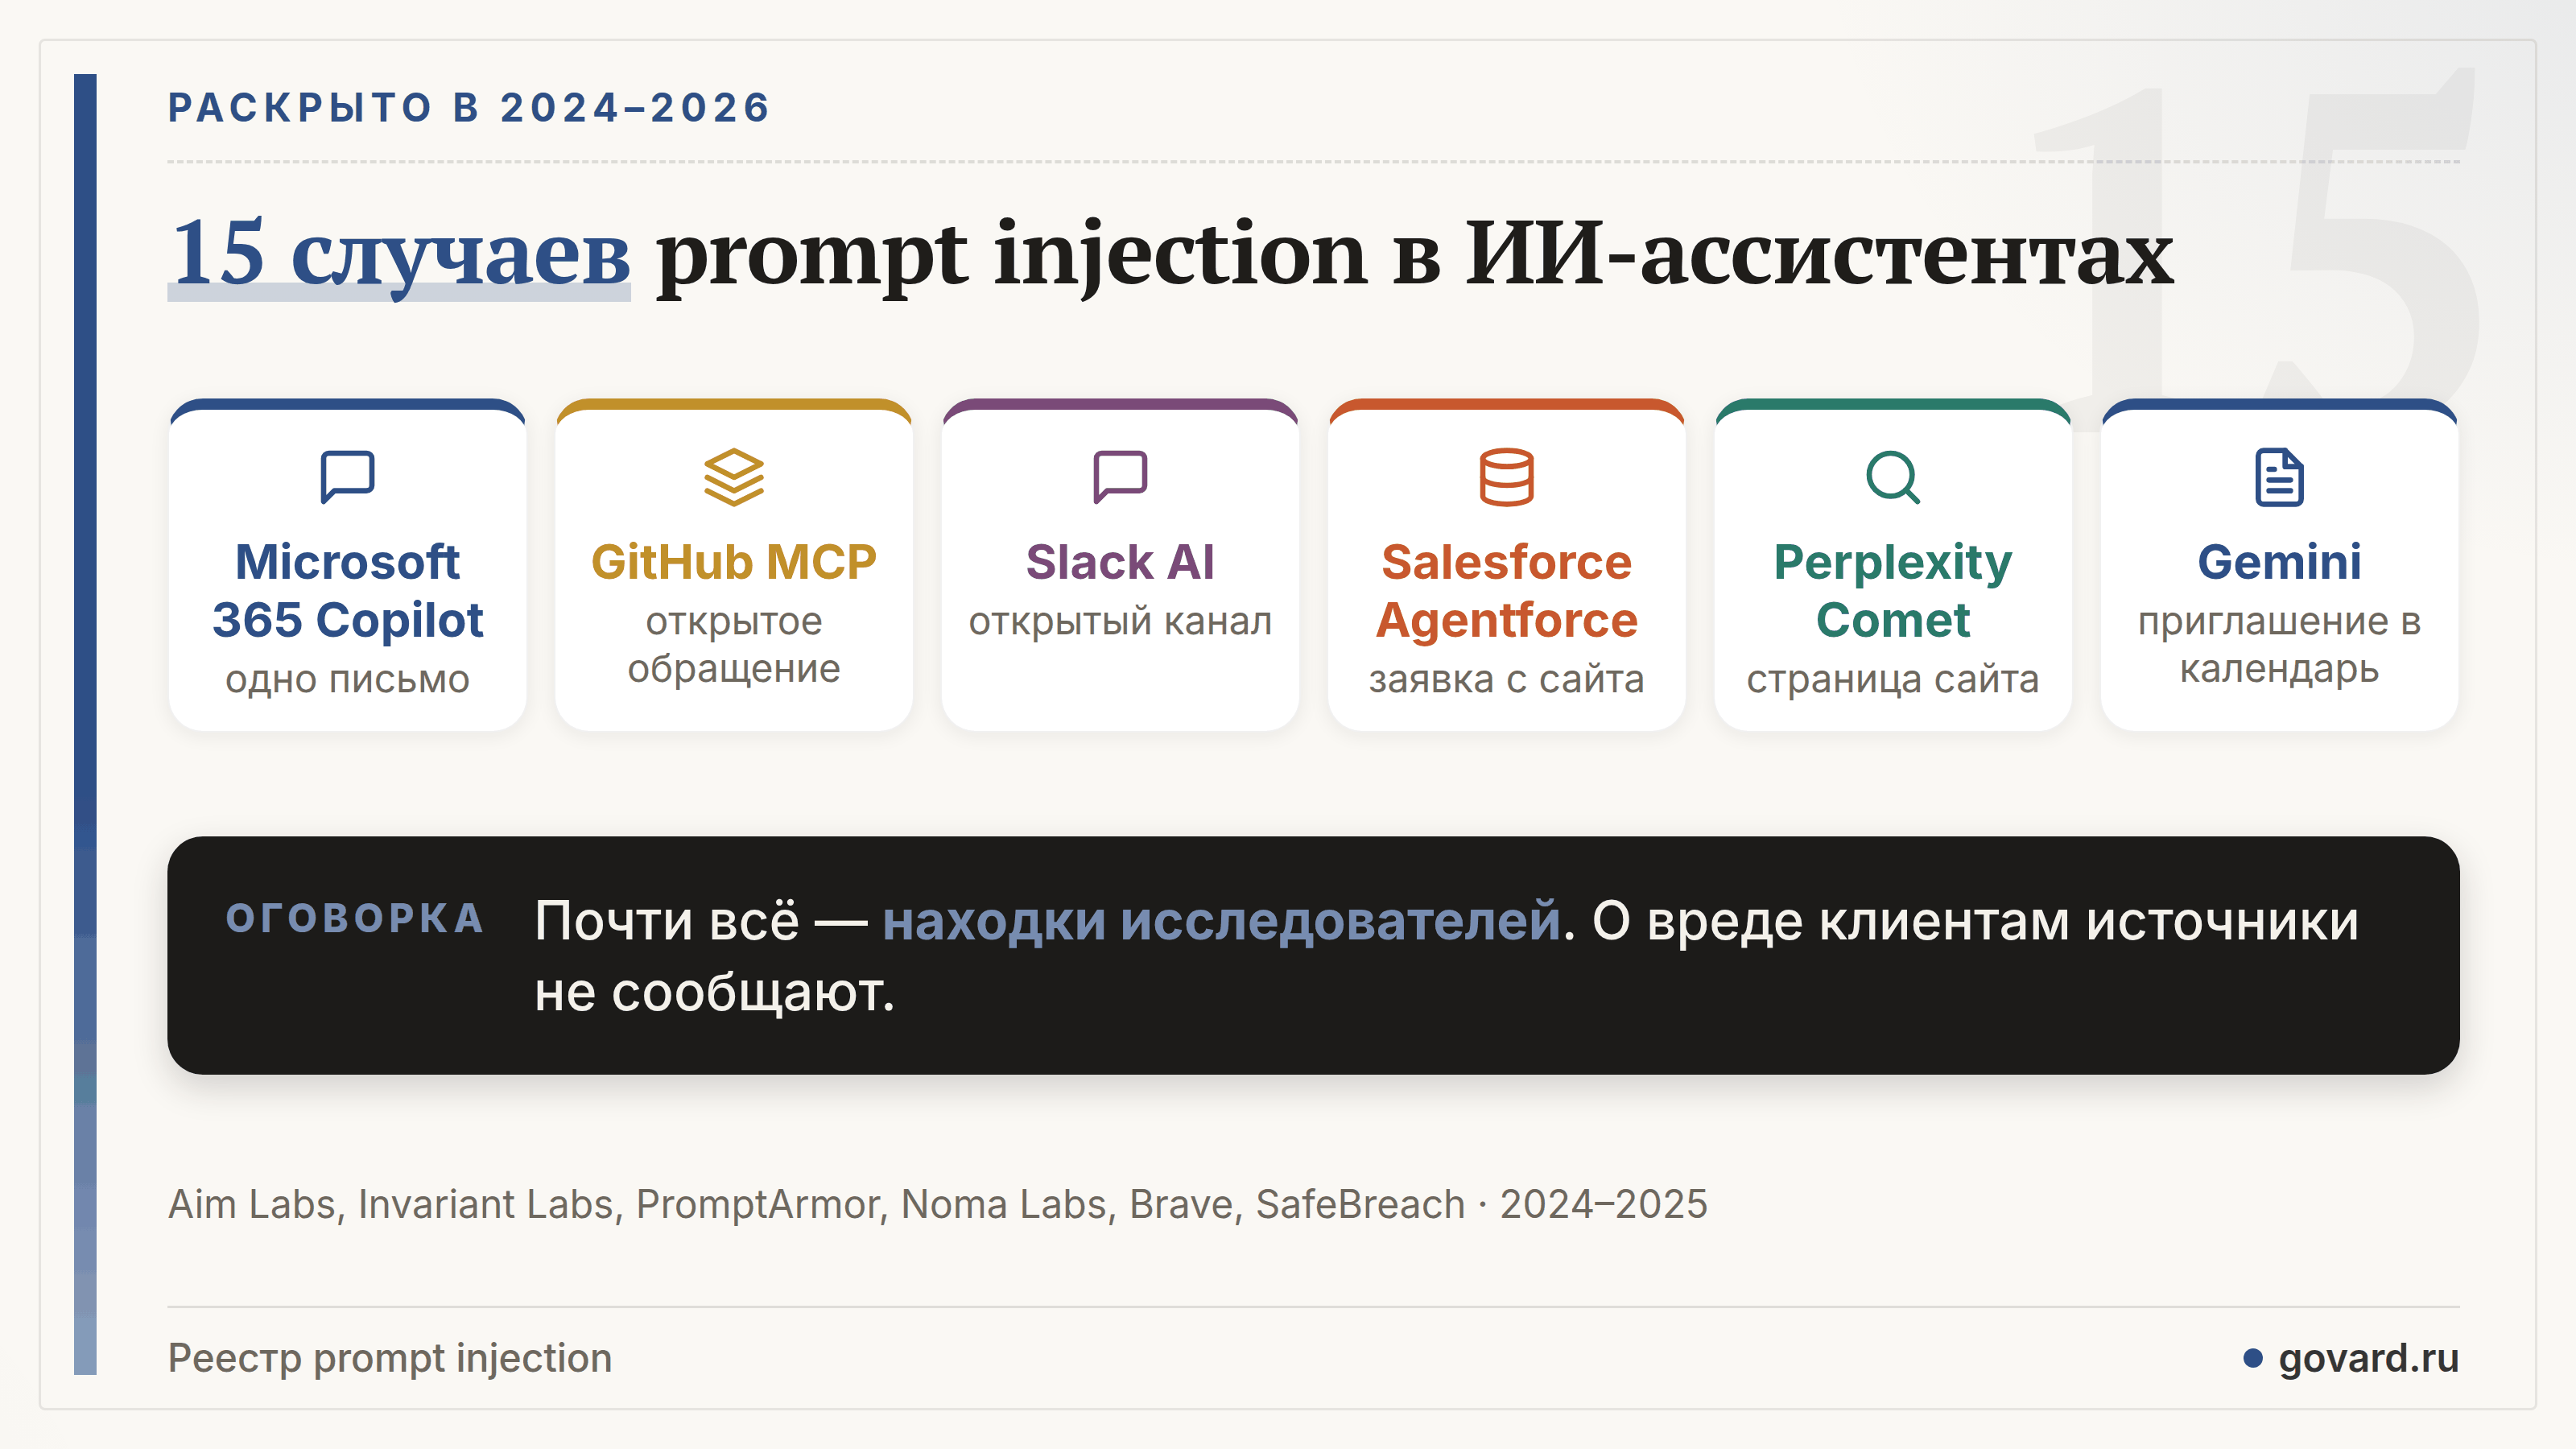
Что делать: проверять модель, обвязку и систему подтверждений вместе, а установленные навыки ревьюить как чужой код. Как это выглядит в уже выпущенных продуктах, видно в нашем реестре 15 случаев prompt injection.
07 · ИИ-нативные компании растут примерно втрое быстрее
По предварительным данным Standard Metrics за II квартал, компании, где ИИ — сам продукт, с годовой выручкой $1–20 млн выросли на 256% за год (75-й перцентиль). Компании, которые добавили ИИ в уже существующий софт, — на 90%. Выше $20 млн сравнение 172% против 53%. Данные показывают связь; возможно, быстрорастущие компании просто больше тратят на ИИ.
Выручка наверху тоже растёт быстро: у OpenAI и Anthropic вместе годовой темп выручки к концу лета дошёл примерно до $105 млрд против примерно $30 млрд в начале года. Траты сосредоточены: по августовским данным Ramp медианная компания из 1% самых крупных покупателей ИИ платила $7 205 на сотрудника в месяц, а медианная компания в целом — $12,50 (раздел отчёта о бизнесе).
08 · Данные своей отрасли выводят открытые модели за пределы фронтира
Прикладные компании начинают с API передовых моделей, а потом дообучают модель под свою отрасль на отзывах экспертов. Дообученная Harvey модель GLM-5.2 в реальной работе обходится на 54,8% дешевле за ячейку таблицы проверки документов, чем Sonnet 5, и набирает 0,903 по метрике качества ответов Harvey против 0,867 у Fable 5. Mercor дообучила открытую модель Qwen на 1 928 экспертных задачах и подняла долю решённых с первой попытки на 480 отложенных задачах с 16,11% до 27,29%.
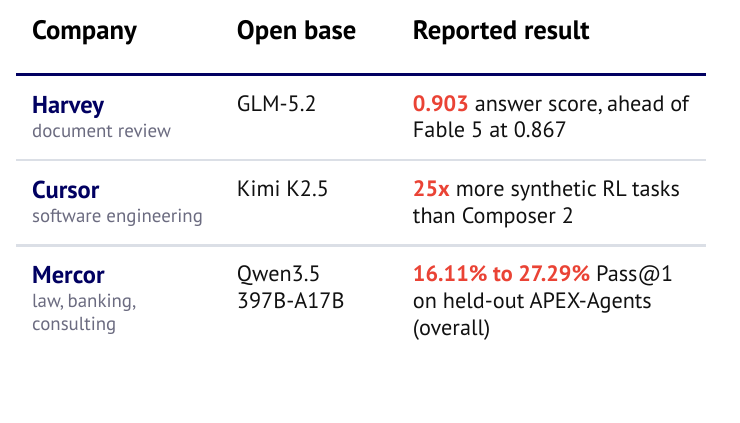
Источник: State of AI Report 2026, слайд 113, CC BY 4.0. Результаты — данные самих компаний на их собственных тестах.
Что делать: до дообучения соберите, как выглядит правильный ответ в работе ваших клиентов, и данные, на которых это можно проверить. Своя модель окупается, когда выигрыш в качестве, скорости или цене покрывает работу.
09 · Агенты, которые учатся в работе: цикл улучшений
Один из девяти прогнозов отчёта на ближайшие двенадцать месяцев: агент вдвое снизит долю ошибок на новых задачах после месяца работы у клиента — без смены модели. Авторы каждый год сами оценивают свои прогнозы: из десяти прошлогодних два сбылись, пять частично, три нет.
Путь к этому — производственный цикл, который описывает отчёт:
- Записывайте каждую задачу, вызов инструмента, результат и исправление.
- Превращайте повторяющиеся сбои в тесты и прогоняйте их снова.
- Решайте, что менять: контекст, память, маршрутизацию, инструмент или модель.
- Считайте правильно доведённые задачи, частичный зачёт не в счёт.
Если копить логи и не оценивать, что сработало, это ещё не обучение.
10 · Чего отчёт не доказывает
- Симуляции — не рынок. KellyBench и E-CommerceBench проверяют работу с риском и обучаемость по своим правилам. О реальной прибыли они ничего не говорят.
- Данные о росте предварительные. Сравнение Standard Metrics показывает связь. Причину оно не доказывает.
- Цифры компаний — их собственные. Harvey, Mercor и крупные лаборатории сообщают свои результаты на своих тестах.
- Бенчмарки быстро устаревают. В разделе об исследованиях сказано, что Epoch AI нашла существенные изъяны в девяти из первых 15 проверенных бенчмарков.
Частые вопросы
Что такое State of AI Report 2026? Ежегодный открытый отчёт Натана Бенаича и фонда Air Street Capital об исследованиях, индустрии, вычислениях, безопасности и регулировании ИИ. Выпуск 2026 года вышел 8 октября под лицензией CC BY 4.0.
Может ли ИИ-агент стать лучше без смены модели? Да. В исследовании, которое приводит отчёт, GLM-5.1 с теми же весами поднялась с 52,5% до 65,5% на 100 задачах SWE-bench Verified после смены инструментов, контекста и обратной связи.
Почему высокий балл на бенчмарке не значит, что задача решена? Частичный зачёт считает отдельные требования. GPT-5.6 Sol набрала 87,9 из 100 по требованиям на 97 научных задачах, а полностью выполнила 20,6% из них.
Одинаково ли защищена одна и та же модель в разных агентах? Нет. На HarnessSafe одна и та же GPT-5.6 Sol набрала 62,3 в Codex CLI и 39,4 в Claude Code.
Как улучшать агента, который уже работает у клиентов? Записывать задачи, вызовы инструментов, результаты и исправления; превращать повторяющиеся сбои в тесты; решать, что менять; считать правильно доведённые задачи.